生命科学数据与生物技术

生命科学中的数据可以是显微图像、体征读数、问卷回答、序列信息、样本中的分子信号,也可以是多年随访得到的变化记录。无论形式如何,数据都不是自然界的完整复制:研究者选择测量什么、用什么仪器、在谁身上测、何时测量,都会影响结果可以回答的问题。
本内容不要求掌握复杂算法或实验操作,却应能从“图表上的差异”走到“这个差异能支持什么主张”。生物技术扩展了读取、比较和在特定条件下干预生物信息的能力,但技术能力本身不等于自动得到可靠结论。本章练习的是:先审查测量,再比较结果,最后让语言强度与证据强度相匹配。
学习目标
- 用对象、指标、比较和不确定性四个问题审阅生命科学数据。
- 区分相关、预测与因果三种不同层级的说法。
- 说明生物技术的能力、现有证据与社会条件应分开讨论。
- 理解数据隐私与知情同意是技术应用不可省略的设计条件。
先审查测量,再比较结果
读一组数据时,可以依次检查四件事:
- 对象:样本来自谁或什么系统,是否能代表所讨论的人群或条件?
- 指标:测到的是直接关心的功能,还是一个间接信号?
- 比较:有没有合适的对照、基线或重复观察?
- 不确定性:测量误差、样本差异、缺失记录和随机波动如何处理?
这些问题不是为了否定数据,而是为了给结论画出适用范围。样本量较小、记录不完整或指标间接时,结论可能仍有价值,只是表达应更谨慎。把读数、变量和调节过程分开,也是避免从一张“很清楚”的图表直接跳到强结论的习惯。
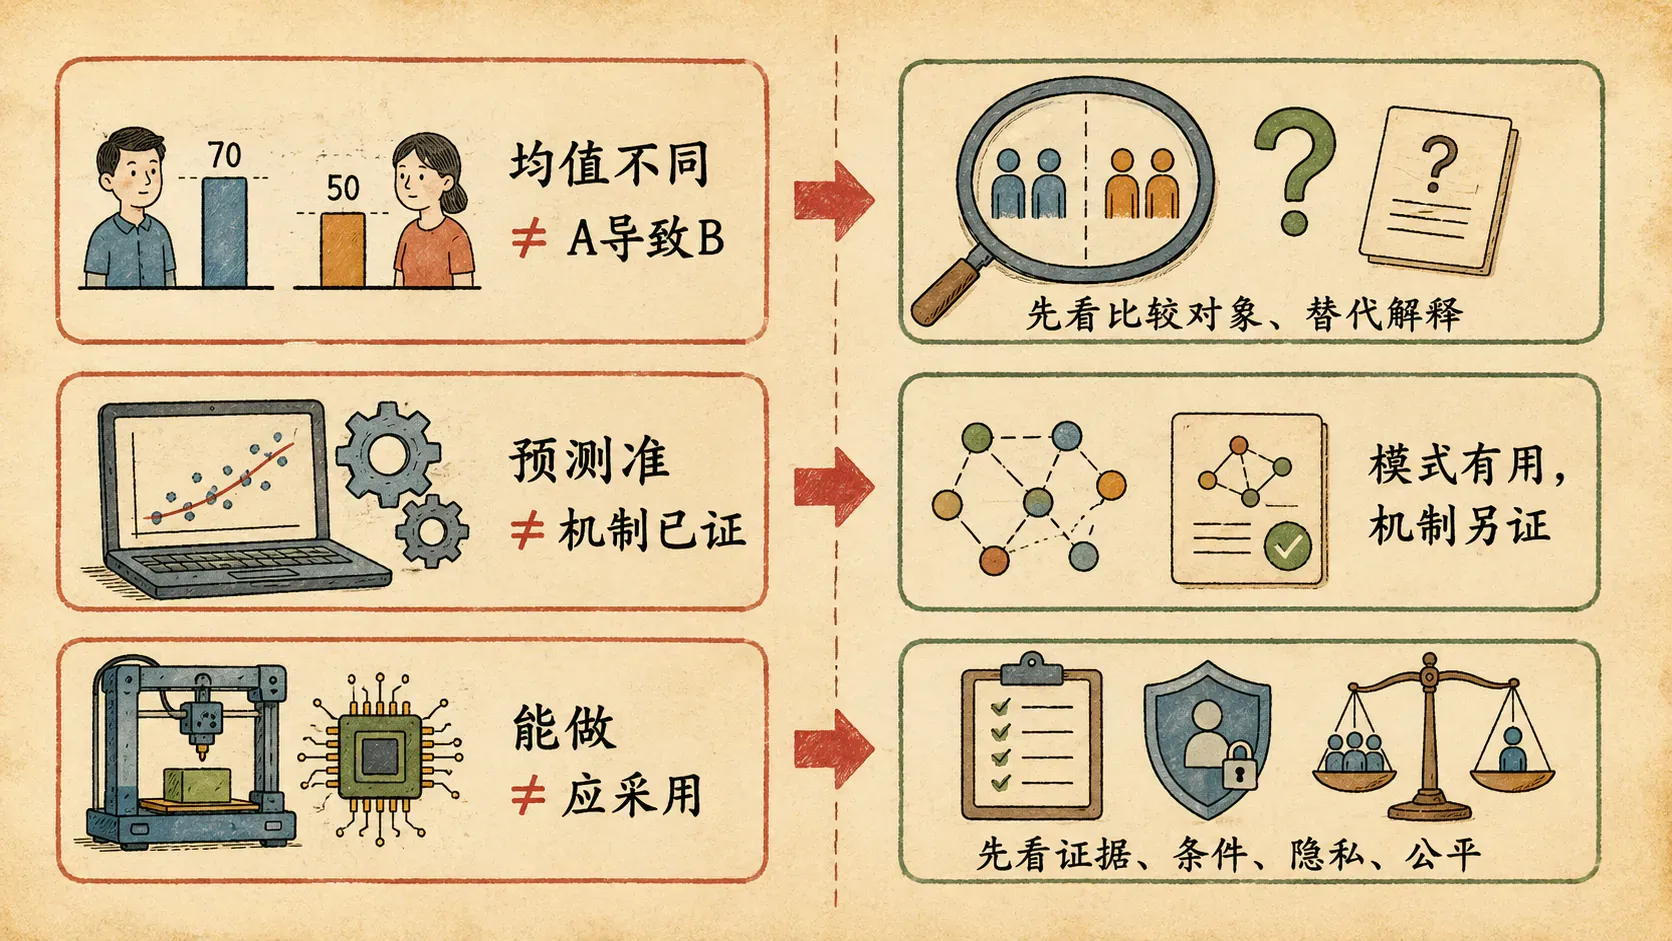
相关、预测与因果是不同层级的说法
两个指标同时变化,可以形成相关性;利用多个指标估计某种结果的可能性,属于预测;要说明“改变 A 导致 B 改变”,则需要更强的因果证据和替代解释的排除。三者都能服务现实问题,但不能互换。
例如,一个模型能对某个群体作出较好的预测,并不自动说明它已找到了生物学机制;一项关联研究发现生活条件与某结果有关,也不等于单独改变其中一项就必然改变结果。看到“发现原因”的标题时,应先找研究是否具备支持因果推断的设计。相关性可以提出值得研究的问题,但通常不能单独排除第三种条件、反向关系或记录偏差。
生物技术的能力、用途与限制
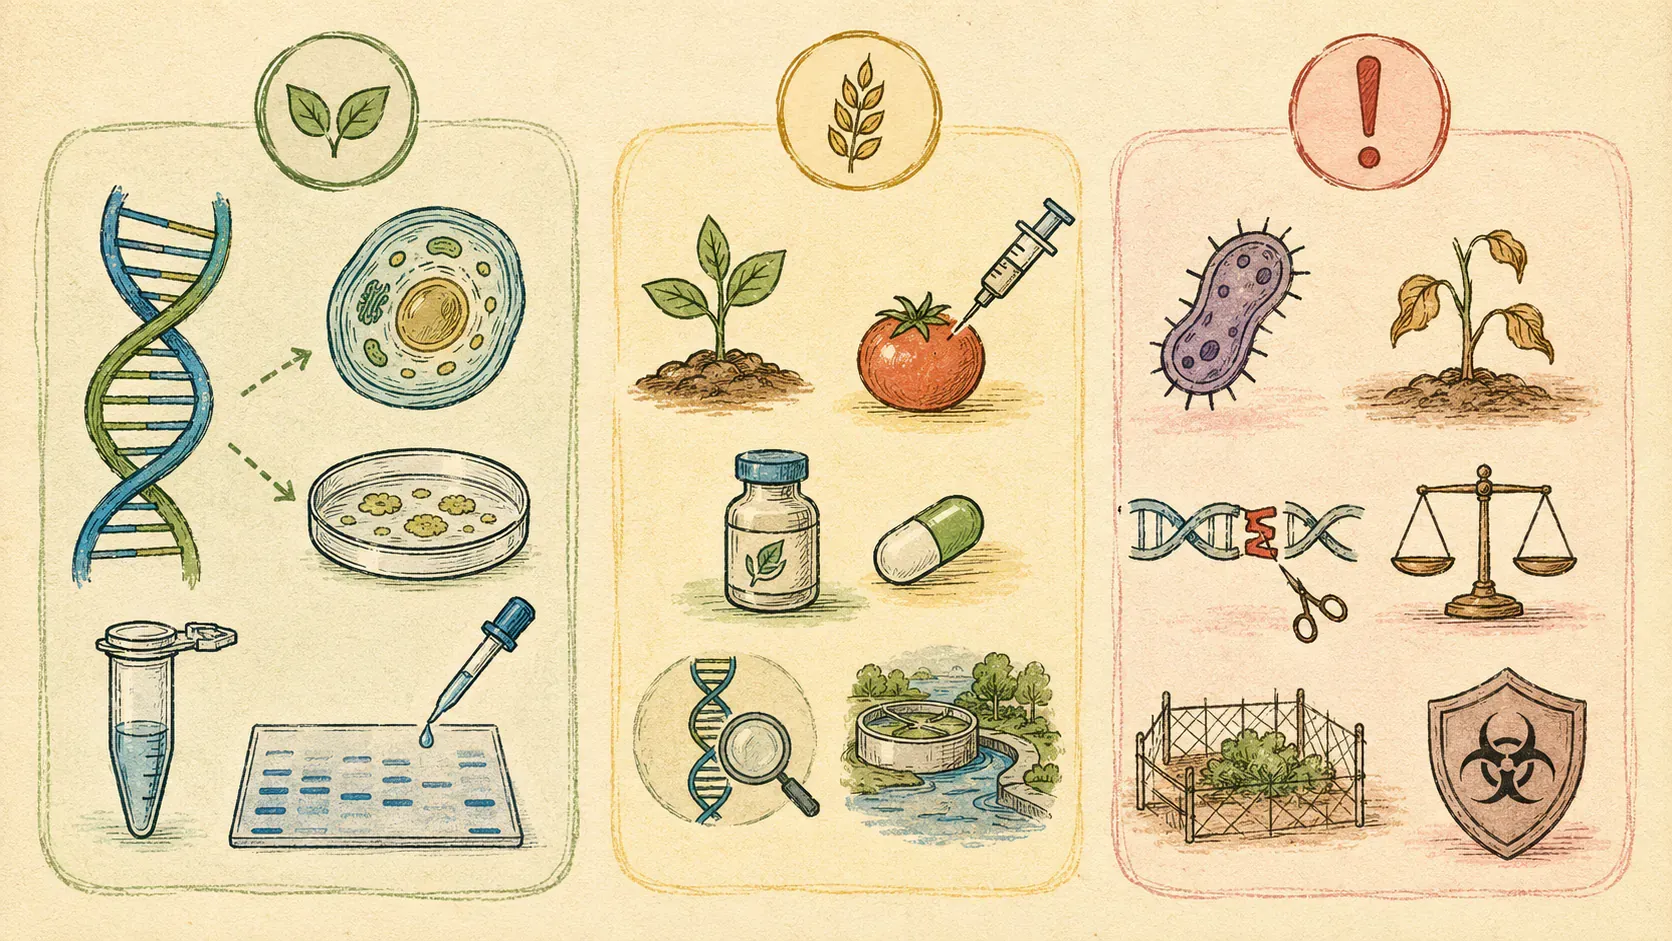
现代生命科学技术能够帮助人们读取、比较或在特定条件下改变生物信息。不同技术所能提供的证据类型不同:有的用于观察,有的用于检验差异,有的用于建立模型或改进生产过程。技术本身并不自动保证结论正确,仍需验证测量可靠性、比较条件、重复性和实际效果。
对于基因检测、辅助生殖、作物育种、细胞治疗等社会议题,通识学习应将讨论划分为以下三个层面:
- 技术能力:技术在技术上能做什么?
- 证据状况:现有证据表明它在什么条件下有效或有限?
- 社会采纳:社会是否应当采用,还需考虑以下因素:
- 公平
- 隐私
- 知情同意
- 资源分配
- 长期影响
评价一项技术时,除了关注“准确率多高”,还应关注:
- 错误的结果会伤害谁?
- 谁能获得收益?
- 谁有权决定数据如何使用?
三类技术窗口
在学习中,可以用三类代表性技术认识“技术能力—证据—社会条件”这条主线。它们不是操作说明,而是帮助我们辨认一项技术究竟测到了什么、改变了什么,以及哪些结论还需要额外验证。
例如,测到两个样本的 DNA 序列不同,首先支持的是信息层面的差异;若要推断某项性状或功能,还需连接细胞活动、发育环境和可重复的功能记录。又如,某项技术能够在特定系统中实现目标改变,并不自动回答它在不同对象、长期条件下的效果与风险。技术讨论要同时保留“能否做到”“证据支持到哪里”和“是否应当采用”这三个问题,不能让其中任意一个替代另外两个。
不把课程概念变成操作方案。 本章只讨论技术的证据类型与社会边界,不提供基因编辑、样本检测、培养或医疗应用的操作步骤,也不据此建议个人作出健康或消费决定。
数据治理也是生命科学的一部分
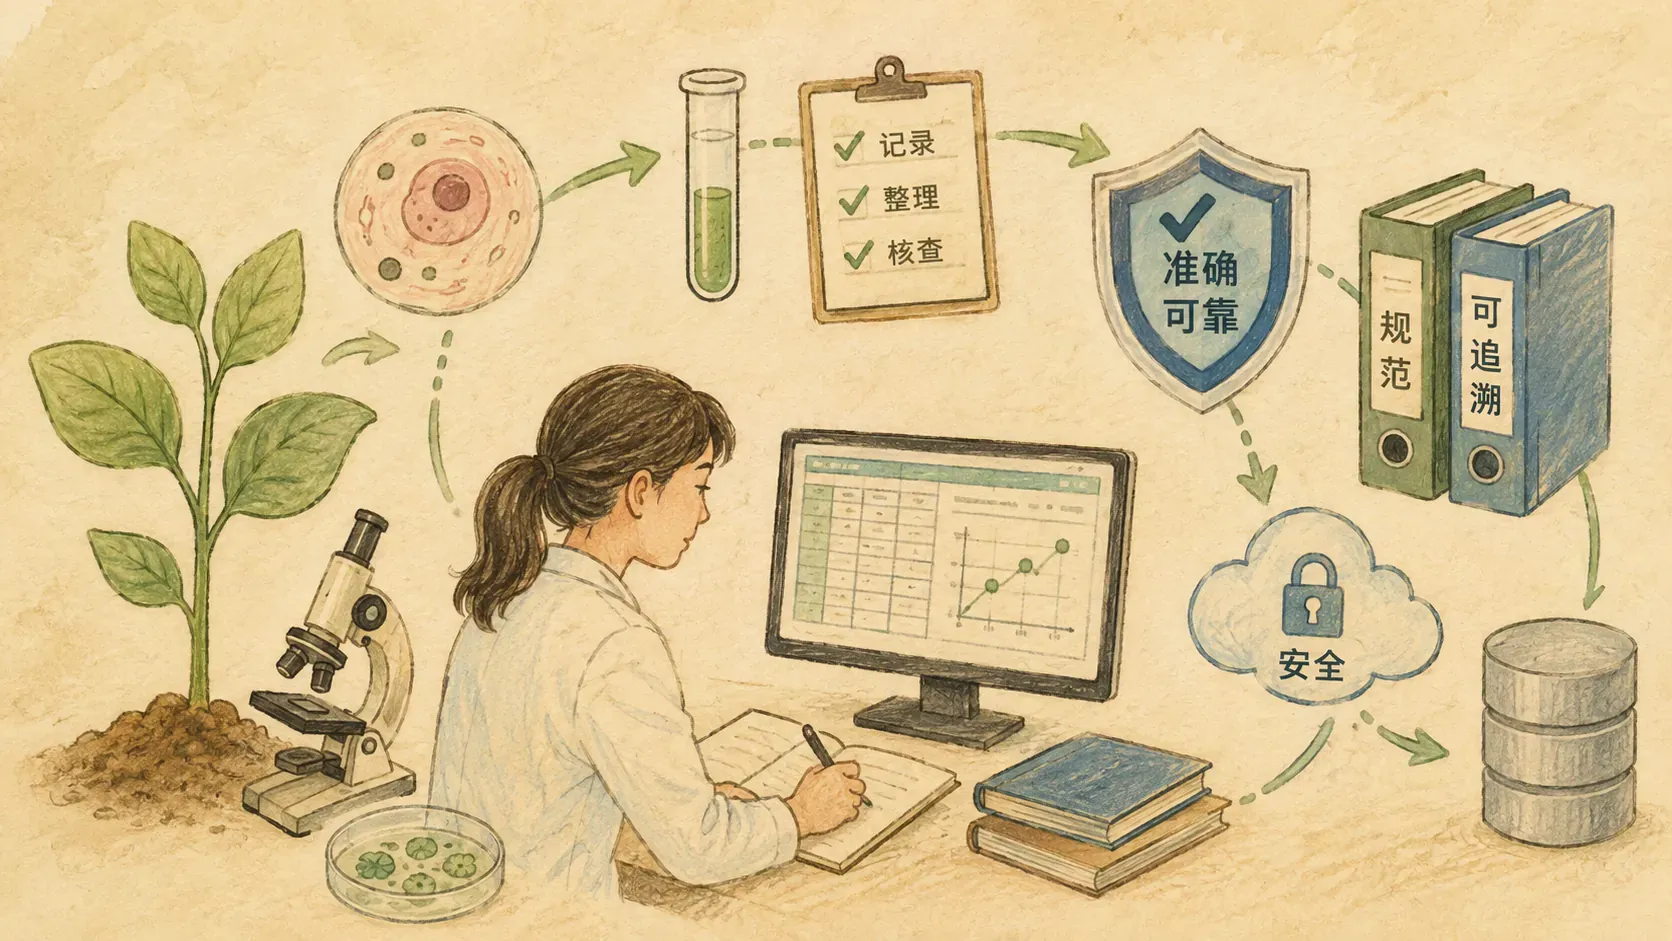
生物样本和健康相关数据往往包含高度敏感的个人与家庭信息。采集与使用时,需要明确目的、最小必要范围、保存与访问方式、撤回或退出的可能性,以及结果如何被解释和反馈。公开数据、商业宣传或算法评分不能因此失去对人的尊重。
一张图表通常比原始记录更易阅读,但它背后也包含许多选择:
可追溯性要求任何结论都能从“主张”追溯到“图表或结果”—“指标”—“对象与方法”,直到原始记录来源。若结论只剩下醒目的标题而缺乏对象、比较、限制和出处信息,便难以被独立审查,也不适合用于强烈的因果或价值判断。
例题:预测效果不等于证明机制
题干:一个数据模型能较好地区分两组记录,能否写“模型已经发现造成两组差异的生物学机制”?
解析:不能。模型的区分效果说明它可能抓到了有用的记录模式;这属于预测层面的信息。机制解释还要回答所用指标与过程如何关联,并排除替代解释。应把“可用于某类记录的预测”与“已证明因果机制”分开表达。
自测练习
练习: 为什么“两个指标相关”不等于“其中一个导致另一个”?
练习: 某研究只测量了一种容易获得的分子信号。写出它在解释功能变化前还要确认的一点。
练习: 为什么说数据隐私不只是“把姓名删掉”这么简单?
小结
科学数据的解读离不开其产生的对象、选择的指标、所用的工具和具体的记录方式,同样的数据在不同条件下可能有不同含义,因此不能脱离这些背景直接下结论。特别是在生命科学领域,相关性、预测和因果推断三者所需的证据等级存在明显差异,我们在表述时要根据证据的强弱调整措辞,不能混淆其逻辑强度。
此外,生物技术的评价不仅要关注“能否实现”,还必须考虑数据的质量、证据的解释范围和相应的社会条件,例如伦理、隐私和实际应用边界。主动带着对测量方法的审查意识和对可追溯性的追问,去解读生命科学中的图表和结论,有助于既避免把数据结果简单神秘化,也能防止将有限的记载夸大为不容置疑的因果推断。