实验数据处理与不确定度
同一瓶待测溶液,三位同学各做三次滴定,为什么会得到九个并不完全相同的体积?更让人犯嘀咕的是:既然数字不一样,实验报告里为什么还要郑重地写出一个结果,甚至还要在后面跟上一个“±”?
你可能会这样想:“把九个数平均一下不就行了吗?”平均值当然很重要,但它不是数据处理的万能橡皮。它无法自动消除滴定管零点偏差,无法把抄错的小数点变成正常波动,也无法替你决定该保留几位小数。可靠的结果不是“算出来的一个数”,而是一条能回到原始记录、能说清可信程度的证据链。
本章只处理这条链上最基础也最容易混淆的部分:原始数据怎样留下证据,有效数字怎样服从仪器,重复测量怎样描述随机波动,准确度和精密度为什么不是一回事,以及怎样用不确定度把结果说完整。它是滴定、分光光度、pH 和电化学测定等所有后续实验的共同底座。
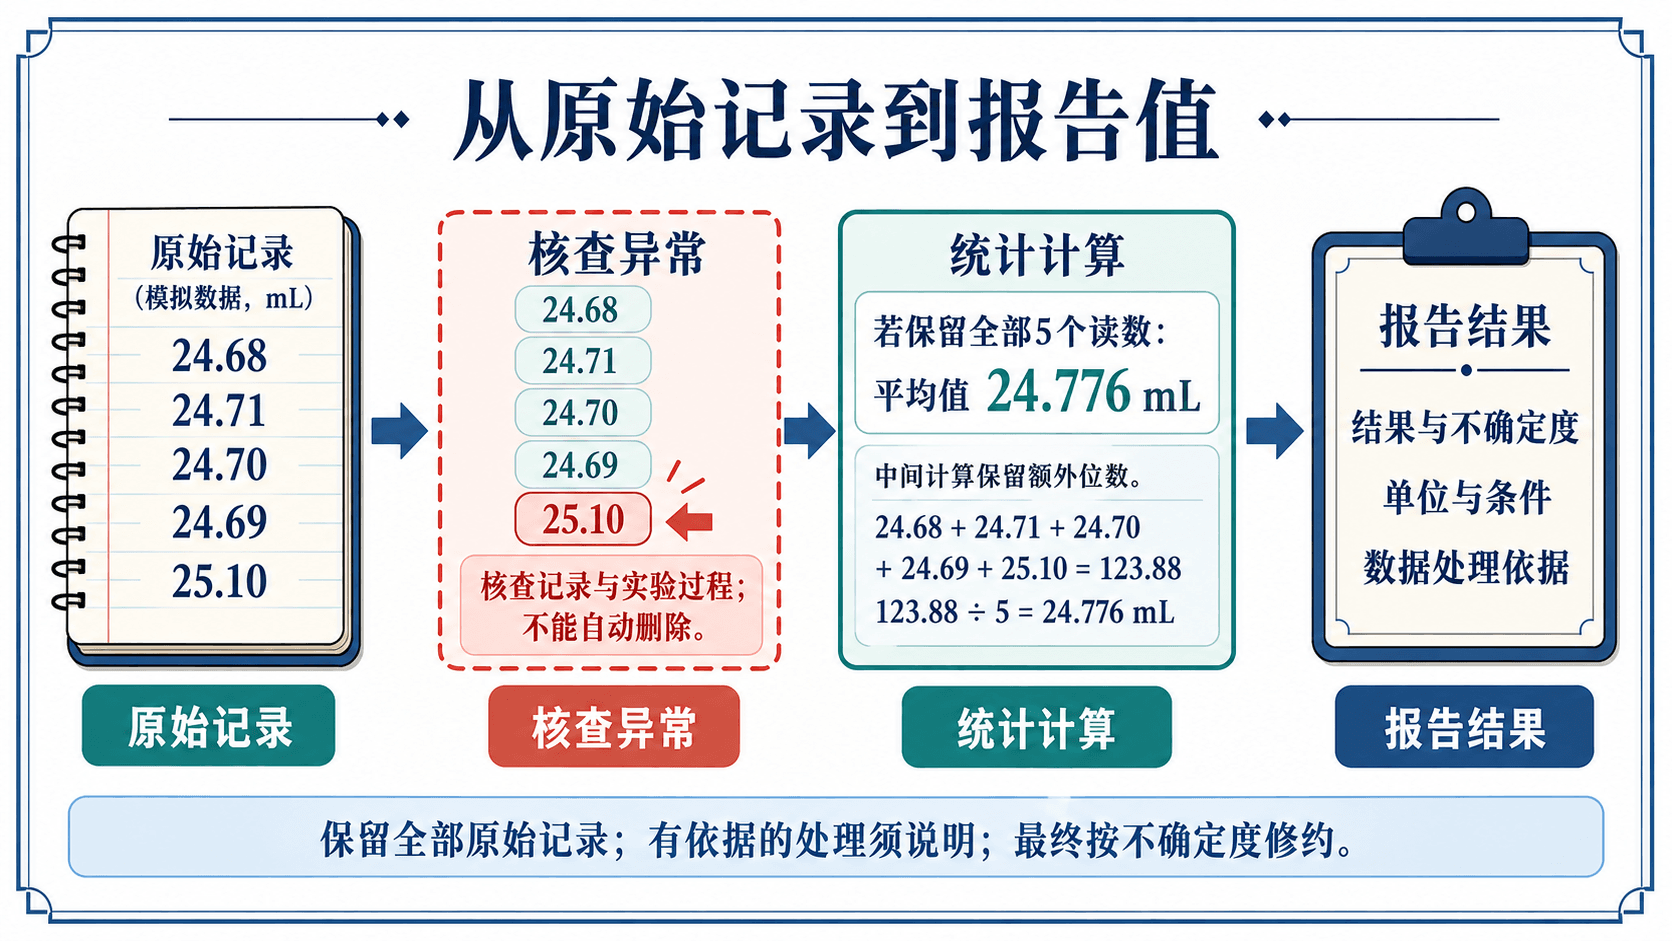
数据处理的目标不是把结果“修”得更好看,而是让每一个结论都配得上原始观测的质量。先忠实记录,再按明确规则计算,最后如实说明不确定度;顺序不能倒过来。
数字为什么不能只挑“顺眼的”:原始记录是证据,不是草稿
想象你刚完成三次酸碱滴定,消耗体积依次是 20.16 mL、20.18 mL、20.17 mL。这时同组同学说:“中间那个比较大,写两个更整齐。”先别急着点头。那一位 20.18 mL 到底是正常的读数波动,还是滴定终点过量、视线没平视、气泡突然排出,甚至只是抄错?只看数字本身,我们不知道。
所以实验记录的第一条原则很朴素:在观察当时如实、完整、可追溯地记录。读数、单位、仪器编号或量程、温度、样品批次、异常现象和操作条件,都是后来判断数据能不能比较的线索。重复读数即使恰好相同,也要逐个写下;“反正一样”而漏写一个,会让测量次数和统计量都失去依据。
原始本里算错或写错怎么办?不是把旧数擦得无影无踪,而是按实验室规则保留可辨认的原记录,标明更正后的值和原因。这样做不是形式主义。假如报告里的浓度突然偏高,教师和你自己都需要能沿着“结果 → 计算 → 体积/质量读数 → 当时现象”往回找;一张被擦得干干净净的表格,恰好把最需要的信息擦掉了。
先分清三类“看起来不对”的情况
“数据有误差”这句话常常把三件不同的事混在一起。把它们拆开,你才知道下一步该做什么。
- 随机波动来自许多微小且方向不固定的影响,例如终点颜色判断、估读、环境微小变化。重复测量会围绕某个中心散开,不能指望每次完全一样。
- 系统性偏差会让结果持续偏向一侧,例如容量仪器校准有偏差、试剂浓度发生变化、方法终点与化学计量点存在稳定差别。多做几次可能让数据更集中,却不保证更接近参考值。
- 明显失误或异常操作例如抄错小数点、漏洗移液管、液面读错位置、样品被洒出。这不是“随机误差大一点”,而是需要追查记录、检查操作并按实验规程决定是否重测或作出说明的事件。
注意,这是个陷阱——“离平均值远”不是删数的理由。你可以先核对原始记录、仪器状态和当时现象;若课程或实验规程规定使用可疑值检验,才在满足条件时按指定方法处理并保留过程。既不能为了让相对标准偏差好看而挑数,也不能把一次已经确认的误读悄悄混进统计量里。
小问题:一组数据全都很接近,就一定可靠吗?
不一定。假设滴定管每次都因校准问题多读了 0.05 mL,那么三次体积可以非常接近,平均值也很稳定,却仍整体偏大。接近只告诉你“彼此像不像”,不自动告诉你“离参考值近不近”。这个停顿很关键:接下来我们会用精密度描述前者,用准确度讨论后者。
试着切换交互里的几种情景,再用一句完整的话说出判断:不是“这组好”或“那组坏”,而是“这组重复性较好/较差”“这组相对参考值可能有偏差”。这种把结论限定在证据范围内的习惯,正是数据处理的第一项本领。
有效数字不是装饰:仪器允许你说到哪一位
为什么滴定管读数写成 20.16 mL,而不是 20.16000 mL?因为多出来的零看似更精确,实际上是在假装仪器给过你并没有给过的信息。反过来,如果一台可读到 0.01 mL 的滴定管只写 20.2 mL,又把已经观察到的那一位丢掉了。
有效数字记录的是数值中真正有测量意义的位数。对直接读数来说,最后一位通常是按仪器分度作出的估读位;应按本实验所用仪器、讲义和教师要求记录,不凭“多写几位显得专业”决定。以常用滴定管为例,最小刻度常为 0.1 mL,读数通常估读到 0.01 mL;但具体仪器的说明、校准状态和课程要求优先。
你可以先用下面几条把“零”看清楚:
- 非零数字都算有效数字;夹在非零数字中间的零也算,例如
1.005有四位有效数字。 - 小数点左侧的前导零只是占位,例如
0.00420有三位有效数字,而末尾的0表示已经测到那一位。 - 没有小数点的末尾零可能含糊。需要明确精度时,写成科学记数法更清楚,例如
1.20 × 10^3明确有三位有效数字。 - 计数得到的“12 个锥形瓶”以及定义准确的换算因子是准确数,不应像仪器读数那样凭空限制有效数字;但它们参与计算后,最终结果仍受测量量限制。
运算时,别过早把信息剪掉
加减法主要受小数位数最少的测量量限制,乘除法主要受有效数字最少的测量量限制。可是在中间每一步都立刻舍入,会把舍入误差一层层带进最后结果。更稳妥的做法是:计算过程中保留必要的保护位,最后一步再按规则修约;若结果还要报告不确定度,则先确定不确定度的位数,再让结果值修约到同一小数位。
例如,滴定计算得到 c = 0.10246 mol·L⁻¹,而扩展不确定度为 0.0008 mol·L⁻¹。不确定度可保留一位有效数字写作 0.0008 mol·L⁻¹,结果值就应对齐到万分位,写作 c = (0.1025 ± 0.0008) mol·L⁻¹。如果不确定度第一位是 1 或 2,为避免过度粗糙,常保留两位有效数字;具体报告格式仍以课程或方法规定为准。
有效数字不能代替不确定度。写很多位小数不会让仪器更准,删掉小数也不会让结果更可信;它只是在如实表达已经获得的信息精度。
你可能会问:“既然最后总要舍入,为什么还要在中间保留保护位?”因为中间位虽然不一定能单独报告,却会影响最后一位如何进位。先保留、后统一修约,是防止自己在计算中人为放大损失的办法。
靶心上的四种落点:准确度与精密度到底在问什么
把测量想成向靶心投点,很容易建立直觉:点群中心离靶心近,表示结果与参考值接近;点彼此挤得紧,表示重复结果彼此接近。类比到这里就收住,严谨地说:
- 准确度描述测量结果与参考值或约定真值的一致程度。真实值在许多实验中不可直接得到,因此常借助有溯源性的标准物质、校准值或方法规定的参考值来评价。
- 精密度描述在规定条件下重复测量结果彼此接近的程度,常由偏差、标准偏差或相对标准偏差来表示。
因此会有四种组合:又准又精、精而不准、准而不精、既不准也不精。“准确但不精密”并不矛盾:一小组测量的平均值可能碰巧接近参考值,但单次结果散得很开;“精密但不准确”也不矛盾:稳定的系统性偏差会让点群紧紧地落在靶心旁边。
重复测量到底算什么
设同一条件下有 n 个独立重复结果 x₁, x₂, …, xₙ,其算术平均值是:
x̄ = (x₁ + x₂ + … + xₙ) / n
每个结果相对平均值的偏差为 dᵢ = xᵢ − x̄。如果偏差有正有负,把它们直接相加会相互抵消,所以用样本标准偏差来描述离散程度:
s = √[Σ(xᵢ − x̄)² / (n − 1)]
这里分母为什么是 n − 1,而不是 n?因为平均值 x̄ 已由这 n 个数据算出,偏差的和被限制为零,独立变化的自由度少了一个。你不必在基础实验里把统计推导背成口令,但要记住:对有限次重复测量,报告样本标准偏差时应使用这个形式。
当不同实验的量级差很多时,常用相对标准偏差比较重复性:
RSD = s / x̄ × 100%
注意,s、RSD 都在说这组数据散不散,而不是替你证明它们没有系统性偏差。增加重复次数通常能使平均值对随机波动更稳定;若重复结果近似独立,平均值的 A 类标准不确定度为 u_A(x̄) = s / √n。可是同一支未校准的滴定管带来的共同偏差,并不会因为多做几次就被 √n 除掉。
例题:四次滴定,怎样把“差不多”说成数据
某学生用同一支滴定管完成四次平行滴定,消耗体积为 20.16 mL、20.18 mL、20.17 mL、20.19 mL。先不急着宣称“数据很好”,请计算平均值和样本标准偏差。
先求平均值:x̄ = (20.16 + 20.18 + 20.17 + 20.19) / 4 = 20.175 mL。中间先保留到三位小数,暂不抢着把它写成最终报告值。
相对平均值的偏差依次为 −0.015 mL、+0.005 mL、−0.005 mL、+0.015 mL。它们相加为零不是“没有误差”,而是平均值的定义带来的结果。
偏差平方和为 0.00050 mL²,因此 s = √(0.00050 / 3) = 0.0129 mL。这说明四次结果围绕平均值存在约百分之一毫升量级的随机离散。
这里最容易错在哪?有人会把 20.175 mL 立刻写成 20.18 mL,再用被舍入的均值计算后续量;也有人会说“最大差只有 0.03 mL,所以误差就是 ±0.03 mL”。前者过早丢失计算信息,后者把极差和不确定度混成一件事。极差能帮助你快速看波动,但它不是标准不确定度,也不是自动适用的报告区间。
误差和不确定度:一个问偏了多少,一个问可信范围有多宽
这里最容易卡壳。实验课常说“误差分析”,为什么现在又说“不确定度”,难道只是换一个更复杂的名字?不是。
如果参考值 x_ref 已知,测量误差可写作 E = x − x_ref。它有方向:结果偏高是正,偏低是负。但在多数真实测量中,待测对象的真值并不知道;既然真值未知,误差也就不能被你精确算出来。我们能做的是识别影响来源、用已有数据和仪器信息评估结果可能的离散程度,这就是测量不确定度要表达的内容。
所以,不确定度不是“我做错了多少”的罚单,也不是把真实值必定关在某个盒子里的魔法边界。它是与测量结果关联的、表征可合理赋予被测量值分散性的参数。报告不确定度,意味着你把结果的证据强度一并交代出来,而不是假装实验给出了无限精确的答案。
A 类和 B 类,按评定路线分,不按“谁更高级”分
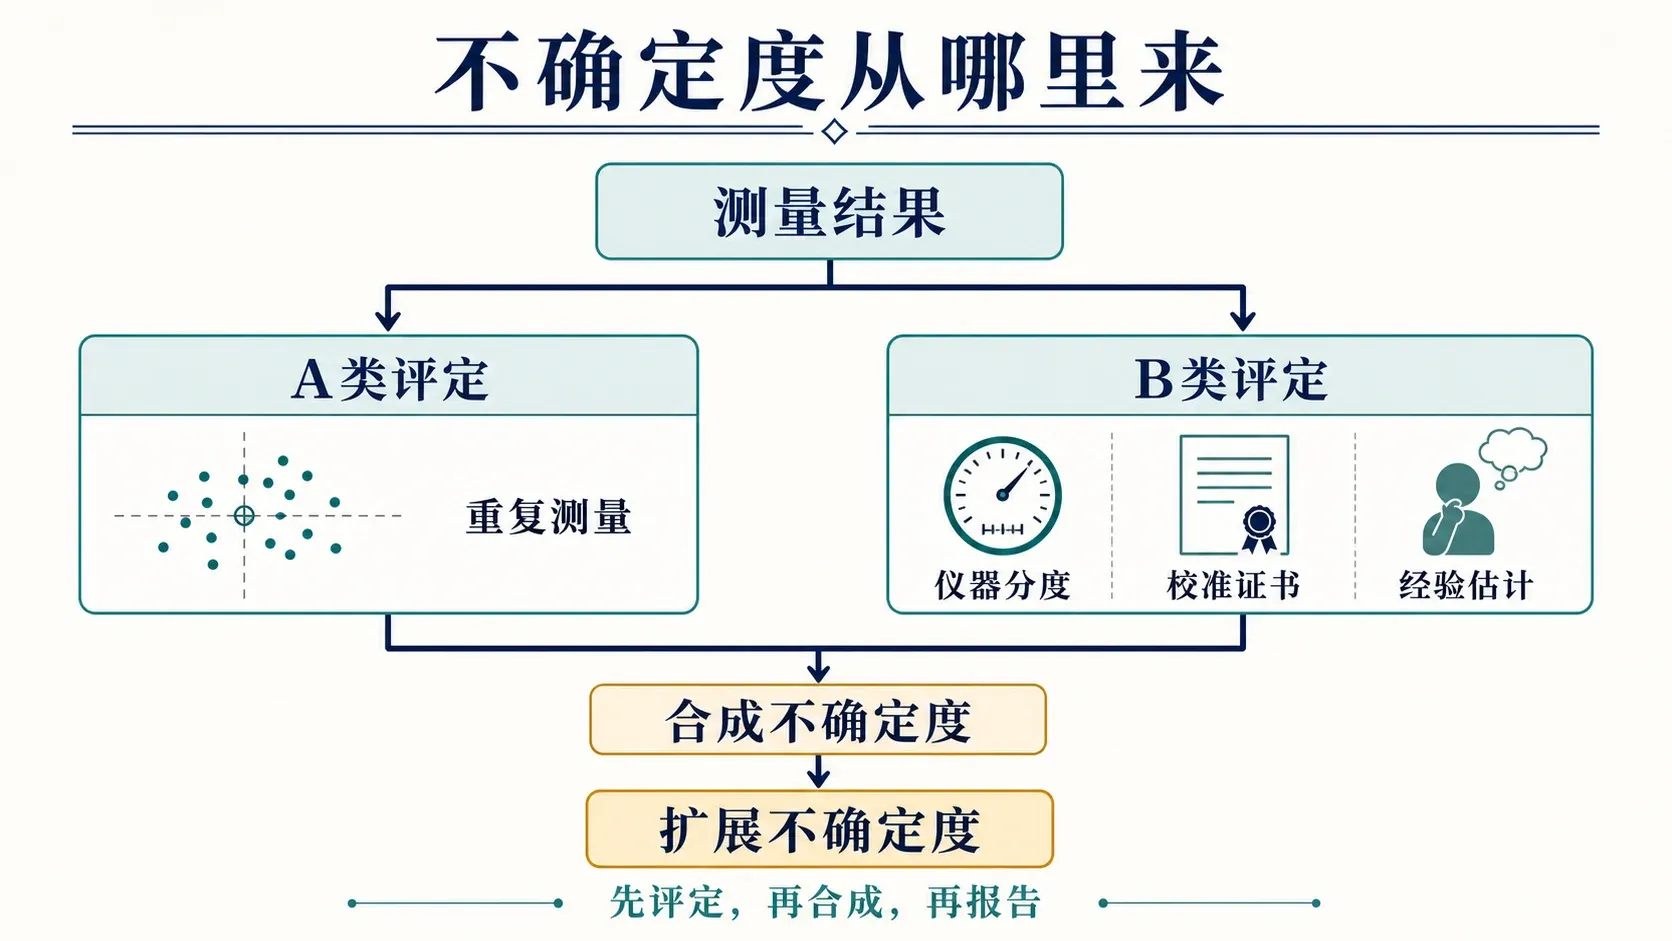
你可能会误以为:“A 类来自随机误差,B 类来自系统误差。”注意,这是一个陷阱。A、B 的区别首先在于评定方法:
- A 类评定基于重复观测结果的统计分析。上面四次滴定得到的
s / √n,就是用重复性估计平均值不确定度的典型例子。 - B 类评定不靠当前这组重复数据的统计分布,而利用校准证书、仪器规格、分度值、标准物质证书、既有验证数据、方法资料或有根据的经验来估计。它不是“随便猜”,每个来源都要说明依据和假定的分布。
例如,某个量的误差限为 ±a,且在这个区间内没有理由认为哪个值更可能出现,可按均匀分布估计标准不确定度 u_B = a / √3。但这个公式不是见到任何“分度”就机械套用:要先弄清 a 究竟是校准给出的限值、单次读数的分辨力、还是两个读数相减后的范围;不同测量模型得到的分量并不相同。仪器说明书、校准信息和实验规程永远优先。
把不确定度装进测量模型:不是背公式,而是问来源有没有被算进去
假如要由质量 m 和体积 V 计算浓度或密度,最终结果不是孤立冒出来的,而是由一个测量模型连接起来:y = f(x₁, x₂, …)。数据处理真正的难处在于追问:哪些输入量会影响 y?它们各自的不确定度是多少?这种影响会被放大还是缩小?
对于彼此不相关的输入量,常用方和根形式合成标准不确定度:
u_c(y) = √[Σ(cᵢu(xᵢ))²]
其中 cᵢ 是输入量变化传到结果的灵敏度系数。对乘除形式,写相对标准不确定度通常更直观。以 y = m / V 为例,在 m、V 不相关时:
u_rel(y) = √[u_rel(m)² + u_rel(V)²]
这条式子有一个隐藏前提:分量近似不相关。若同一支仪器的共同校准因素同时影响多个输入量,或同一温度修正重复出现,它们可能相关,不能假装互不相干而直接套方和根。基础实验报告遇到这类情况,应如实写明简化假定并按课程要求处理,而不是用更漂亮的公式掩盖未知关系。
合成标准不确定度 u_c 有时还会乘覆盖因子 k 得到扩展不确定度:U = k u_c。例如在满足相应模型和近似条件时,常用 k ≈ 2 给出约 95% 覆盖水平的扩展不确定度。注意“约”字:覆盖概率取决于分布、自由度和评定方法;报告中应说明 k,需要时还应说明覆盖概率或置信水平,不能把所有 k = 2 都说成精确的 95%。
例题:把四次滴定的波动和仪器信息合在一起
仍用前面的四次体积数据。已知平均值的 A 类标准不确定度为 u_A = s / √n = 0.0129 / 2 = 0.00645 mL。为演示计算,假设已确认:本次“交付体积”对应的校准限为 ±0.020 mL,可近似按均匀分布,且与重复性分量不相关。请给平均滴定体积写出一个简化的不确定度结果。
先把校准限转换为 B 类标准不确定度:u_B = 0.020 / √3 = 0.0115 mL。这里使用均匀分布,是题目给定的简化假定;真实实验必须以仪器的校准信息和测量模型为准。
在两项不相关的假定下合成:u_c = √(0.00645² + 0.0115²) = 0.0132 mL。两项都应以标准不确定度的形式进入计算,不能把一个写成极差、另一个写成标准偏差后直接相加。
若按 k = 2 给出扩展不确定度,U = 2 × 0.0132 = 0.0264 mL,按一位有效数字可写为 0.03 mL。
一个可复核的不确定度报告至少让读者看见四件事:测量结果和单位、扩展不确定度或标准不确定度、覆盖因子或评定方式、主要来源与必要假定。它不是把所有误差“算没了”,而是把已知的可信边界讲清楚。
从表格到结论:让结果能被别人看懂、复算和质疑
完成公式并不代表报告完成。读者至少应能分辨哪些是原始读数、哪些是计算量、哪些条件会影响比较。一个清楚的基础实验结果区通常包含:
- 原始数据表。 表头写清量的名称、单位和必要条件;重复值逐项列出,而不是只留一个平均值。
- 处理过程。 给出所用公式、代入的代表性数据和中间结果;统一单位,避免把
mL和L、mg和g在同一式子里悄悄混用。 - 结果表达。 结果、单位、有效数字和不确定度相互对齐;若比较了参考值,也交代参考值来源和比较条件。
- 讨论。 区分已观察到的现象、可能影响方向的原因和已经有证据支持的判断。不要把“我觉得手抖了”写成确定结论,也不要把“数据接近”写成“没有系统误差”。
案例来得很实际:环境水样的吸光度测定得到一条很漂亮的标准曲线,但空白样吸光度始终偏高。你可能会只盯着相关系数,觉得“曲线线性很好,结果一定可靠”。注意,线性好只说明某一范围内点与拟合线关系良好;空白偏高提示试剂、比色皿、基线或污染等来源仍需核查。数据处理的成熟,不是能把软件输出的每个小数搬进报告,而是知道哪个异常会改变结论、下一步该查什么。
这一章到这里,你已经能把一次测量从“得到数字”推进到“交代数字的来路与可信程度”。下一章进入综合实验设计与报告时,这条链还会继续往前延伸:在动手前就决定需要哪些对照、重复和记录字段,让最后的不确定度不是事后补救,而是被实验方案提前照顾到。
练习:先判断证据够不够,再动手计算
练习 1:一样的读数,要不要都写
某同学三次读取滴定管末读数,恰好都是 24.36 mL。他说“反正一样,只写一次即可”。这句话哪里不对?
练习 2:精密不等于准确
四次测定分别为 9.98、9.99、9.98、9.99 mg·L⁻¹,参考值为 10.50 mg·L⁻¹。这组数据最值得优先警惕什么?
练习 3:不要用肉眼“洗数据”
某五次滴定体积为 20.11、20.10、20.12、20.11、20.68 mL。写出你在删除最后一个数前应完成的两类工作。
练习 4:报告值如何对齐
某计算结果为 1.23467 g·L⁻¹,扩展不确定度为 0.012 g·L⁻¹ (k = 2)。请按本章的基本原则写出结果。
1
关于四次平行测定的样本标准偏差 s,下列说法正确的是:
2
下列哪些做法符合规范的数据处理思路?
3
只要增加重复测量次数,所有系统性偏差都会自动被平均掉。
4
对近似独立的 n 次重复测量,平均值的 A 类标准不确定度可写为 u_A(x̄) = ____。
本章收束
一份可靠的实验结果,从来不是把一串数字算到最后那么简单。先把原始数据和条件留下来,再用有效数字避免虚假的精确;用平均值、标准偏差和 RSD 描述重复性,却不把它们误当成准确度;最后把 A 类、B 类来源放进适当的模型,带着单位、覆盖因子和假定报告不确定度。这样,当别人问“这个数凭什么可信”时,你交出的不只是一个答案,而是一条可以被检查、被复算、也能经受质疑的理由链。