Key 设计决定 Redis 能不能长期维护
上一章把 String、Hash、List、Set 和 Sorted Set 摆到了真实业务里。接下来最容易犯的错,是觉得“结构选对了,剩下只是起个名字”。
设想一次周五晚上的故障。shop-7 租户反馈个人资料一直显示旧头像,值班同学登录 Redis,先看到 user:1001,又看到 profile:1001、prod:user:1001 和 cache:user:1001:v2。没人能马上回答这四个 key 是否属于同一份数据,哪个可以删,哪个有 TTL,哪个仍被旧版本应用读取。为了保险,大家一个都不敢碰。半小时后内存告警也响了,因为一批没有过期时间的旧格式 key 一直留在实例里。
这不是“命名不够优雅”,而是数据契约失效。应用写入一个 key 的那一刻,其实同时决定了它属于谁、保存什么、活多久、怎样升级、能否批量处理、在 Cluster 中落到哪里,以及内存不足时能不能被淘汰。本章要做的,就是把这些决定从零散代码里收回来,变成一份可以检查、可以演进的 Key 契约。
Key 名称要能回答五个问题
Redis 不会替我们创建命名空间。冒号只是团队约定的分隔符,prod:shop-7:user:profile:1001 在 Redis 看来仍是一整段字符串。它之所以有用,是因为人在看到它时能从左到右回答五个问题:这是哪个环境、哪个租户、哪个业务域、哪类实体、哪一个对象。
text
prod : shop-7 : user : profile : 1001
环境    租户       业务     实体       标识
我建议先固定段位,再允许少数 key 按业务补充末尾维度。比如:
text
prod:shop-7:user:profile:1001
prod:shop-7:session:sess_demo_001
prod:shop-7:article:views:a100
prod:shop-7:rank:weekly:2026-W34
prod:shop-7:rate:user:1001:2026-08-19T10
时间窗口、榜单周期这类会改变数据集合边界的信息可以进入 key;用户昵称、商品标题这类可变属性不应该进入 key。否则一次改名就等于迁移主键。标识还要使用稳定、无歧义的形式:同一个用户不要有时写 1001,有时写 u1001;外部输入中的空格、冒号和换行也不要未经编码直接拼接。
Key 还会出现在慢日志、监控、异常堆栈和排障工单中,因此不要把手机号、邮箱、身份证号、访问令牌直接拼进去。需要按敏感标识定位时,可以保存内部 ID,或者使用稳定摘要,再在受控系统中维护映射。这样既能按对象排查,也不会让一条普通 Redis 日志变成隐私泄露入口。
不要为了节省几个字符把名字压缩到只有作者看得懂。p:s:42 的确比 product:stock:sku-42 短,但值班人员无法判断它属于商品、支付还是推送。反过来,也不要把完整类名、接口路径和字段描述全塞进 key。可读性与内存都要衡量:先用业务量估算 key 名总占用,再决定哪些缩写值得成为团队词汇,而不是凭感觉追求“越短越快”。
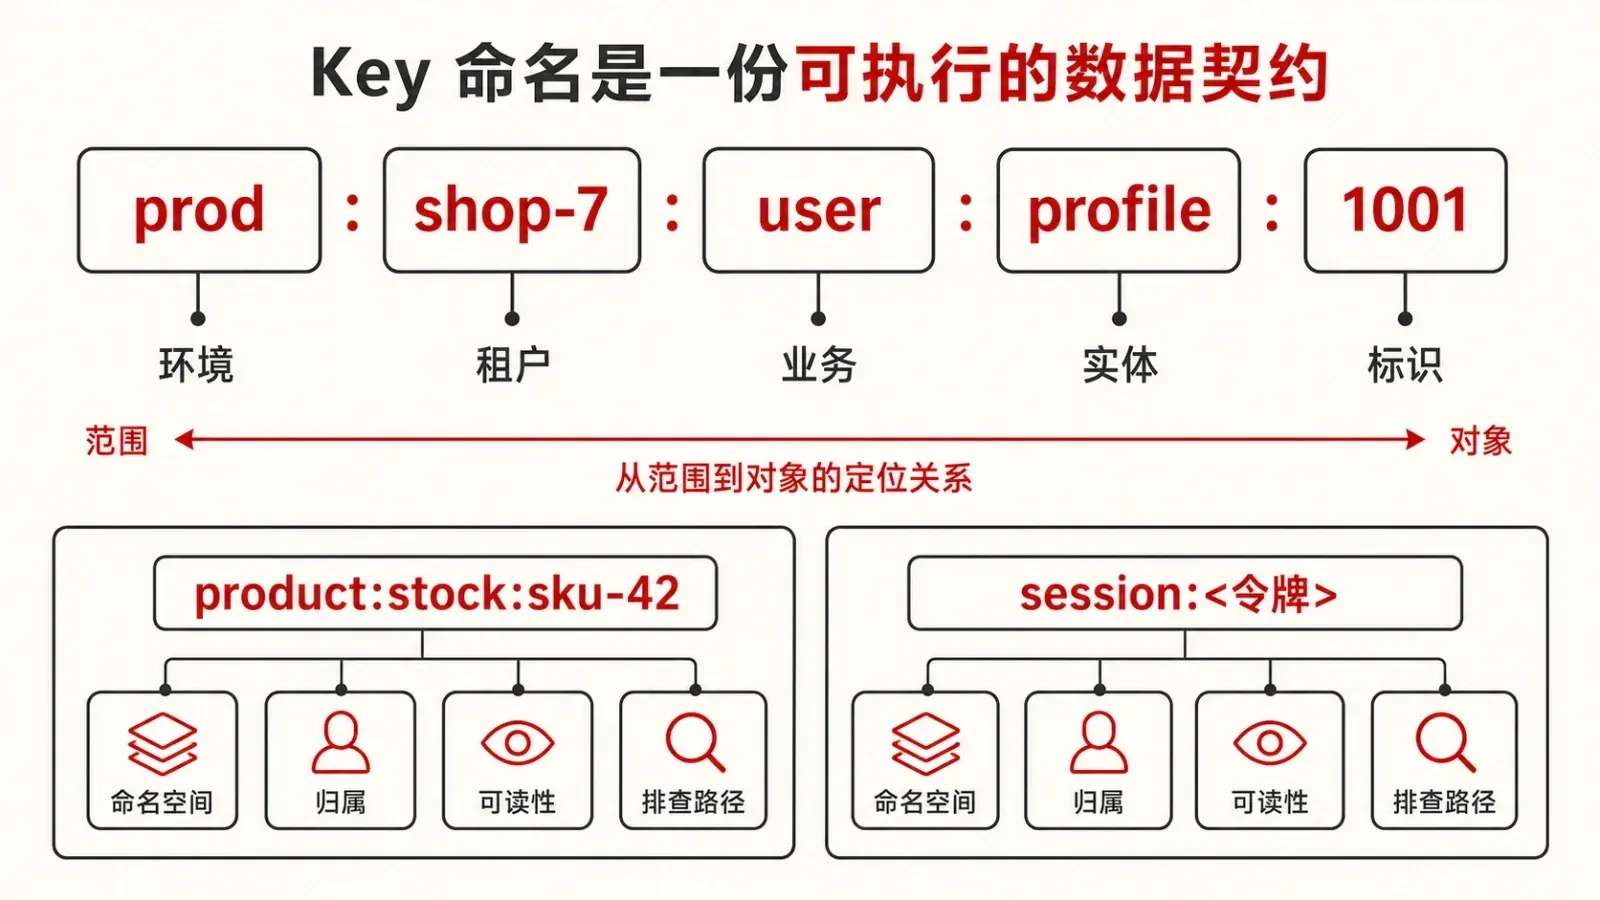
命名规范真正的验收方式不是放一页文档,而是让代码生成 key,让测试检查 key。下面的检查器可以输入多个候选名称,观察环境、租户、业务、对象标识和危险字符是否满足同一份契约。
环境和租户隔离不能只靠“大家小心一点”
dev:user:1001 与 prod:user:1001 至少不会互相覆盖,但把开发、测试、生产都放在一个实例里,仍然共享 CPU、内存上限、淘汰策略和故障半径。前缀解决的是名字冲突,不等于资源隔离。生产环境与非生产环境最好使用独立实例;可靠性目标不同的业务,也不应仅凭前缀挤在同一份内存预算里。
多租户系统还要先决定隔离边界。如果每个租户的数据量小、租户数多,可以让租户 ID 成为固定段位,例如 prod:shop-7:user:profile:1001。如果某个大租户可能独占大部分内存或流量,就要考虑独立实例、独立分片或显式配额,而不是继续加长 key。只要所有租户共用同一个实例,某个租户制造的大 Key、热 Key 或错误扫描就仍可能拖慢别人。
ioredis 提供 keyPrefix,可以把公共前缀集中配置:
js
import Redis from "ioredis";

const redis = new Redis({
  host: "127.0.0.1",
  port: 6389,
  keyPrefix: "prod:shop-7:",
});

await redis.set("user:profile:1001", "...");
// 实际写入 prod:shop-7:user:profile:1001但这里有一个很容易踩中的坑:keyPrefix 会处理命令中的 key,不会替 SCAN、KEYS 的匹配模式自动补前缀,也不会改写命令返回的 key 名。于是 scanStream({ match: "user:*" }) 查不到真实的 prod:shop-7:user:*。把前缀封装成显式的 keyOf() 与 patternOf(),通常比依赖隐式魔法更容易审查。
一个实用做法是建立 Key 工厂,业务代码只能传已经校验过的租户 ID 和实体 ID。工厂集中处理前缀、转义与长度限制,单元测试则固定几个输入输出样例。这样做还能避免“写入路径带租户,删除路径漏租户”的事故。若系统使用 Redis ACL,权限规则也应与稳定前缀对应,但 ACL 只是额外防线,不能修复错误的数据归属模型。
线上找 Key,用 SCAN 而不是 KEYS
命名规范常被宣传成“以后可以按前缀批量删”。这句话只说了一半。Redis 没有“删除某个前缀”的原子命令,应用需要先遍历,再分批处理。KEYS prod:shop-7:user:* 会在一次命令中搜索并返回匹配结果,keyspace 很大时会长时间占用执行路径,因此不能进入常规线上代码。
SCAN 把遍历拆成多轮,每轮返回新游标。游标回到 0 才表示一轮结束,某一轮返回空数组并不代表完成;COUNT 只是工作量提示,不保证每轮恰好返回指定数量。遍历期间 keyspace 还在变化,所以同一个 key 可能重复出现,过程中新增或删除的 key 是否被看到也不确定。批量修复和删除必须允许重复执行,不能把 SCAN 当成数据库的一致性快照。
ioredis 的 scanStream 把游标循环包装成可读流。下面的维护任务使用一个没有配置 keyPrefix 的 adminRedis;因为扫描返回的是完整 key 名,如果再交给带 keyPrefix 的客户端删除,前缀会被重复拼接。处理每批 key 时要暂停扫描,完成本批工作后再恢复,否则下游操作比扫描慢时,待处理数组会在应用内存里堆积:
js
const stream = adminRedis.scanStream({
  match: "prod:shop-7:user:profile:*",
  count: 100,
  type: "string",
});

async function processBatch(keys) {
  const uniqueKeys = [...new Set(keys)]
上面用 UNLINK 是因为删除 value 可能涉及较多内存释放工作。它先从 keyspace 中摘掉 key,再异步回收内存,适合删除可能较大的对象。不过,“能批量删除”不能成为业务主流程的一部分。更稳妥的失效方式是把版本或批次写进 key,让旧数据自然过期;扫描只承担迁移、审计和应急清理。
真正执行线上扫描前,还应写明运行窗口、匹配范围、每批上限、暂停条件与进度记录。Cluster 环境通常要覆盖各个主分片,扫完一个节点不代表扫完整个集群。任务中断后若从头开始,重复结果必须安全;若保存游标继续,也要接受 keyspace 在两次运行间已经变化。要删除的对象若很关键,可以先把候选 key 和类型写入审计结果,再由第二个受控步骤执行,而不是扫描到什么就立刻删什么。
还有一个常见误会:MATCH 只过滤返回结果,不会把整个扫描变成数据库索引查询。模式写得更精确有助于缩小结果和误操作范围,却不意味着一次全库遍历就没有成本。高峰期、超大实例和延迟敏感服务仍要限速,并观察命令耗时与业务尾延迟。
序列化格式也需要版本
有些故障与 key 名无关。旧应用把用户资料写成 {id,name,city},新应用直接读取后假设一定存在 avatar。灰度发布期间,新旧实例同时工作,新代码第一次命中旧缓存就报错。Redis 返回的只是字节,无法知道这段 JSON 符合哪一版业务结构。
可以把版本放在 value 中,让读路径显式兼容旧版本:
js
function decodeProfile(raw) {
  const value = JSON.parse(raw);

  if (value.v === 2) return value.data;
  if (value.v === 1) {
    return {
      ...value.data,
一次安全升级通常分三段:先让新代码同时读 v1 和 v2,再把写入切到 v2,确认旧实例退出并等待旧缓存自然消失,最后删除 v1 适配器。若新旧格式完全无法共用,也可以把大版本放进 key,例如 user:profile:v2:u1001,但这会产生两套生命周期,必须明确谁负责旧前缀退出。
迁移顺序还要考虑回滚。假设新版本把 city 拆成 province 和 city,旧应用却仍可能被重新拉起。新写入若只剩 v2,旧应用就会把字段读丢。可以在短暂窗口内保持旧读能力,或让旧版本遇到未知格式时绕过缓存回源,而不是继续写回一份残缺对象。双写两种格式只适合很短的迁移期,因为它扩大了失败组合,还会把缓存一致性问题翻倍。
解析成功也不等于数据有效。读取后至少要检查版本号、必需字段与基础类型;金额、权限、租户归属这类字段更不能依赖宽松的 JavaScript 强制转换。验证失败时记录“前缀 + 版本 + 错误类别”通常已经足够,不要把包含敏感资料的完整 value 打进日志。
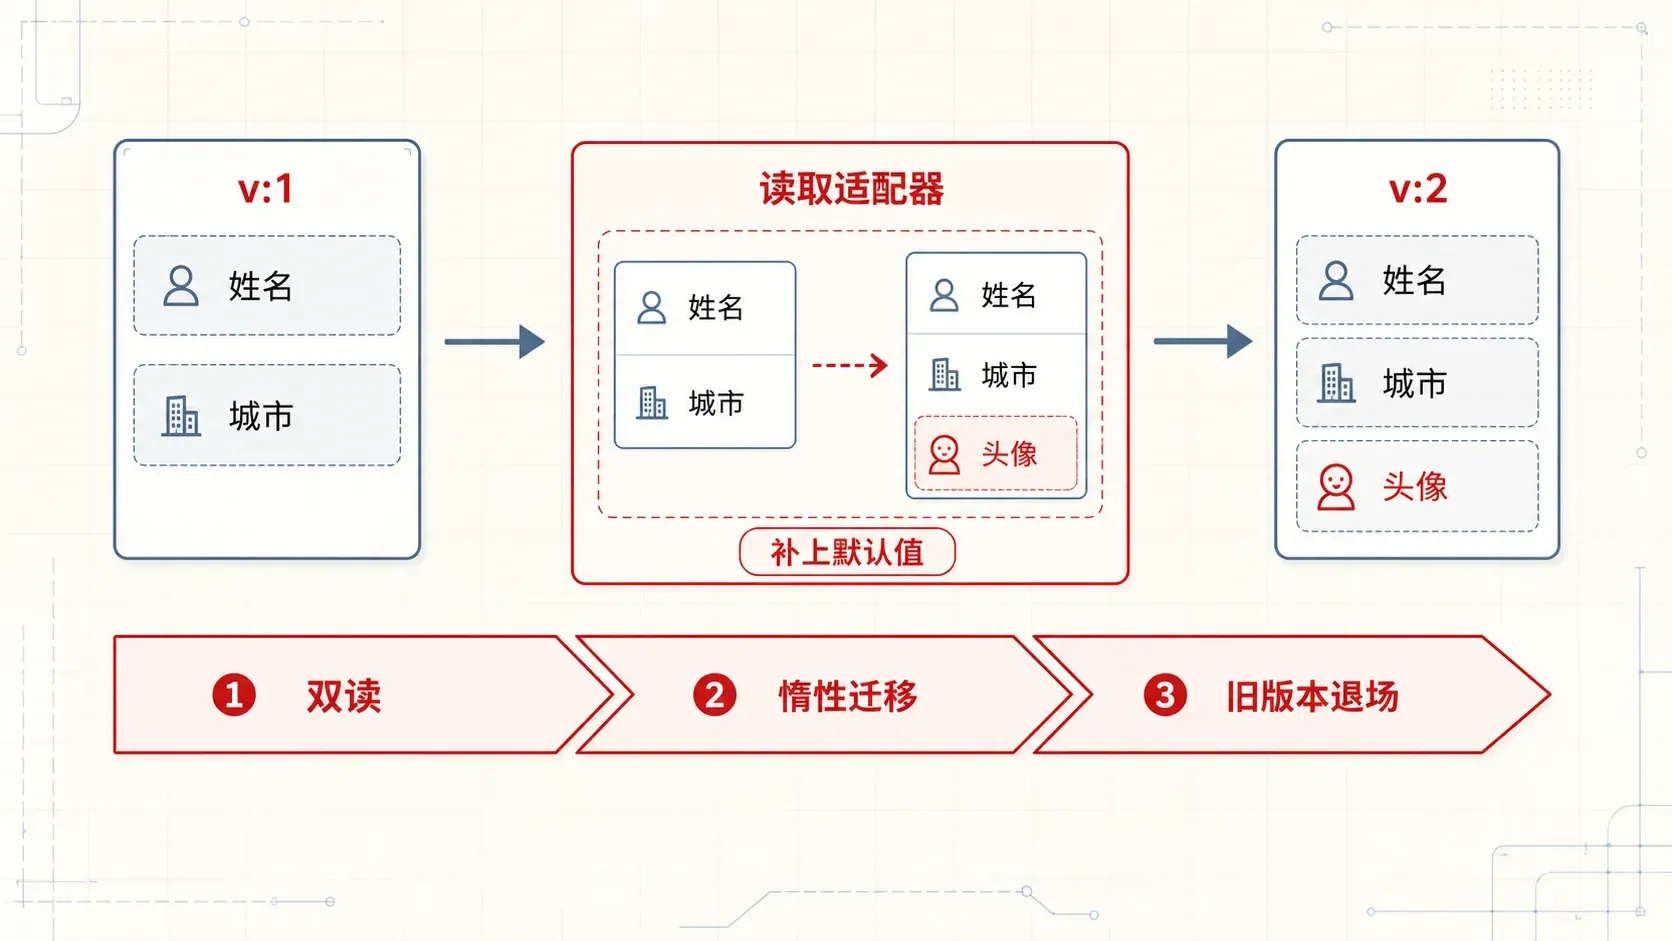
无论版本放在哪里,反序列化失败都不该悄悄变成空对象。对可重建缓存,可以记录指标、删除坏值并回源;对 Session 或幂等标记这类有安全语义的数据,失败时要按业务规则拒绝或重新认证,不能随意补默认值。
TTL 是生命周期,不是顺手填的数字
EXPIRE key 1800 表面上只是“半小时后删除”,实际回答的是:这份数据多久以后不再可信,以及没有任何请求访问时它何时释放内存。不同 key 的答案不同。
覆盖 key 时还要留意 TTL 是否被保留。像 SET 这类替换整个 value 的命令会清除原有过期时间,除非显式使用保留 TTL 的选项或在同一写入中重新指定过期。一个原本 30 分钟的 Session,如果续期代码只执行 SET key value,就可能悄悄变成永久 key。
同一批缓存也不要在同一秒整齐过期。统一项目中,用户资料使用稳定哈希生成 120~150 秒 TTL:同一个用户多次计算结果稳定,不同用户被分散到 31 个秒点。
js
function userTtl(userId) {
  let hash = 0;
  for (const char of userId) {
    hash = (hash * 31 + char.codePointAt(0)) >>> 0;
  }
  return 120 + (hash % 31)
在 Redis 8.2.2 与 ioredis 5.7.0 的验证中,u1001 首次读取来自数据库,再次读取来自缓存,数据库只读取 1 次;写入后的 TTL 落在 120~150 秒范围内。这里的抖动用来分散自然到期时刻,不能替代缓存击穿防护,也不能把本来只有 10 秒有效期的数据抖成几分钟。
相对 TTL 与绝对到期时间也服务不同语义。验证码“创建后五分钟失效”适合相对时长;当天报表缓存“次日零点切换”更适合按明确时刻到期。如果所有实例用自己的本地时钟计算关键截止点,要考虑时钟偏差;如果每次读取都无条件续期,还要评估热点 key 是否因此永远不退出。Session 的滑动续期常常还需要一个绝对最长登录期限,避免活跃会话无限延长。
设置抖动时要让分布可解释。完全随机虽然简单,却会让同一对象每次回填都改变期限,排查时难以复现;稳定哈希则能让同一 ID 落在固定偏移。无论采用哪种方式,都要监控单位时间内的到期数和回源量。过期分布看起来均匀,仍可能因为一次发布批量预热、一次全量导入或统一改写而再次对齐。
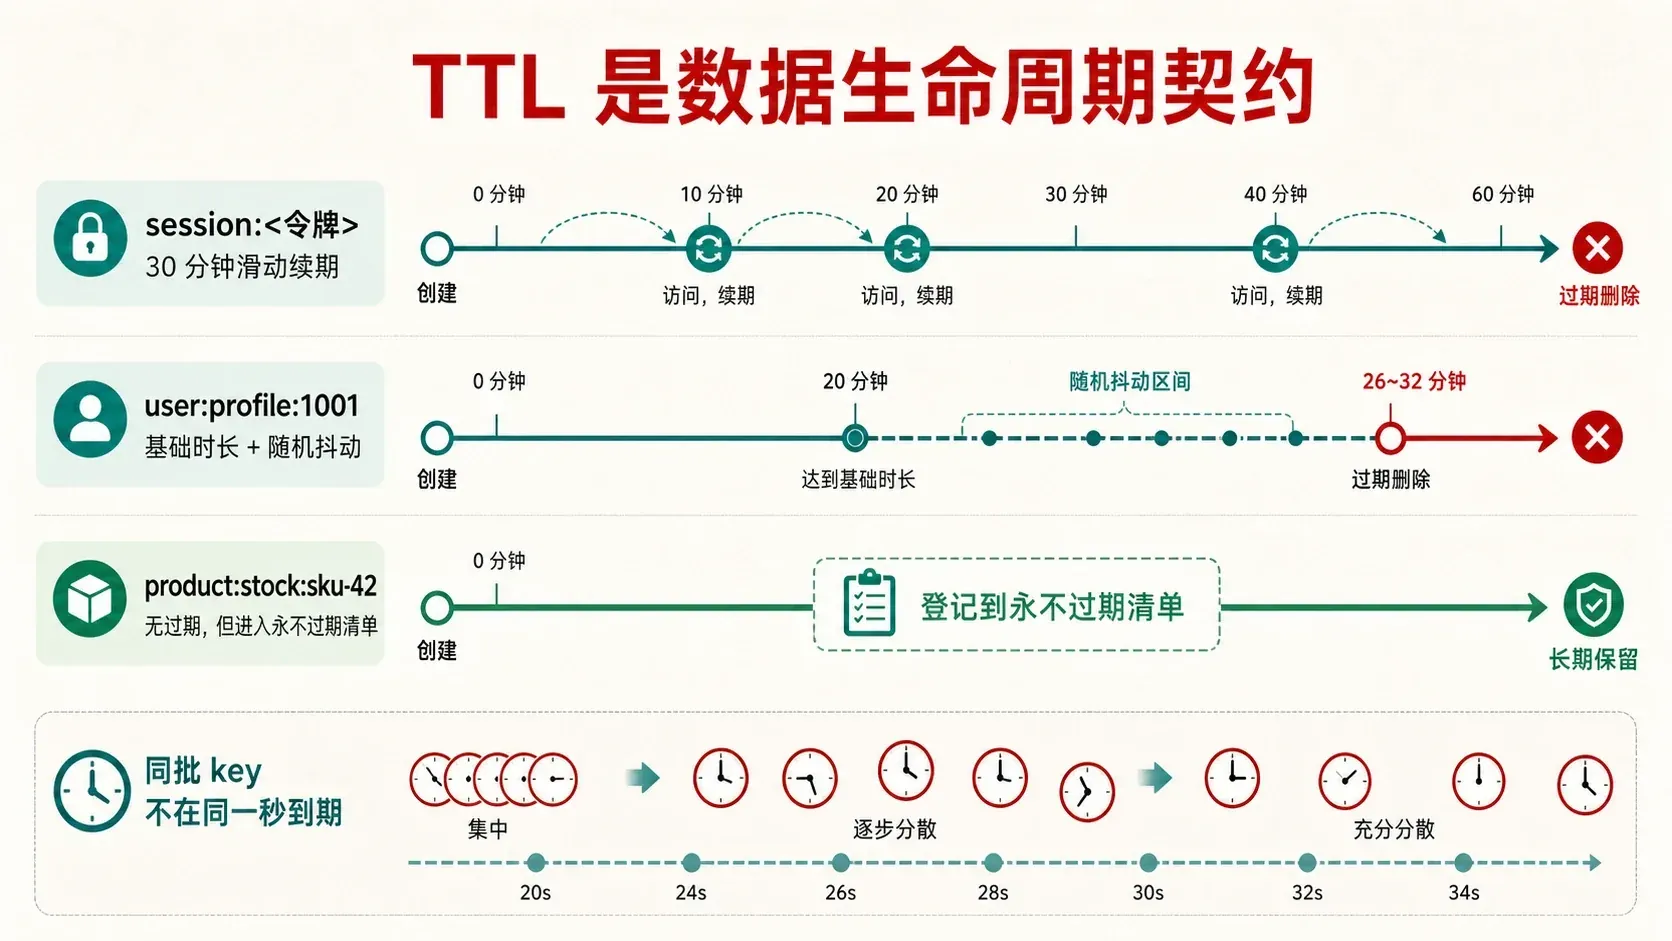
下面的生命周期规划器把基础 TTL、抖动范围、续期动作和永久 key 放在一条时间线上。重点不是找到一个全系统通用数字,而是检查每类 key 是否有清楚的到期语义。
永不过期 Key 必须进入清单
不是所有 key 都必须有 TTL。库存基线、消费者组状态、幂等集合或需要人工切换的配置,可能确实要长期保留。危险的不是“永不过期”,而是团队不知道哪些 key 被允许永不过期。
建议维护一张短清单,至少写明前缀、负责人、数据来源、删除方式、容量上限、备份要求和故障后能否重建。持续扫描 TTL = -1 的 key,并与清单比对。没有登记的永久 key 应被当成生命周期缺陷处理,而不是等到内存报警后再猜它能不能删。
淘汰策略也会改变“永久”的含义。使用 allkeys-lru 或 allkeys-lfu 时,即便没有 TTL,key 也可能在内存压力下被淘汰;使用只淘汰带 TTL 数据的 volatile-* 策略时,没有 TTL 的 key 不会成为候选。如果实例里全是未登记的永久 key,内存达到上限后,volatile-* 最终可能像 noeviction 一样让新增数据写入失败。
TTL 到期与内存淘汰是两套机制。到期表示业务声明数据不再有效;淘汰表示实例为了守住内存上限,被迫舍弃候选数据。不要用淘汰策略替代生命周期设计,也不要把“设置了 TTL”误解成“在到期前绝不会消失”。
大 Key 的问题不只是一条记录占内存
“String 超过多少 KB 算大 Key”没有脱离业务的统一答案。真正需要问的是:最慢的那次读取、写入、复制、持久化、迁移和删除,会不会突破延迟预算。一个 300 KB 的 String 可能已经让高频接口付出明显网络与序列化成本;一个拥有数十万成员的 Hash,即便很少整体读取,也会让迁移和删除变得沉重。
统一项目建立了一个逻辑长度 300000 字节的字符串。MEMORY USAGE diag:big:string 返回 311344 字节,说明实际占用还包括对象和分配开销;redis-cli --bigkeys 在同一数据集中识别出这个最大 String,也识别出一个拥有 150 项的最大 List。这个结果不能变成全公司的固定阈值,但可以说明为什么容量估算不能只统计 JSON 文本长度。
诊断时要区分三种量:String 看字节数,List、Hash、Set、Sorted Set 更关心成员数量与成员平均长度,Stream 还要看条目和消费者组状态。--bigkeys 适合找各类型中的相对大者,MEMORY USAGE 适合抽样实际内存,它们都不是“自动证明必须拆分”的裁判。最终阈值应落到接口 P99、网络包体、主线程命令耗时、复制延迟和扩缩容时间上。
拆完以后还要限制增长。只把一个巨大 List 按月份拆开,却忘记对每月桶执行裁剪,十二个月后只是从一个大 Key 变成十二个大 Key。队列要有积压上限,榜单要有保留范围,时间线要按窗口裁剪,集合要明确最大成员数;达到上限后的行为也要定义,是拒绝、归档、覆盖最旧数据,还是转移到磁盘存储。
拆分大 Key 时要按访问边界拆,而不是机械切成十块。用户资料可以把高频基础字段与低频扩展字段分开;超长时间线可以按月份或游标分桶;巨大集合可以按业务分区。但购物车的商品和优惠券若要在同一段 Lua 中原子校验,就还要同时考虑 Cluster 同槽。拆分减少单次操作的重量,也可能增加网络往返和一致性成本。
Cluster 的花括号是一种约束,不是装饰
Redis Cluster 把 key 分到 16384 个哈希槽。多 key 命令、事务或 Lua 脚本要同时操作多个 key 时,这些 key 必须落在同一个槽。可以用花括号指定哈希标签:
text
cart:{shop-7:1001}:items
cart:{shop-7:1001}:coupon
cart:{shop-7:1001}:summary
三个 key 只对花括号里的 shop-7:1001 计算槽位,因此可以一起参与同槽操作。cart:shop-7:{1001}:items 也能同槽,但如果不同租户都存在用户 1001,它们会被强行聚到同一个槽;把租户与用户一起放进标签更稳妥。
哈希标签不能滥用。若把所有订单都写成 order:{shop-7}:...,整个租户的订单会集中到一个槽,Cluster 明明有多个分片,却出现单槽热点。正确粒度通常是“确实需要共同原子操作的最小业务聚合”,例如一辆购物车或一个 SKU,而不是整个业务域。
设计阶段最好为每组多 key 操作列一张“必须一起执行”的清单,再从这张清单倒推标签。没有共同原子需求的 key 不要为了看起来整齐而同槽。上线后除了看节点总 CPU,还要看槽位与 key 前缀的流量分布;热点落在一个槽时,增加空闲节点不会自动把这一条业务 key 拆开。
ioredis 在 Cluster 中会根据 key 路由命令。Pipeline 中的 key 应属于同一节点;涉及事务和多 key 脚本时,更应该在 key 设计阶段就验证槽位,不能等上线后遇到 CROSSSLOT 才改名字,因为改 key 就是一次数据迁移。
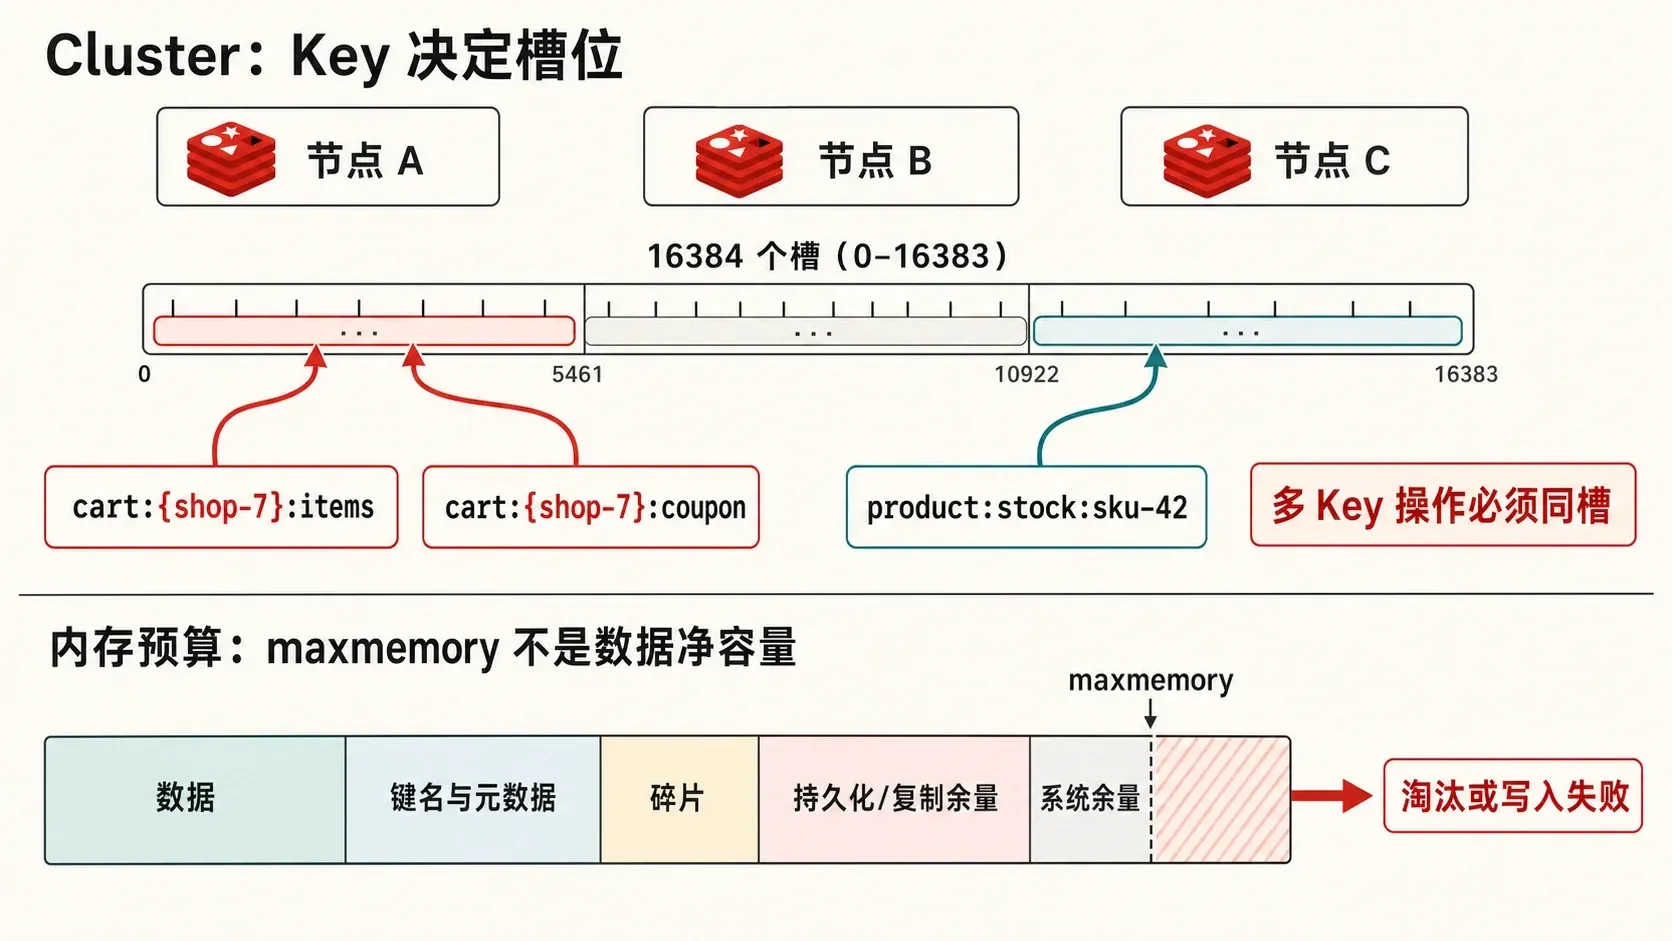
下面的实验台会计算普通 key 与带哈希标签 key 的槽位。可以尝试只保留 {shop-7},再改成 {shop-7:1001},观察“同槽能力”和“热点范围”如何一起变化。
内存预算要从业务量倒推
容量规划不能写成“机器有 64 GB,所以 maxmemory 64gb”。数据之外还有 key 名、对象元数据、内部编码、内存碎片,以及复制与 AOF 使用的缓冲;操作系统和 Redis 进程本身也需要余量。删除大量 key 后,Redis 报告的逻辑内存可能下降,进程常驻内存却未必立刻等量归还给操作系统。
可以先对每一类 key 做一张预算:
text
该类内存 ≈ 预计 key 数 × 单 key 实测平均占用 × 峰值系数
总预算   ≈ 各类内存之和 + 迁移/重写余量 + 碎片与系统余量
“单 key 实测平均占用”应来自接近真实长度与结构的数据,再用 MEMORY USAGE 抽样,而不是只数 value 字符。还要同时看 key 总数、平均 TTL、到期速率、淘汰量、命中率和各分片偏斜。某个槽被哈希标签压成热点时,全局还有空闲内存也救不了那个分片。
统一项目的隔离实例配置为 maxmemory 64mb 与 allkeys-lfu,验证时 used_memory_human 为 2.20M。这个小样本只证明配置和观测链路能工作,不代表 64 MB 能承载某个生产流量。策略选择取决于数据责任:纯缓存实例可以考虑在所有 key 中淘汰近期少用或低频数据;混有不可丢运行状态时,最好先拆实例。noeviction 不会自动保护业务,它只是在达到上限后让新增数据相关命令报错。
策略评审还要结合访问形态。近期访问能代表未来热点时,LRU 思路比较自然;访问次数比最近一次访问更有意义时,可以评估 LFU;只在带 TTL 的 key 中淘汰,则要求所有真正可淘汰对象都正确设置了 TTL。任何策略都可能淘汰“业务刚好需要”的数据,因此缓存层必须能承受未命中,运行时还要观察 evicted_keys、expired_keys、命中率与被拒绝的写命令。只看 used_memory 还剩多少,往往发现得太晚。
预算要包含增长速度。当前用了 20 GB 并不可怕,若每天净增 2 GB 且没有到期出口,十天后就会撞线。按前缀统计 key 数和内存样本,结合创建速率、自然到期速率与淘汰速率,才能估算还有多少安全时间。容量告警也不应只设一个百分比;可以同时设置内存水位、增长斜率、碎片比例与持续淘汰告警,让团队在业务开始大量回源或写入失败之前处理。
下面的预算工具可以同时调整 key 数量、名称长度、value 大小、元数据、碎片系数和安全余量,并比较不同淘汰策略下的风险。用它做设计评审时,最值得追问的是“哪个输入来自真实测量”。
把 Key 契约写进代码和评审
最后把这一章收成一张可以执行的表。每新增一类 key,都要在合并前填完,而不是上线后靠运维猜。
同一套实验中,Hash、List 和 Set 分别用下面三类 key 验证了结构与命名的对应关系:
js
await redis.hset("user:settings:u1001", {
  theme: "dark",
  locale: "zh-CN",
});
await redis.rpush("queue:email", "mail-1", "mail-2");
await redis.sadd("article:a100:tags", "redis", "backend"
在 Node.js v25.2.1、ioredis 5.7.0、Redis 8.2.2 中得到:
text
{"theme":"dark","locale":"zh-CN"}
["mail-1","mail-2"]
["backend","redis"]
Set 中重复写入的 redis 只保留一份,说明数据结构语义按预期工作;但真正让这三类数据长期可维护的,是它们各自还要有 TTL、容量、升级和删除契约。命令跑通只是起点。
下一章会把 user:profile:u1001 真正放进 Cache Aside 读路径。到那时你会看到,缓存穿透、击穿和雪崩并不是凭空出现的三个术语:它们分别与 key 是否存在、单个热点 key 的生命周期、以及一批 key 的 TTL 分布直接相关。