分子遗传学基础
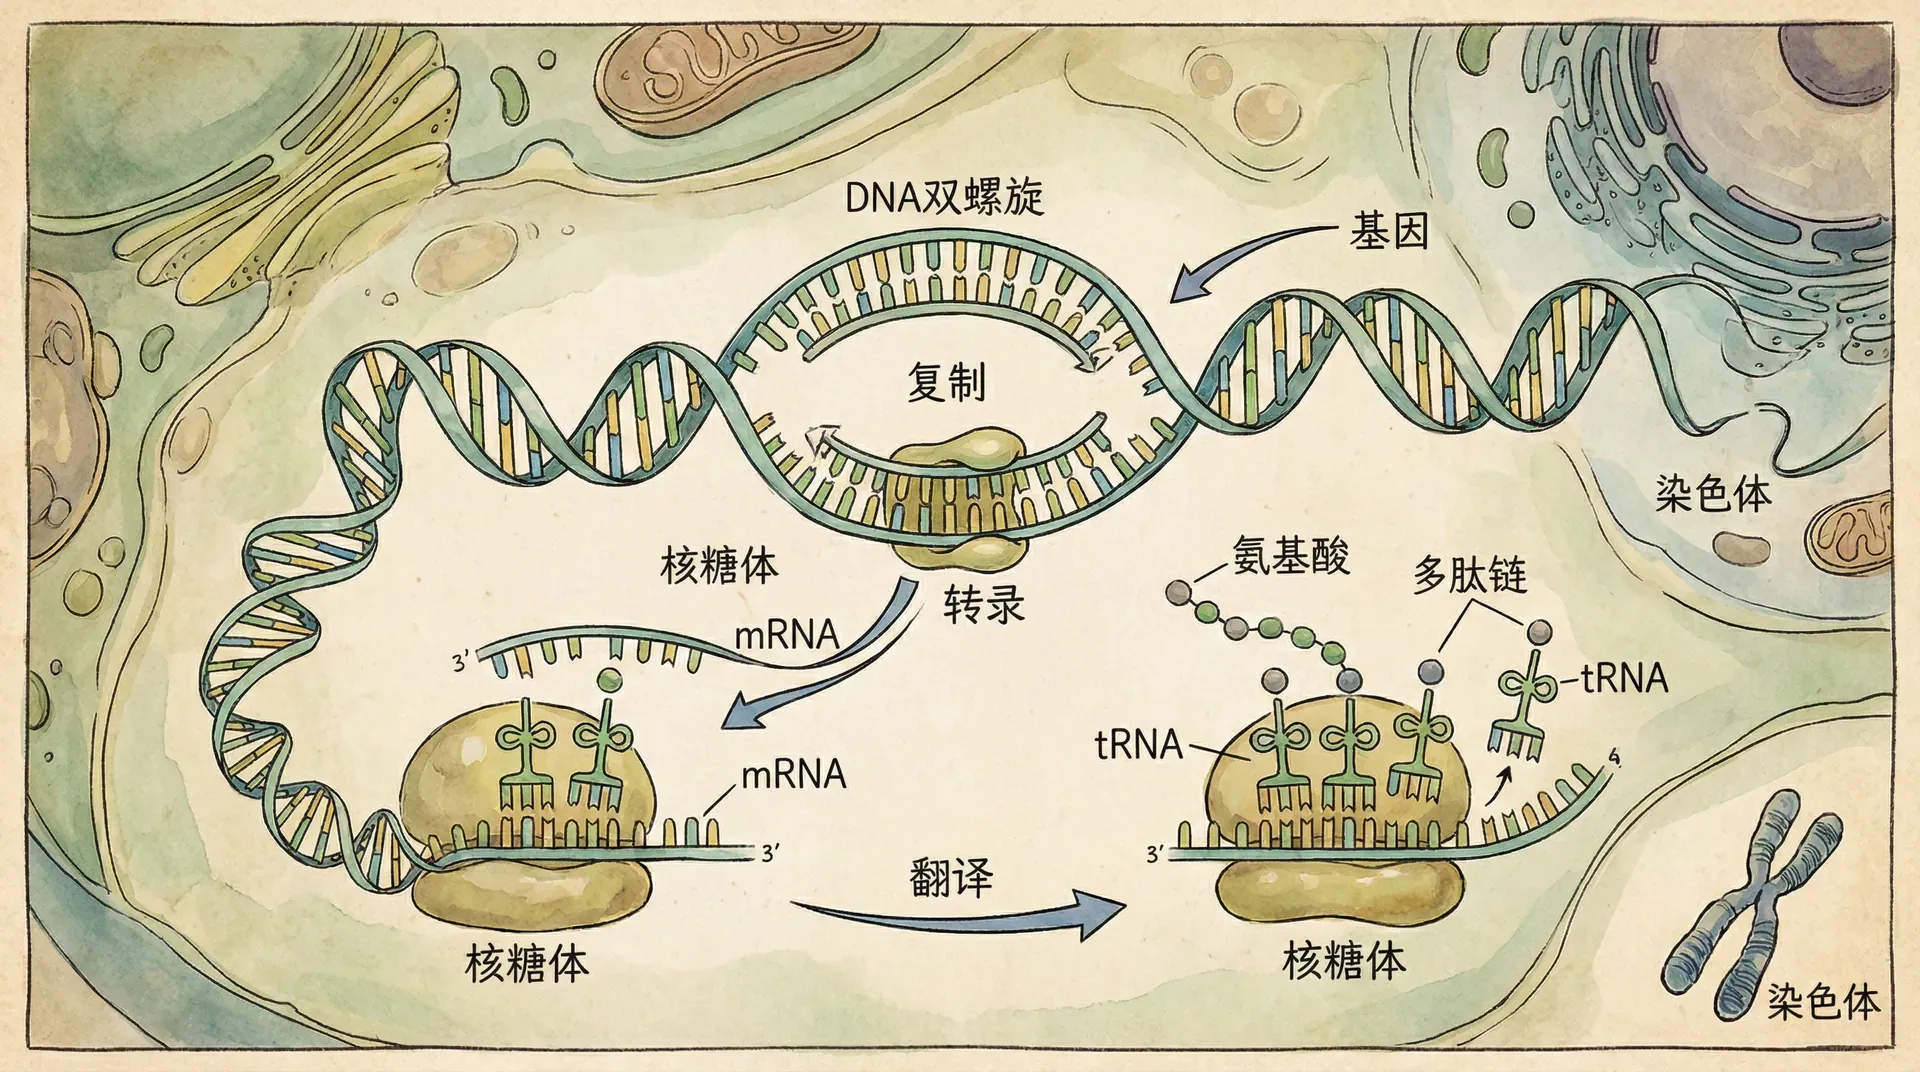
亲代与子代的相似性说明遗传信息能够传递,个体间的差异则提示传递并非简单复制。20世纪的一系列实验把“遗传因子”与具体分子联系起来,并逐步建立了DNA结构、复制和染色体组织的解释框架。
DNA是多数生物的遗传物质,但仅知道DNA序列还不足以解释完整性状。基因表达、RNA、蛋白质、细胞环境和发育过程共同把遗传信息转化为表型。现代育种、遗传诊断和分子检测会利用DNA知识,也需要各自独立的实验和临床证据。
DNA承担遗传功能的证据积累
对遗传根源的追寻
上世纪初,学者们已经明确基因在染色体之上,可基因真正的物质基础仍然笼罩在迷雾里。染色体中既包含蛋白质,也含有核酸。从分子构造的复杂性考虑,许多研究者最初更看好蛋白质担当遗传载体角色,觉得其多样性足以胜任复杂遗传指令,而当时的核酸被视作结构简单,没有引起足够重视。直到一系列试验证据逐步积累,科学界才逐渐转变看法。
在这转折过程中,弗雷德里克·格里菲斯于1928年的一项实验成为了分水岭。他并未直接找到遗传物质是什么,但揭示了遗传性质可以在细胞间转移,为后续研究指明方向。
格里菲斯实验
当格里菲斯研究肺炎链球菌时,他发现有可以致病的“光滑型(S)”和无害的“粗糙型(R)”。他混合了被高温杀死的S型菌与活的R型菌,并将混合物注射到小鼠体内。结果不但小鼠死亡,而且这些小鼠血液中分离出的竟然是活的S型菌。
他提出,有某种物质能让R型转变成S型。这种现象后来称作“转化”,意味着细胞可吸收外源遗传因子并出现表型变化。
这项发现说明可遗传的转化确实发生,却没有确定“转化因子”的化学本质。艾弗里、麦克劳德和麦卡蒂随后分离不同成分,并比较蛋白酶、RNA酶和DNA酶处理后的转化能力;只有破坏DNA会消除活性,这为DNA是转化因子提供了强有力证据。
噬菌体作用实验
转化实验有力支持DNA的遗传作用,但研究者仍希望在另一种体系中追踪DNA与蛋白质的去向。1952年,赫尔希和蔡斯用T2噬菌体感染细菌,提供了相互补充的证据。
他们选择构造单纯的T2噬菌体,它既包含蛋白质外壳又有内部的DNA。研究者们利用同位素为这两种成分分别作标签:给蛋白壳贴上带放射性的³⁵S、让DNA携带带放射性的³²P。噬菌体感染细菌后,科学家分离了被感染后的细胞和外部壳体,检测放射性分布。
实验组别如下所示:
结果显示,³²P标记主要与细菌细胞和后代噬菌体相关,³⁵S标记主要留在细胞外。实验支持DNA在T2噬菌体增殖中承担遗传功能,但“主要分布”不等于两种标记绝对分离,也不能由此推出所有病毒都以DNA为遗传物质——许多病毒使用RNA基因组。
赫尔希—蔡斯实验的价值在于把两类分子分别标记,并用感染后的空间分布和后代标记作为判据。它与转化实验等证据共同建立了DNA遗传功能的认识。
查加夫规律
DNA的遗传角色确定后,其内部结构更受到关注。化学家查加夫梳理了不同物种的DNA组成,意外发现重要规律:
- 物种间多样性:不同生物体内,四种碱基的比例呈现各异
- 配对对等性:每一物种内,腺嘌呤(A)与胸腺嘧啶(T)数量极为相近,鸟嘌呤(G)和胞嘧啶(C)之间也几乎等量
来看看具体测量数据对比:
图表展示了多种生物中四种碱基(A、T、G、C)的配比情况,一目了然。可以看到,虽然不同物种的A+T和G+C的总体比例各不相同,但在同一个物种内部,A和T的数量总是非常接近,G和C的数量也几乎一致。这一现象并非偶然,而是DNA分子结构的一个重要规律。
查加夫通过严谨的实验证明了上述比例关系,这一后来被称为“查加夫法则”的规律,成为推测DNA分子双螺旋结构的重大线索。正是这些精确的数据,使科学家们认定DNA不是一种随意排列的聚合物,而有其独特的碱基配对模式,为破解遗传密码铺平了道路,也为DNA双螺旋模型的建立提供了坚实的化学依据。
DNA双螺旋
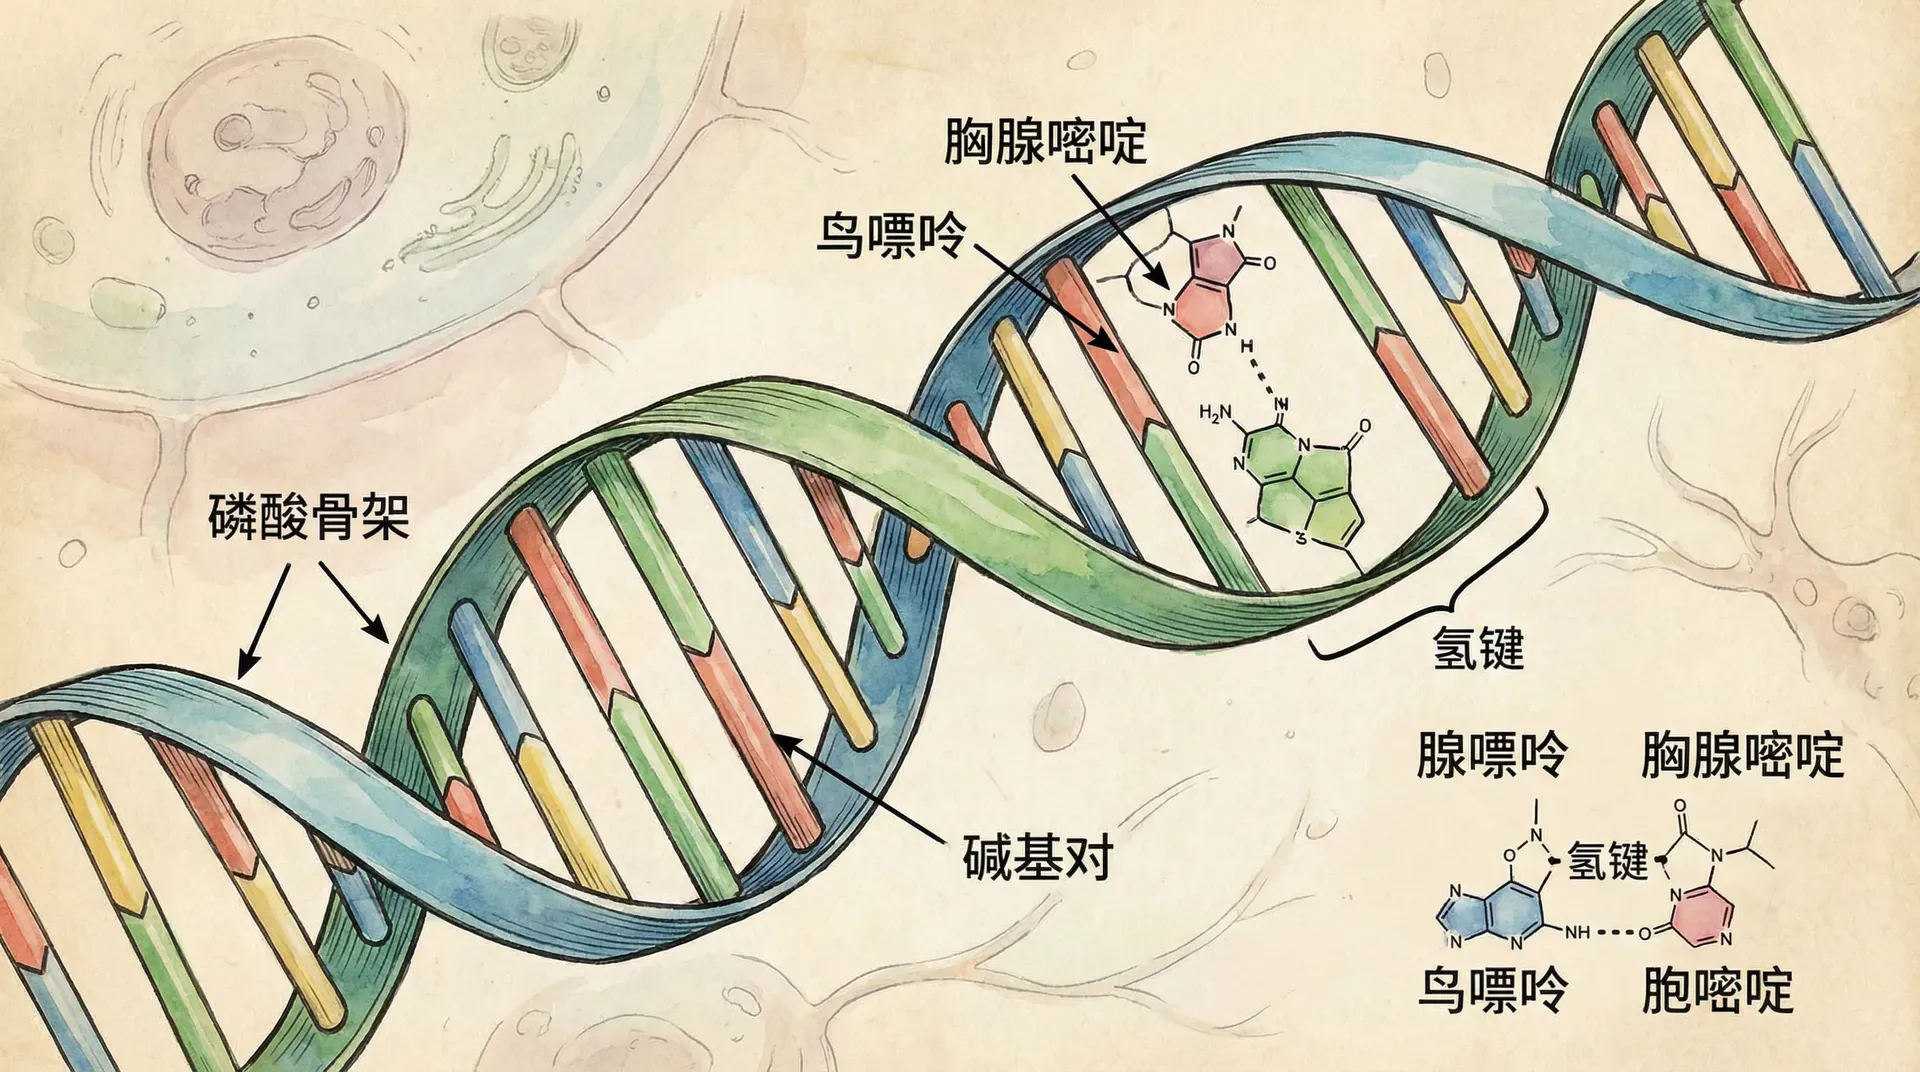
20世纪50年代初,多个研究组从化学组成、X射线衍射和模型构建等方向研究DNA结构。富兰克林与威尔金斯等人的衍射数据、查加夫的碱基比例规律,以及已有的化学键知识共同约束了模型。沃森和克里克据此提出双螺旋结构;这段历史也提醒我们关注数据取得、交流和署名中的科学规范。
X射线衍射
DNA结构的突破离不开物理化学的前沿利器——X射线衍射。富兰克林精于此道,她拍摄的“照片51”是科学史上极具传奇色彩的一页。通过衍射图样,她观察到栅格状X形斑点,直观反映了DNA分子的螺旋性。科学家由此测算出:
- 双螺旋每转有大约10个碱基对,
- 螺旋直径约是2纳米,
- 紧邻碱基之间的距离在0.34纳米左右。
这为后续模型建立提供了不可替代的数据支撑。
分子层面的对接
深入研究后,沃森和克里克认识到,DNA分子的稳定结构源自碱基之间极其特定的配对方式。
- 嘌呤(腺嘌呤A、鸟嘌呤G) 个头更大,拥有两个环;
- 嘧啶(胸腺嘧啶T、胞嘧啶C) 体积更小,只含单环。
如果仅让两个嘌呤或两个嘧啶结合,DNA链宽度会变得不均匀。只有一条链上的嘌呤正好对应另一链的嘧啶,才能确保螺旋外径恒定。 A总是与T结合,两者之间形成2个氢键;G则与C配对,有3个氢键牵引。这种高度“对等性”正好与查加夫法则所揭示的碱基比例关系不谋而合。
1953年的双螺旋模型解释了碱基配对与衍射数据,也提示每条链都可以为新链提供模板。模型的接受建立在结构是否符合多类证据上,而不是论文篇幅或“抢先”本身。
双螺旋
DNA双螺旋可以从以下结构关系理解:
DNA复制的分子机制
DNA作为遗传信息的载体,其精确复制是生命连续性的基础。理解DNA复制的分子机制,不仅有助于揭示遗传物质如何从一代传递到下一代,也为分子生物学、医学、基因工程等领域奠定了理论基础。本节将介绍DNA复制的基本过程及其分子层面的关键机制。
不同复制模型的构想
双螺旋结构提出以后,科学家们意识到一个亟需解决的问题:DNA的两条互补链在复制过程中如何被准确地分配到新生的子代DNA分子中,这对于遗传信息的稳定传递至关重要。针对这一问题,研究者们提出了三个主要的复制模型:保守复制、半保守复制和分散复制,每种模型都对原有DNA链在子代中的分布方式做出了不同的假设,并为后续的实验验证提供了方向。
由于当时分子生物学的实验手段有限,研究者们围绕DNA分子的复制方式展开了激烈讨论,并提出了三种主要的理论模型,以解释遗传信息的传递机制:
这些假说往往只停留在理论层面,难以通过传统实验区分。直到1958年,梅塞尔森和斯塔尔利用15N与14N两种氮同位素,创造性地验证了半保守复制。他们的实验思路堪称分子生物学的典范:
- 让大肠杆菌在15N重氮环境中连续生长,使其DNA均为重型。
- 再转入14N轻氮培养基,观察复制后的DNA密度变化。
- 每一代提取DNA,用密度梯度离心法分析结果。
第一代DNA呈单一中间密度,排除了保守复制;第二代出现中间带和轻带,结果符合半保守复制并排除了分散复制在该代的预测。实验的说服力来自不同模型给出不同结果,研究者再用密度分布进行区分。
DNA复制的分步剖析
复制起始点的奥秘
DNA复制从复制起点(origin)启动。大肠杆菌染色体通常有一个主要起点,真核生物每条染色体则具有多个潜在起点,并只在其中一部分按时序激活。起点许可和激活受到分层调控,使每段DNA通常在一个细胞周期中复制一次。
关键分子角色包括:
- DNA解旋酶:主动劈开双螺旋,为复制开路。
- 单链结合蛋白(SSB):迅速缠绕在暴露的单链上,防止其回弹重组。
- 拓扑异构酶:缓解因解旋而产生的DNA过度缠绕现象,确保前行顺畅。
DNA链的合成逻辑

复制的核心由一系列酶密切分工协作完成:
RNA引物的奠基作用
DNA聚合酶“挑剔”地拒绝从零开始,新链合成必须借助引物酶先制造一小段RNA“起点”。随后,DNA聚合酶才能执笔继续书写遗传信息。
前导链与滞后链的策略
由DNA双螺旋的反向平行特性,复制存在不同的“进度通道”:
- 前导链(Leading strand):顺着解旋方向,平稳、连续地拓展新链。
- 滞后链(Lagging strand):逆行而作,只能断续生成短小的“冈崎片段(Okazaki fragments)”,最后由连接酶(ligase)拼接成完整链条。
不同生物体内,DNA复制速度差异显著:
完整基因组的复制时间取决于复制叉速度、同时工作的复制叉数量、起点激活时序以及检查点调控。不能把物种差异简单解释为细菌“追求速度”、多细胞生物“追求准确”,因为两类生物都必须在速度、准确性和资源消耗之间取得可行平衡。
复制过程的“质检”
DNA聚合酶的碱基选择、校对和复制后的错配修复共同降低复制错误率。少量未被修复的变化会成为突变,其影响取决于发生位置、细胞类型和后续选择。
DNA聚合酶的校对
许多DNA聚合酶配备3'→5'外切酶“橡皮擦”,能识别并切除新合成链中的错误碱基,这一过程中类似人工智能文本校正工具,高效又可靠。
错配修复系统的补救
错配修复系统识别新合成链中的部分错配和小型插入、缺失环,并切除含错区域后重新合成。修复基因缺陷会提高突变率,并与某些遗传性肿瘤易感综合征相关,但不同修复通路异常产生的疾病风险并不相同。
DNA修复由多条通路承担。相关基因变异可能增加疾病风险,风险大小还取决于变异类型、另一等位基因状态、组织和环境暴露,因此不能把“发生变异”直接等同于一定患病。
DNA复制与健康、科技的深层联系
DNA复制研究的意义已远超基础科学:
抗菌“武器”之源
不少抗生素本质上就是靶向细菌DNA复制环节,如环丙沙星抑制细菌拓扑异构酶,结果细菌无法繁殖,被人体免疫消灭。这也提醒我们——过度使用抗生素会促进耐药性进化。
肿瘤治疗靶点
部分肿瘤细胞持续增殖,对DNA合成和损伤应答较为敏感,因此一些药物会干扰核苷酸合成、DNA复制或修复。这类药物也可能影响骨髓和消化道等正常更新组织,疗效与副作用需要结合肿瘤类型、剂量和耐药机制评估。
分子生物学新工具:PCR技术的崛起
聚合酶链式反应(PCR)利用变温循环使DNA解链、引物退火并延伸,从而选择性扩增目标片段。它可用于病原核酸检测、遗传分析和科研实验;结果是否可靠取决于取样时间、样本质量、引物特异性、对照设置和判读阈值。
DNA复制把模板互补、聚合酶合成、校对和修复连接起来。理解这些环节后,可以进一步判断某种药物、变异或检测技术具体作用于哪一步,以及实验结论能够支持到什么程度。
染色体中的DNA包装
从分子到染色体的层级包装
如果把人类细胞中所有的DNA拉成一条直线,总长度约为2米,而细胞核的直径只有几微米。这就像要把2000公里长的细线塞进一个乒乓球里,这是怎么实现的呢?答案就在于DNA的精密包装系统。
组蛋白
真核细胞中的DNA并不是裸露存在的,而是与一类特殊的蛋白质——组蛋白——紧密结合。组蛋白具有以下特点:
高度保守性:牛和豌豆的同类组蛋白仅相差2个氨基酸,这种保守性反映了其重要的生物学功能。
碱性特征:组蛋白富含赖氨酸和精氨酸等带正电的氨基酸,能够与带负电的DNA磷酸基团紧密结合。
DNA包装的组织层次
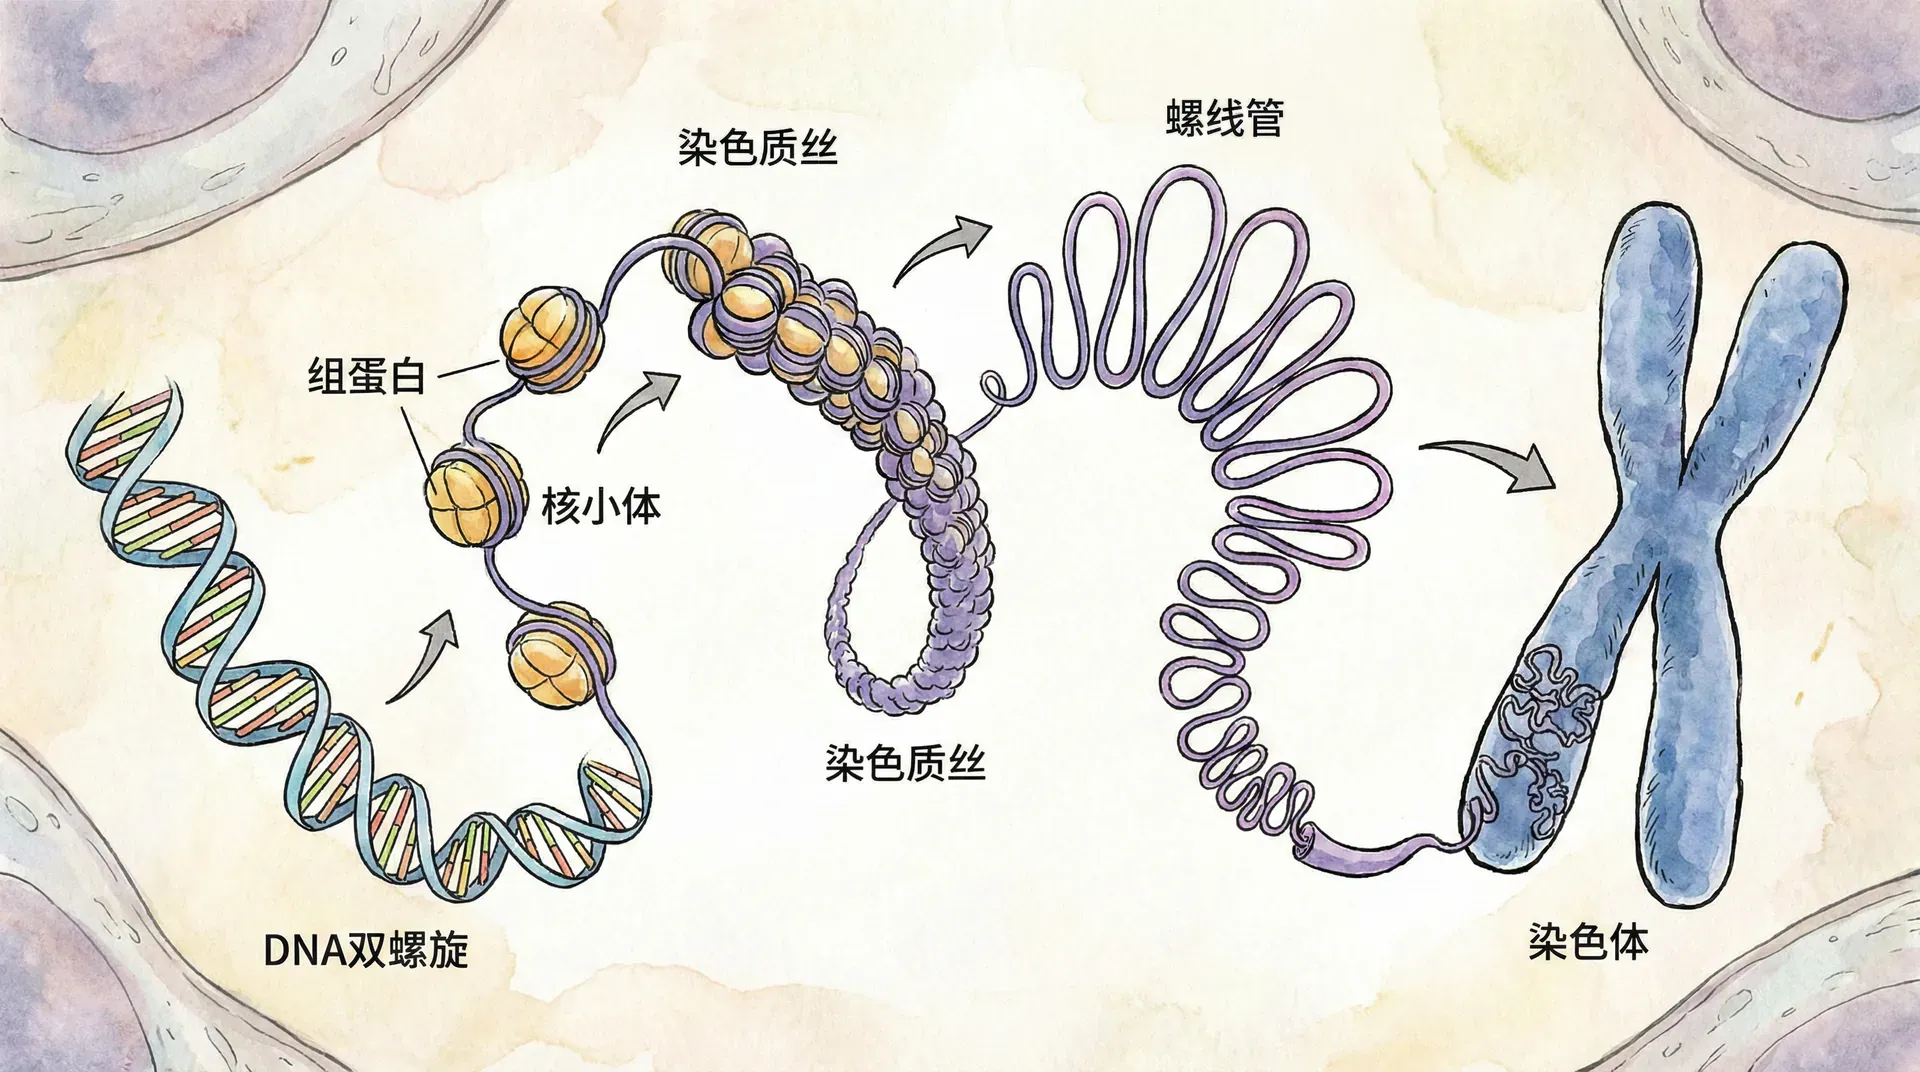
核小体是染色质组织的基本单位,但更高层结构会随细胞类型、基因活动和细胞周期变化,并不总是依次形成统一直径的规则纤维:
核小体结构(10纳米纤维)
DNA双螺旋缠绕在由8个组蛋白分子组成的蛋白质核心上,形成核小体。这种结构在电子显微镜下看起来像“串珠”,每个“珠子”就是一个核小体,“线”就是连接DNA。
核小体之间的折叠
核小体链可以通过组蛋白、连接DNA和其他蛋白质形成多种局部折叠。经典“30纳米纤维”是重要历史模型,但在许多活细胞中并不是普遍、规则存在的固定层级。
染色质环与结构域
染色质可在黏连蛋白、CTCF等因素参与下形成环和接触结构域,使相距较远的调控元件与基因发生空间接触。不同细胞中的边界和接触频率可以变化。
下面的页面用于比较DNA从双螺旋、核小体到染色体的组织状态,重点观察结构关系,而不是把它们视为固定压缩倍数:
异染色质与常染色质
在细胞核中,并不是所有的DNA都处于相同的包装状态。根据凝缩程度和转录活性,染色质可以分为两类:
这种染色质状态的调节对基因表达控制具有重要意义。许多疾病都与染色质结构的异常有关,比如某些智力发育障碍就与组蛋白修饰异常相关。
端粒

线性染色体末端会面临末端复制问题,也需要避免被DNA损伤系统误认为断裂。端粒重复序列及其结合蛋白共同保护染色体末端;在缺少补偿机制的许多体细胞中,端粒会随连续分裂逐渐缩短。
端粒位于染色体末端。人类端粒由TTAGGG重复序列及蛋白质复合物构成,长度在不同染色体、细胞和个体间均有差异。它们抑制末端融合和错误修复,也为复制造成的逐步缩短提供缓冲。
端粒与细胞衰老:端粒过短或保护结构受损时,可触发DNA损伤反应,使细胞进入衰老、凋亡或发生基因组不稳定。机体衰老还涉及代谢、表观遗传、干细胞和组织环境等多种过程,不能只用端粒长度解释。
端粒酶的作用:端粒酶利用自身RNA模板延长端粒,在生殖细胞、部分干细胞和许多癌细胞中活性较高。维持端粒能支持较多轮分裂,却不足以单独赋予细胞无限增殖能力,癌细胞还需获得多种其他改变。
端粒长度可反映部分细胞的复制历史和应激状态,但不同组织差异明显。把端粒酶作为干预靶点时,需要同时评估组织再生、基因组稳定性和肿瘤风险。
总结
DNA成为遗传物质的认识来自逐步积累的实验:转化实验提出问题,成分分离和酶处理锁定DNA,噬菌体同位素追踪提供另一体系的证据,衍射与化学规律约束双螺旋模型,同位素密度实验区分复制模型。每个结论都对应特定方法和证据范围。
结构与功能需要联系起来理解:互补配对支持模板复制,反向平行决定前导链与滞后链的不同合成方式,校对和修复降低错误率,核小体和三维染色质组织则影响DNA何时能够被复制、修复或转录。
使用DNA技术时,应区分“检测到序列差异”“证明分子机制”和“能够改善实际结局”三个层级。它们需要不同的对照、重复和验证方法。
面对PCR、测序、遗传诊断或基因治疗等应用,可以依次追问:样本来自哪里,技术实际测量什么,误差和阴阳性对照如何设置,结果与表型之间有多强的因果联系。这样才能把分子遗传学知识转化为可检验的判断,而不是把DNA当成解释一切生命现象的单一答案。