当一次请求不能及时给出最终答案
上一节我们把订单、库存和支付建模成了资源,也让 HTTP 方法承担了明确语义。如果所有请求都能在几十毫秒内给出最终结果,事情到这里似乎已经很完整了。可一旦把接口放进真实流量里,问题很快会变样:导出十万条订单迟迟没有结束,两名客服几乎同时取消同一订单,Webhook 没有及时收到确认而再次投递,促销开始后的几秒钟里,请求量也突然变成平时的几十倍。
它们看似是四类事故,背后其实有同一个矛盾:客户端希望立刻得到一个确定答案,系统此刻却只能给出“已经接住”“版本已经变化”或“请稍后再来”这样的中间事实。 这时最危险的做法,是继续假装一次远程调用和一次本地函数调用一样干净,因为超时不等于失败,收到请求不等于完成,重复通知也不等于业务发生了两次。这一节我们就把这些不确定性变成客户端可以理解、服务器可以追踪的资源和协议。
先承认:现在没有最终答案
先看一个很常见的接口:运营人员点击“导出订单”,服务器需要查询数据、生成文件、上传对象存储,整个过程可能持续几十秒。如果我们让请求一直挂着,浏览器、反向代理、网关和负载均衡器都要陪它一起等;任何一层先超时,客户端看到的都只是“请求失败”,但后台任务可能仍在继续。
用户以为第一次导出失败,于是再次点击,第二个任务也被创建;几分钟后,两个几乎相同的文件都生成了,服务器却认为两次都成功。这不是把超时时间调大一点就能彻底解决的问题:任务今天需要 20 秒,数据量上来后可能需要 3 分钟,而五分钟的网关超时只会占住更多连接,并让异常更晚暴露。
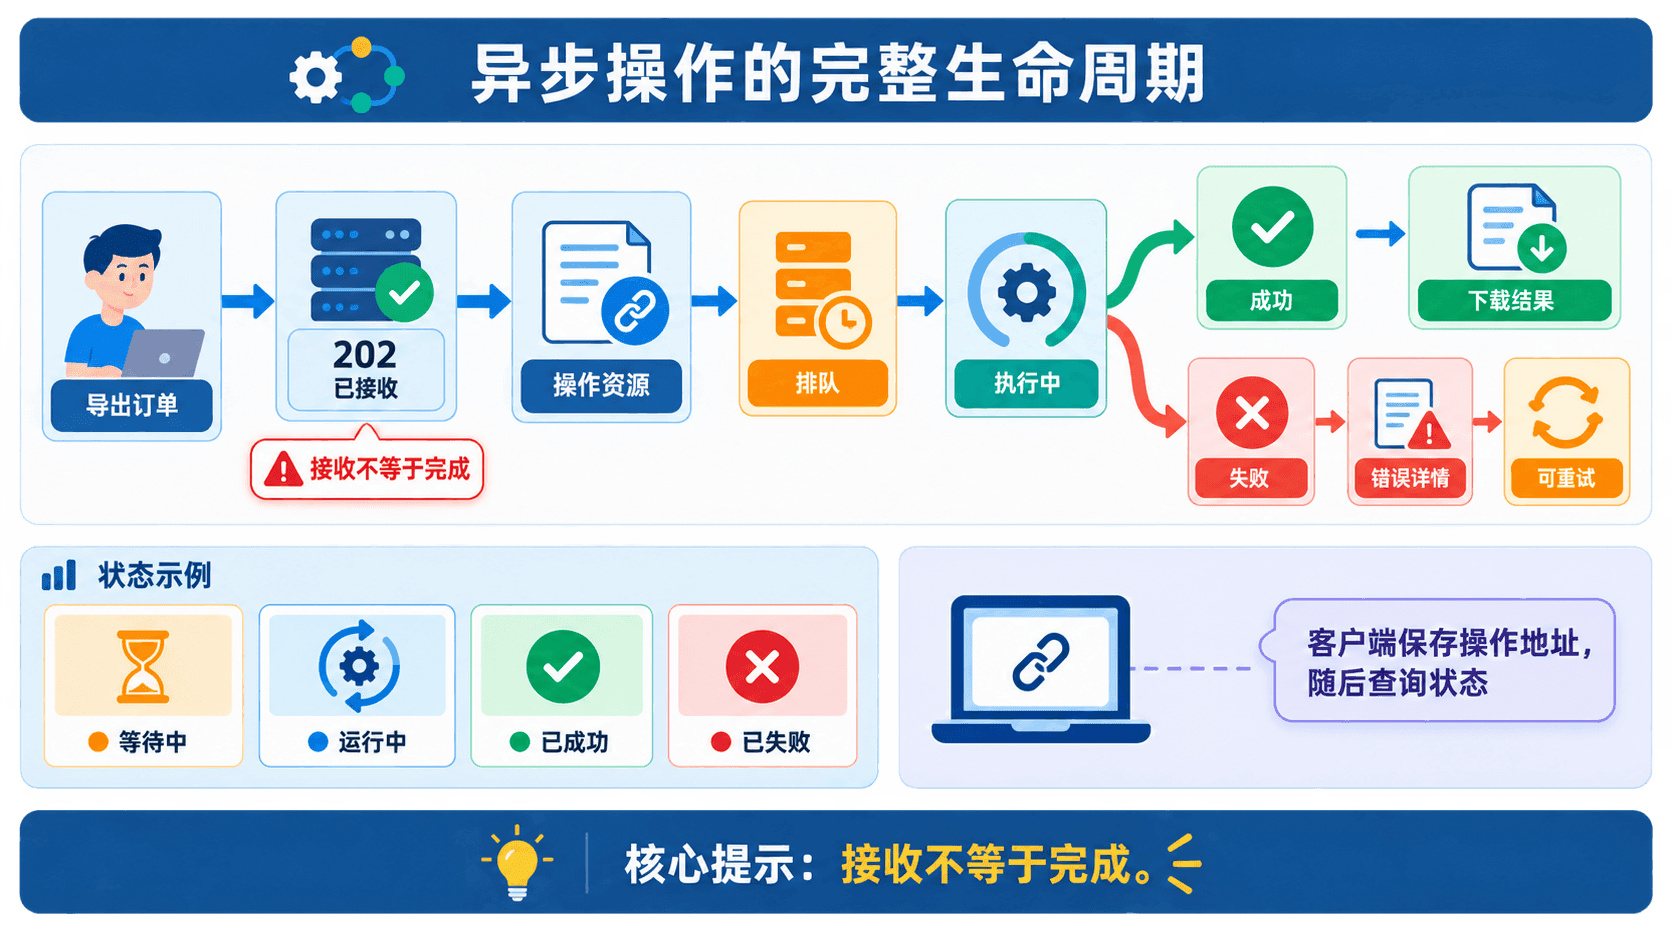
更诚实的接口要先把“已经接收”和“最终完成”拆成两个判断,这两个判断不能压成一个模糊的成功状态。也就是说,响应要明确区分提交结果与任务结果。具体包括下面两个事实:
- 提交是否已经被服务器接受;
- 任务最终是否成功。
HTTP 的 202 Accepted 正好表达第一个事实。它只说明请求已经被接收并准备处理,不承诺处理一定成功,也不承诺此刻已经开始执行;最终结果必须通过后续机制另行确认。
202 不是“晚一点返回的成功”,更不是把所有超时操作统一改成异步的装饰性状态码。服务器如果返回 202,就必须再给客户端一条可追踪的路径,否则客户端只得到一句“我收到了”,却永远无法知道后来发生了什么。
用 Operation 资源接住未完成的工作
比较稳妥的设计,是把“这次导出正在进行”本身建模成一个资源。它可以叫 operation、job 或 task,名字并不关键,关键是它有稳定标识、明确状态和完整生命周期。教学项目把它叫作操作资源,客户端从下面这次请求开始创建订单导出任务:
http
POST /api/order-exports HTTP/1.1
Authorization: Bearer demo-admin-token
Content-Type: application/json

{}
订单服务不会等文件生成才回答,而是先创建 op-0001,把“工作已被接住”作为当前结果返回。客户端从一开始就会知道这不是下载结果,此时最重要的是后续能够定位这项工作的入口。完整响应如下:
http
HTTP/1.1 202 Accepted
Location: /api/operations/op-0001
Retry-After: 1
Content-Type: application/json

{
  "id": "op-0001",
  "type": "ORDER_EXPORT",
  "status": "RUNNING",
  "result": null,
  "links
这份响应有三层彼此配合的信息,缺一层都会让接口变得含糊。状态码 202 提醒客户端不要把当前响应当作导出结果;Location 给出后续查询地址,经过网关后外部客户端只会看到 /api/operations/op-0001;响应体则让界面立即显示“正在执行”,并把操作 ID 留作排障线索。
接下来,客户端沿 Location 读取操作资源,而不是猜测内部服务地址。这一次 GET 只读取已有任务,不会再次创建导出。在一份刚启动、还没有创建订单的内存数据上,后台完成后会得到下面的状态和结果:
http
GET /api/operations/op-0001 HTTP/1.1
Authorization: Bearer demo-admin-token
json
{
  "id": "op-0001",
  "type": "ORDER_EXPORT",
  "status": "SUCCEEDED",
  "result": {
    "downloadUrl": "/downloads/op-0001.json",
    "orderCount": 0
  },
  "links": {
    "
现在,“导出”不再是一条必须等到最后的连接,而是两次资源交互:先创建操作,再读取操作。连接可以早早释放,任务的进度和结果仍然留在一个稳定资源上。
状态机比进度百分比更重要
一个可用的操作资源不能只有“处理中”这个模糊值,否则失败、取消和尚未调度都会挤在一起。状态既要指导客户端动作,也要支持后台告警和恢复。具体至少要区分下面几种情况:
text
QUEUED -> RUNNING -> SUCCEEDED
                  -> FAILED
       -> CANCELLED
QUEUED 表示任务已经持久化但还没拿到执行资源,RUNNING 表示执行器已经接手,SUCCEEDED 和 FAILED 则是终态。至于是否允许从排队或执行中进入 CANCELLED,要看执行过程能不能安全停止,不能只因为界面想放一个取消按钮就承诺支持。
进度百分比反而不一定可靠。生成文件有“查询”“序列化”“上传”三个阶段,而查询占总耗时多少通常无法预先知道;随意从 10% 跳到 90%,只会让界面看起来很忙。能准确计算时可以返回 processedItems 和 totalItems,不能计算时就坦率地返回阶段名和最近更新时间;失败时也不要只留一个 FAILED,还要给出可判断的原因:
json
{
  "id": "op-0002",
  "status": "FAILED",
  "error": {
    "code": "EXPORT_STORAGE_UNAVAILABLE",
    "detail": "导出文件暂时无法写入存储服务"
  },
  "links": {
    "self": "/api/operations/op-0002",
    "
错误码用于程序判断,detail 用于解释这一次为什么失败。两者分开后,客户端既能稳定决定是否展示“重试”,也能把具体情况说给用户听,不必解析一段随时可能改写的文字。
任务资源也有生命周期成本
只要把任务变成资源,就必须管理它从创建到清理的完整生命。这些答案会直接影响存储规模、恢复能力和客户端体验。设计时应先回答下面这批同步接口通常不用面对的问题:
- 已完成任务保留多久;
- 下载链接何时失效;
- 客户端能否取消;
- 服务重启后任务记录是否还在;
- 同一个导出请求重复提交时,是复用任务还是再建一个;
- 执行器崩溃后,谁把长期停在
RUNNING的任务重新放回队列。
这些不是边角料。一个只存在内存里的操作资源很适合课堂演示,但在生产系统里,任务状态通常要持久化,领取任务还要有租约、心跳或可恢复的消息机制。换句话说,202 没有消灭耗时,只是把“连接等待的复杂度”换成了“任务生命周期的复杂度”。
轮询和回调,解决的是两种等待方式
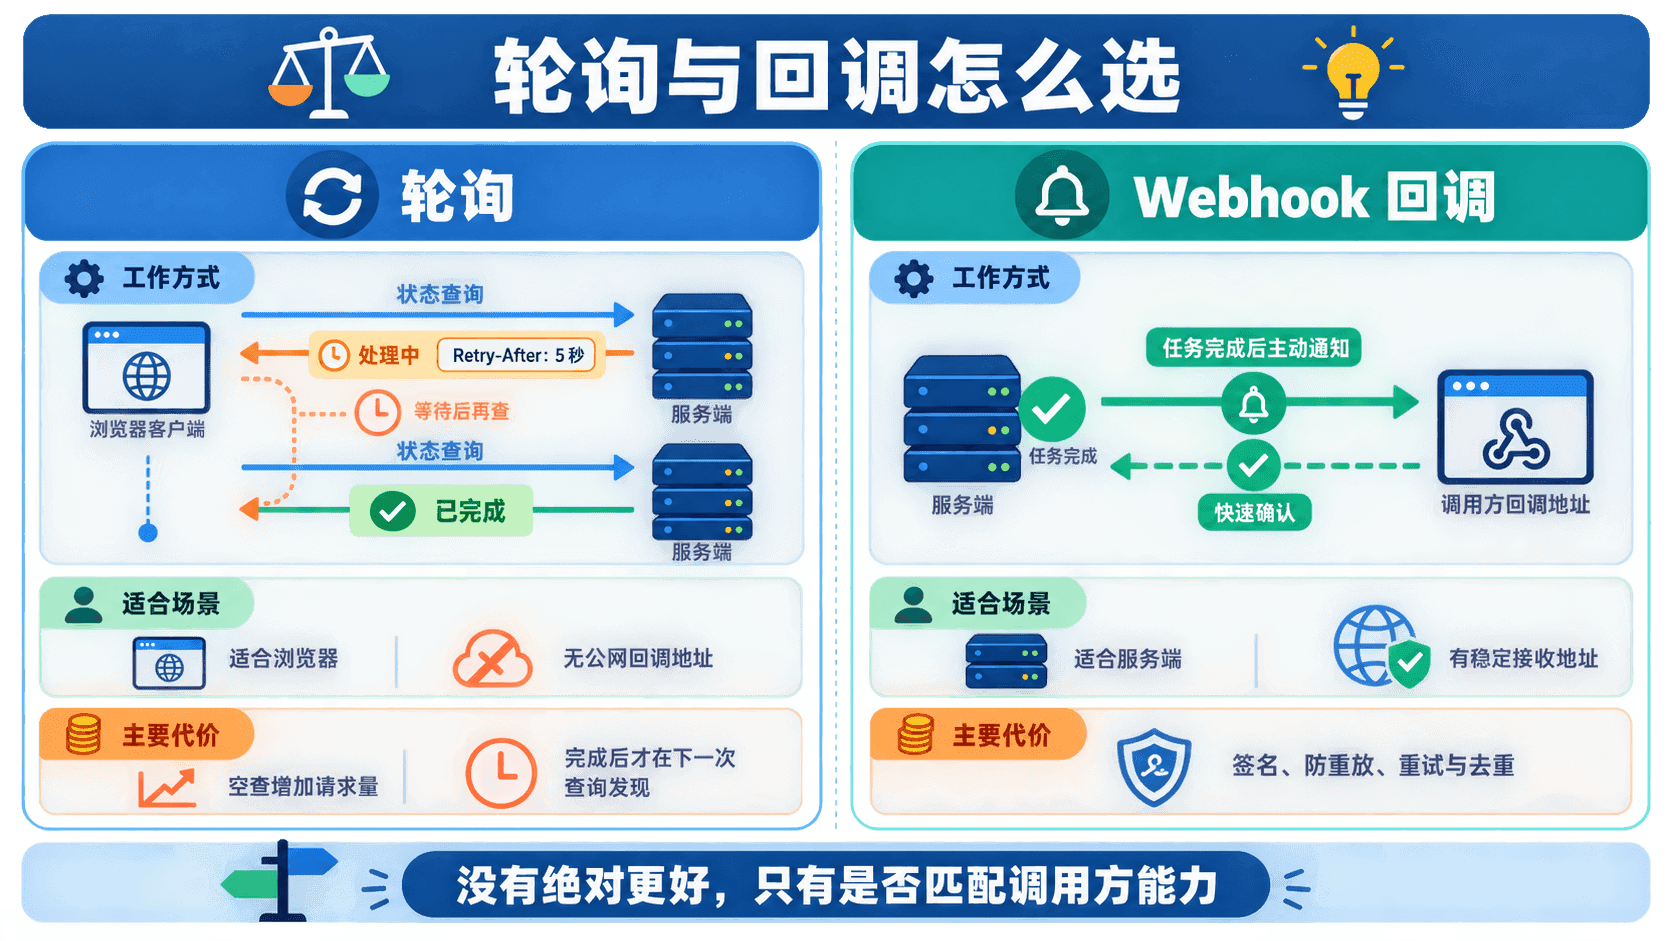
创建了操作资源,客户端接下来还要知道它什么时候结束。最常见的选择是轮询和回调,两者传递的是同一个状态变化,只是由哪一方主动发起下一次网络请求不同。
轮询:简单,但要有节奏
轮询适合浏览器、移动端和无法暴露公网接收地址的客户端,因为它不要求服务器主动访问客户端,失败模型也容易理解。它的问题不在“查询”本身,而在没有节奏地查询。最朴素的实现经常写成下面这样:
js
while (true) {
  const operation = await getOperation(operationUrl);
  if (operation.status === 'SUCCEEDED') break;
  await sleep(100);
}
一百个用户各自每 100 毫秒查询一次,就是每秒一千次状态读取。真正做导出的工作也许只占很少资源,查“做完了吗”反而把服务压垮。教学项目因此在 202 响应里返回 Retry-After: 1,建议客户端至少等一秒再发后续请求;这个字段既可以是秒数,也可以是一个 HTTP 日期,客户端要按接口约定解析。
仅仅把固定间隔从 100 毫秒改成一秒还不够,客户端还要处理持续运行、失败和用户离开页面等情况。否则请求频率虽然降了,结束条件和恢复方式仍然含糊。一个完整的轮询过程应当做到:
先读取 Location,把它当作服务端给出的后续入口,不要自己拼接操作 URL。
优先采用响应里的 Retry-After;没有时,从一个温和的默认间隔开始。
连续未完成时逐步拉长间隔,并加入少量随机抖动,避免许多客户端同时醒来形成新的尖峰。
遇到 SUCCEEDED、FAILED 或 CANCELLED 就停止;超过用户可以接受的总等待时间,也要停止前台轮询,但可以保留任务入口。
下面是一段更接近实际使用的客户端逻辑。当前接口约定 Retry-After 使用秒数,所以这里没有展开 HTTP 日期的解析。把格式边界写清楚后,示例才不会暗示客户端已经支持所有形式:
js
async function waitForOperation(location, token) {
  let delayMs = 1000;

  for (let attempt = 0; attempt < 20; attempt += 1) {
    await sleep(delayMs + Math.floor(Math.
前台停止等待不等于后台任务失败,两者属于不同生命周期。界面应提示“任务仍在后台运行”,保留操作入口,让用户稍后从导出记录里回来查看,而不是把前台超时显示成导出失败。
回调:及时,但要求双方都像服务器
回调适合服务对服务集成:订阅方提供一个 HTTPS 地址,任务完成后由提供方主动发送事件。它减少了空轮询,也能更快通知完成,但浏览器和普通移动应用没有稳定的公网入口,企业网络还可能禁止外部系统回连。因此,轮询与回调不是“落后”和“先进”的关系,而是对客户端网络能力和运维条件的不同选择:
- 面向普通终端用户,轮询往往更容易落地;
- 面向有稳定服务端的合作方,Webhook 更节省长期查询;
- 对关键业务,常常两者都保留:Webhook 负责及时通知,操作资源负责查漏补缺和人工排障。
Webhook 不是“反过来调一次接口”这么简单
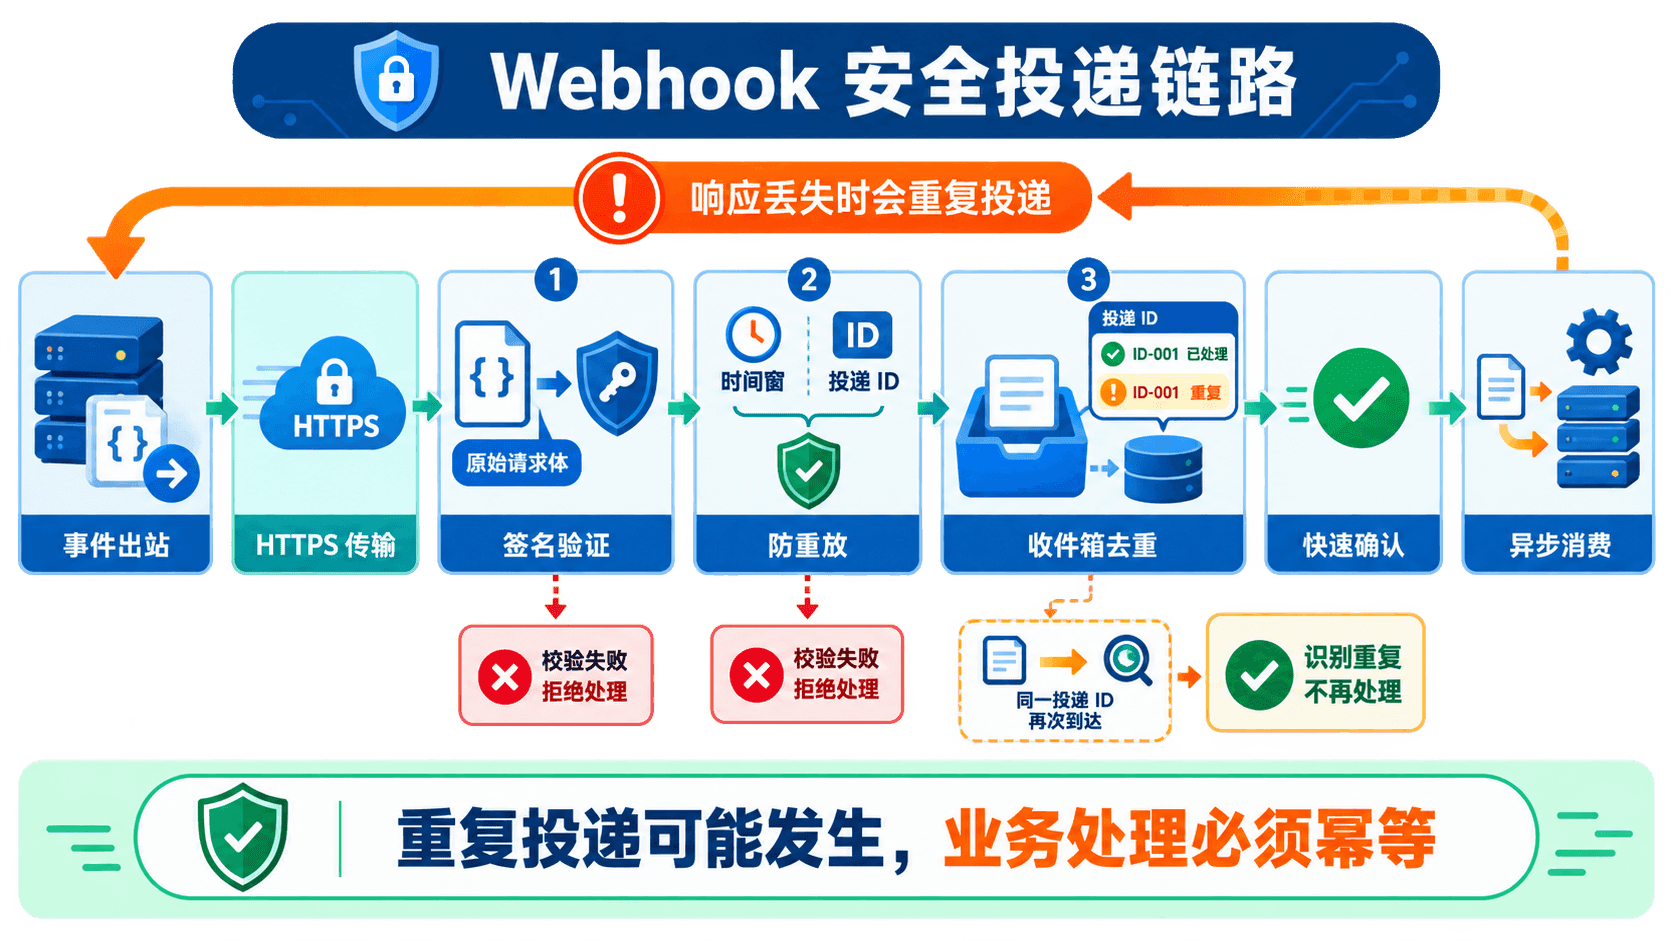
假设订单导出完成后,系统向合作方发送 order-export.succeeded。第一次投递已经到达,对方也把文件入库了,但确认响应在网络上丢失;发送方只看到超时,无法判断“对方没收到”还是“对方处理完了但确认丢了”,于是只能重试。如果第二次投递到达时合作方再次入库,重复数据就这样产生了。
这和前面“支付已经成功但回执丢失”是同一种不确定性,网络无法提供神奇的“只送一次”。工程上通常选择至少一次投递:发送端没有收到确认就重试,宁愿让同一个事件出现多次,也尽量不让它悄悄丢失;接收端再通过去重,让业务效果只发生一次。不过“至少一次”也不是无限期保证,重试超过保留期、订阅被停用或双方数据损坏时,事件仍可能无法送达,所以发送端还要保存投递历史,并提供查询和人工重放入口。
把订阅也建模成资源
Webhook 不应该只是一张藏在后台的 URL 配置表,否则调用方看不到订阅状态,也没有稳定入口处理暂停、轮换和删除。把订阅本身建模成资源后,生命周期变化就能进入同一套 HTTP 语义,双方也有共同的排障对象。订阅结构如下:
http
POST /api/webhook-subscriptions HTTP/1.1
Content-Type: application/json

{
  "targetUrl": "https://partner.example/webhooks/order-exports",
  "eventTypes": ["order-export.succeeded", "order-export.failed"]
}
json
{
  "id": "whsub-0172",
  "status": "PENDING_VERIFICATION",
  "eventTypes": ["order-export.succeeded", "order-export.failed"],
  "links": {
    "self": "/api/webhook-subscriptions/whsub-0172",
    "verify": "/api/webhook-subscriptions/whsub-0172/verification"
  }
}ACTIVE、PAUSED、FAILING 和 DISABLED 等状态能把运维事实公开出来。订阅方可以看到最近一次成功投递时间、连续失败次数和下次重试时间,而不是等数据丢了才猜;发送方也能据此暂停持续失败的目标,避免无休止地消耗投递资源。
目标 URL 还必须验证控制权和可访问范围。否则攻击者可以注册不属于自己的内网地址或第三方地址,让平台替他扫描内网、攻击别人,甚至不断请求一个会返回巨大响应的目标。因此,发送方至少要限制协议为 HTTPS,拒绝本机、内网和云元数据地址,解析后再次核对目标 IP,并给连接时间、响应大小和跳转次数设上限。
事件信封要为去重和追踪服务
一个容易处理的事件不能只有业务对象,还要带上这件事是什么、何时发生以及如何去重。把传递信息和订单导出数据分开后,接收方无需猜测每种业务载荷的公共字段。一种清晰的事件信封如下:
json
{
  "eventId": "evt-8f7c2a",
  "eventType": "order-export.succeeded",
  "occurredAt": "2026-08-18T10:24:31Z",
  "resource": {
    "type": "order-export",
    "id": "op-0001"
  },
  "data": {
    "
eventId 标识同一件业务事实,接收方用它去重;如果发送方还需要区分每次网络尝试,可以另加 deliveryId。同一个事件重投时,eventId 保持不变,deliveryId 可以变化,这样排障时既能看出“哪件事重复了”,也能区分“第几次网络投递”。
接收方拿到事件后,不要先做耗时业务,而应先在数据库里写入具有唯一约束的收件箱记录。唯一键把去重判断和事件落库放进同一个原子操作,从而避免两个并发请求同时通过“是否存在”的查询。下面的 SQL 就表达了这层约束:
sql
INSERT INTO webhook_inbox(event_id, received_at, payload)
VALUES ('evt-8f7c2a', CURRENT_TIMESTAMP, :payload)
ON CONFLICT (event_id) DO NOTHING;
插入成功后,接收端才把事件交给异步消费者;发生唯一键冲突,说明之前已经收过,可以直接返回成功。这样发送方的重试不会再次触发导入、发券或记账。不过,“去重表里有 eventId”只说明事件曾被接收,如果收件箱已经提交而真正的业务事务失败,系统还需要一个可重试的消费状态,不能把 RECEIVED 当作 PROCESSED。
签名验证必须覆盖原始字节
HTTPS 保护传输通道,请求签名则让接收方验证消息来自持有共享密钥的一方,而且正文没有被替换。常见做法是把时间戳与原始请求体拼接,再用 HMAC-SHA256 生成签名。时间戳必须进入待签名内容,否则攻击者可以单独篡改它:
text
待签名内容 = 时间戳 + "." + 原始请求体字节
签名 = HMAC-SHA256(订阅密钥, 待签名内容)
为什么强调“原始字节”?因为 JSON 解析后再序列化,字段顺序、空格和转义形式都可能变化;业务含义仍然一样,字节却已经不同,重新计算的签名自然对不上。因此,接收框架必须在 JSON 解析之前保留请求体,Node.js 接收端可以按下面的顺序完成时间窗与签名检查:
js
import { createHmac, timingSafeEqual } from 'node:crypto';

function verifyWebhook({ rawBody, timestamp, signature, secret }) {
  const now = Math.floor(Date.now() / 1000);
  if (Math
时间窗缩短了合法请求被截获后的可重放时间,恒定时间比较则降低从比较耗时推断签名的风险。验证通过后仍要检查 eventId,因为签名正确只证明来源和内容可信,不代表这是第一次收到。密钥也要支持轮换,可以在签名头中携带密钥版本,短暂过渡期同时接受新旧密钥,等积压投递清空后再撤掉旧密钥。
先确认收到,再慢慢处理
Webhook 接收端不应该在一次 HTTP 请求里完成下载文件、解析数据、写多张表和发送通知这一整串工作。正确顺序通常是验证签名、检查时间窗,把事件可靠写入收件箱或队列,快速返回 2xx,再由后台消费者处理。如果接收方同步处理 20 秒才返回,发送方可能在第 10 秒就判定投递失败并安排重试,而原来的业务还在继续,重复处理便会出现。
不要先返回 2xx,再尝试把事件写入一个可能失败的内存队列。确认响应代表接收方已经承担了保管责任。至少要先把事件写进可恢复的存储,确认才有意义。
即使每次都成功确认,投递仍可能乱序,export.succeeded 不一定永远晚于 export.started 到达。接收方需要根据资源版本、发生时间或当前状态判断事件是否仍然适用,不能把网络到达顺序直接当作业务发生顺序。
两个人同时取消订单:谁覆盖了谁
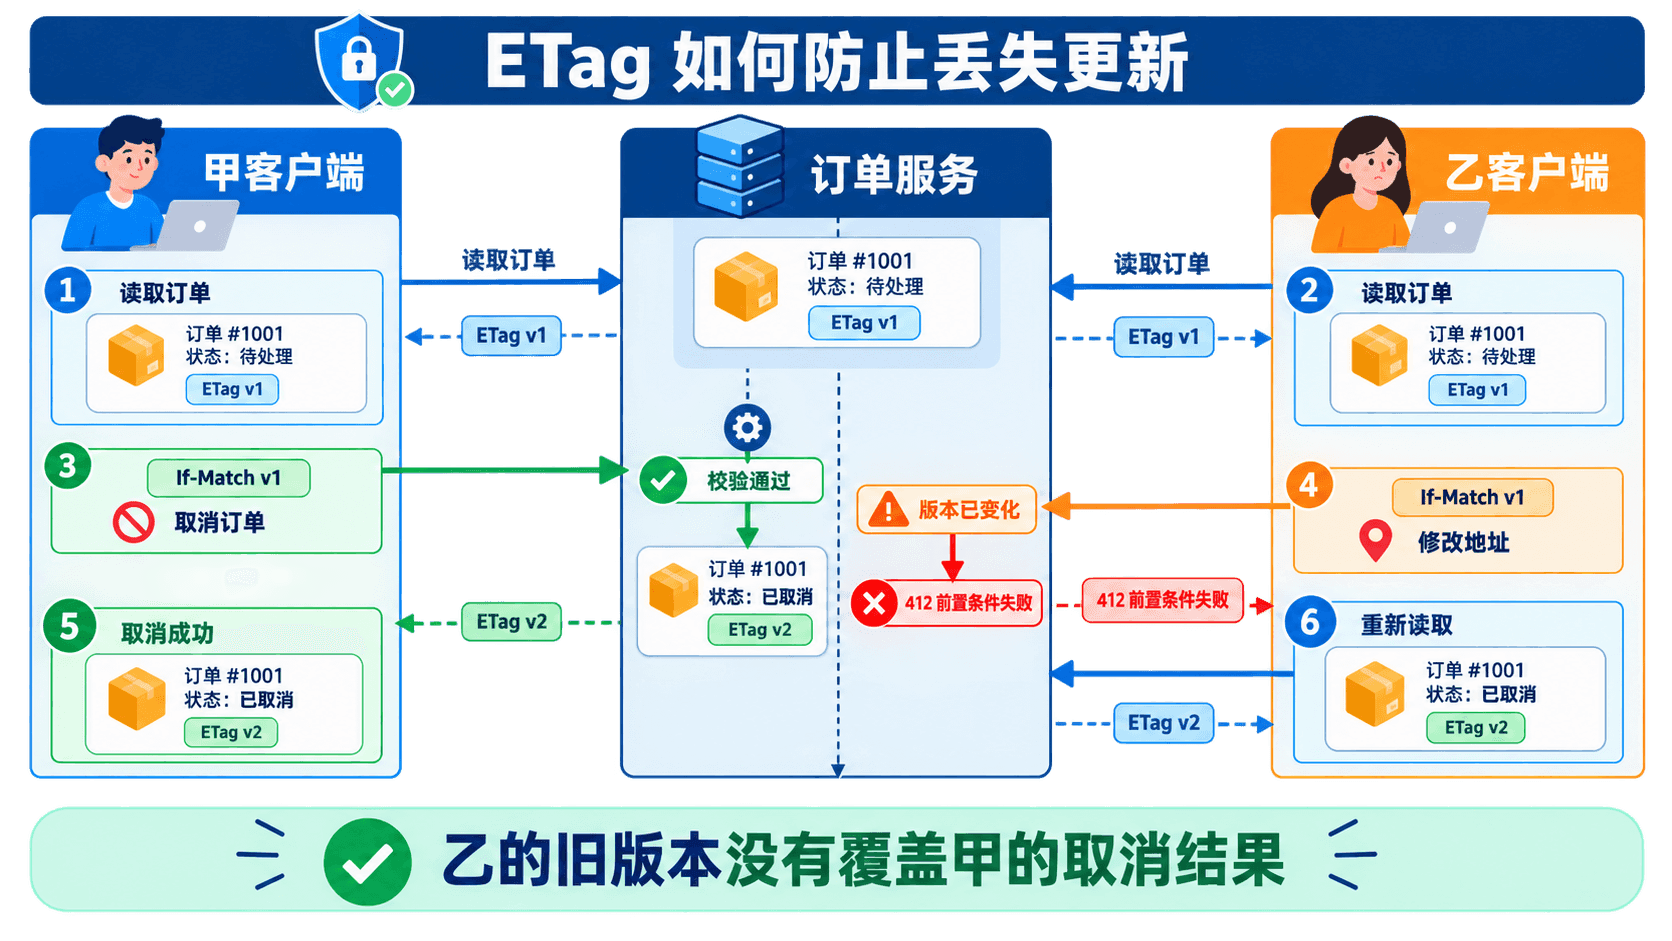
异步任务处理的是“结果还没出来”,条件请求处理的是另一种不确定性:我手里的资源版本还是最新的吗? 假设客服甲和客服乙几乎同时打开订单 ord-0001,他们各自拿到一份可以独立修改的页面。两份页面读取时看到的都是下面这个版本:
http
HTTP/1.1 200 OK
ETag: "v1"
Content-Type: application/json

{
  "id": "ord-0001",
  "status": "COMPLETED",
  "version": 1
}
两个人都以为自己面对的是当前状态,但甲先一步提交了取消。为了表明“只在订单仍是我刚才看到的版本时修改”,请求同时带上读取时拿到的 ETag。这个条件把甲做决定时的上下文一并交给服务器:
http
PATCH /api/orders/ord-0001 HTTP/1.1
If-Match: "v1"
Content-Type: application/json

{
  "status": "CANCELLED"
}
服务端检查当前 ETag 仍是 "v1",于是执行退款、释放库存,并把订单版本更新为 "v2"。乙随后还拿着旧的 "v1" 提交,这个版本已经不能代表服务器现状。服务端不能因为请求格式正确就再执行一次,而要拒绝已经失效的前置条件:
http
HTTP/1.1 412 Precondition Failed
ETag: "v2"
Content-Type: application/problem+json

{
  "code": "VERSION_CONFLICT",
  "title": "资源版本冲突",
  "detail": "当前 ETag 是 \"v2\",请重新读取订单。"
}
这就是 If-Match 的价值:它把“仅当资源仍是我读到的那一版时才修改”写进 HTTP 请求。没有它,最后到达的写入会悄悄覆盖先到的写入;数据库本身可能完全正常,两次更新也都提交成功,但第一位用户的判断已经被第二位用户的旧视图覆盖。这类错误叫丢失更新,最麻烦的地方就在于它通常没有异常日志。
为什么是 412,不是笼统的 409
409 Conflict 表达当前资源状态与请求存在冲突,适合“已发货订单不能取消”这类业务规则;412 Precondition Failed 更具体,说明客户端发送的 If-Match 条件没有成立。看到 412,客户端就知道要重新读取最新版本,再决定合并还是放弃。教学项目还要求取消请求必须携带 If-Match,完全没提供前置条件时返回 428 Precondition Required,明确拒绝盲写:
js
if (!req.headers['if-match']) {
  throw new HttpError(
    428,
    'PRECONDITION_REQUIRED',
    '缺少前置条件',
    '取消订单时必须用 If-Match 带上最新 ETag。'
  );
}

if (req.headers['if-match'] !== currentEtag) {
  throw new HttpError(
冲突后不要不看内容就自动重试
收到 412 后,客户端可以自动重新 GET,但不能总是把原来的 PATCH 无脑再发一遍。如果甲把收货地址从北京改成上海,乙只改了联系电话,客户端也许能够安全合并;可如果两个人都改了地址,机器不能替用户决定保留哪一个。取消订单更明显,最新状态可能已经是 SHIPPED,重新提交取消不再合法,客户端应展示最新状态并让用户重新确认。
ETag 也不必一定是内容哈希,数据库版本号、递增修订号都可以生成稳定标签。用于 If-Match 防并发覆盖时,它必须能对表述变化做强比较;如果使用一个只表示“差不多相同”的弱验证器,就无法承担写入保护的责任。
同一个 ETag,也能让没变化的数据不再重传
ETag 的另一种用法是条件读取,它要回答的不是“能不能写”,而是“内容有没有变化”。客户端第一次读取订单时会同时拿到正文和 ETag: "v1",过一会儿需要刷新时,不必直接要求服务器重传完整内容。这个请求仍然使用 GET,只是带上已有标签作为判断条件:
http
GET /api/orders/ord-0001 HTTP/1.1
If-None-Match: "v1"
服务器把请求中的标签与当前表述比较。如果订单仍然是这一版,就不再生成相同正文。客户端此时收到的是一个只说明“没有变化”的响应:
http
HTTP/1.1 304 Not Modified
ETag: "v1"
304 没有新的响应体,客户端要继续使用先前缓存的那份 200 响应正文,只更新必要的缓存元数据。教学项目的条件 GET 测试正是按这个过程验证:先保存创建订单时返回的 ETag,再用 If-None-Match 读取同一订单,并断言状态码为 304。
js
const response = await api(`/api/orders/${firstOrder.id}`, {
  headers: { 'if-none-match': firstEtag },
});
assert.equal(response.status, 304);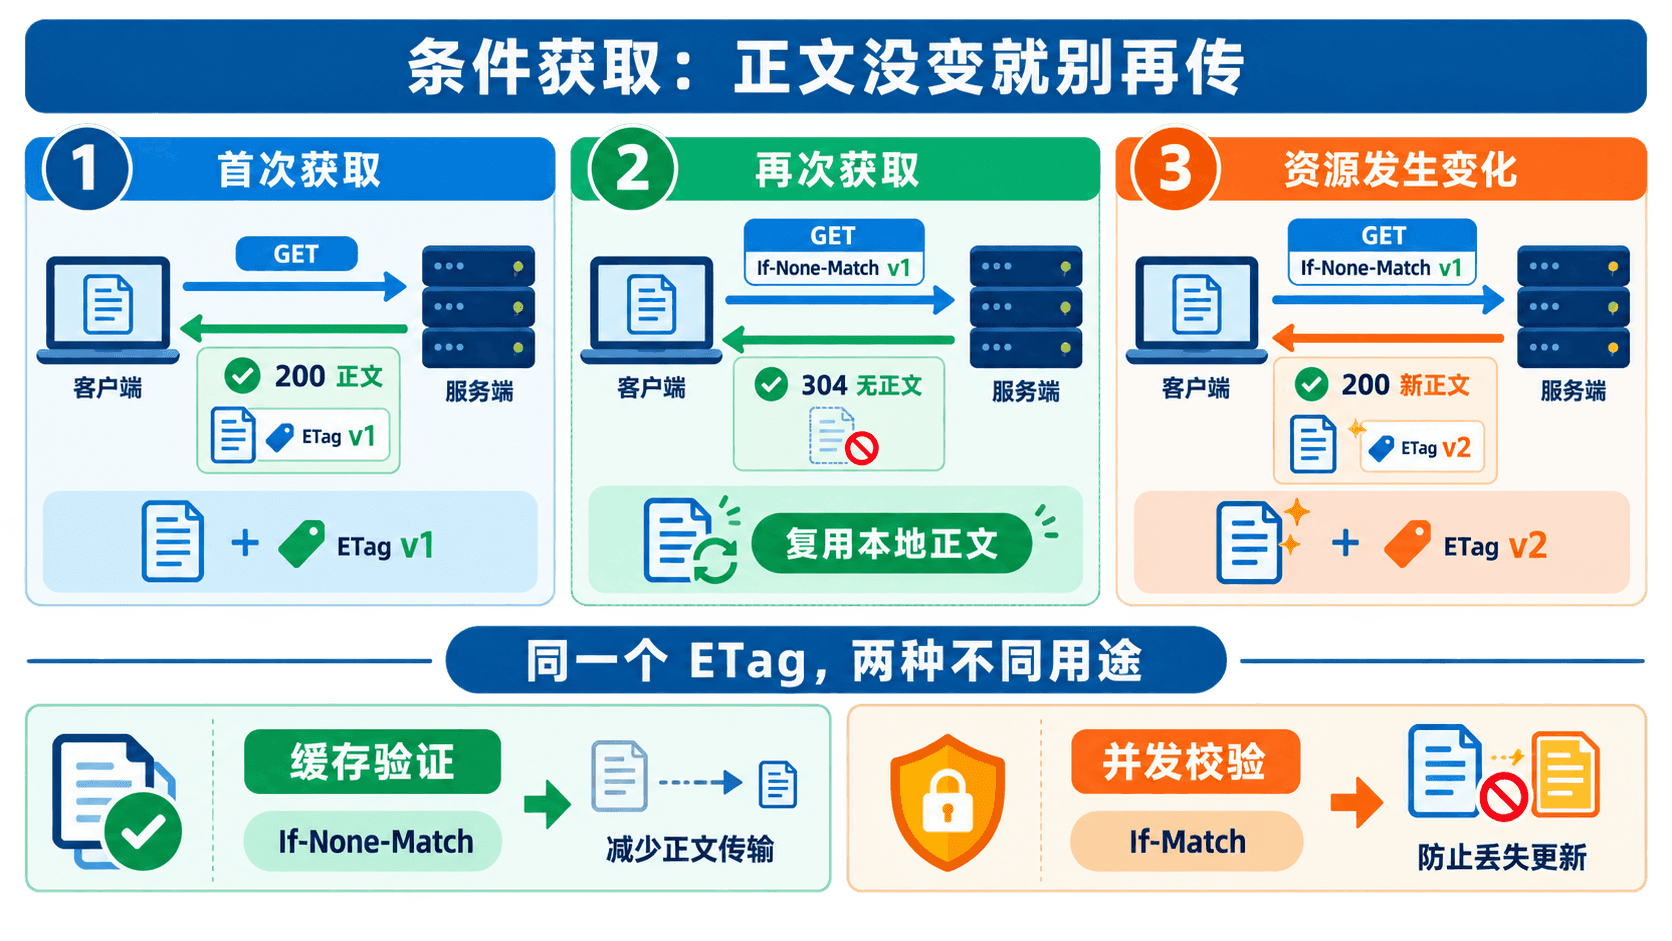
两个条件头不要混用
If-Match 的语气是“只有还等于这一版,才执行修改”,If-None-Match 的语气则是“如果还是这一版,就不用再发正文”。前者主要保护写入,后者主要减少重复传输;它们都使用 ETag,但客户端必须根据操作意图选择,不能因为名字相近就互换。
缓存是否真的可以复用,还取决于 Cache-Control、认证信息和共享缓存策略,仅仅返回 ETag 不等于任何中间代理都能放心缓存私有订单数据。对含用户隐私的响应,可以让浏览器做私有缓存并使用条件请求;对绝不能落盘的敏感响应,则应采用更严格的缓存策略,不能为了拿到 304 就把安全边界一起放松。
流量突刺时,服务器也可以明确说“现在不行”
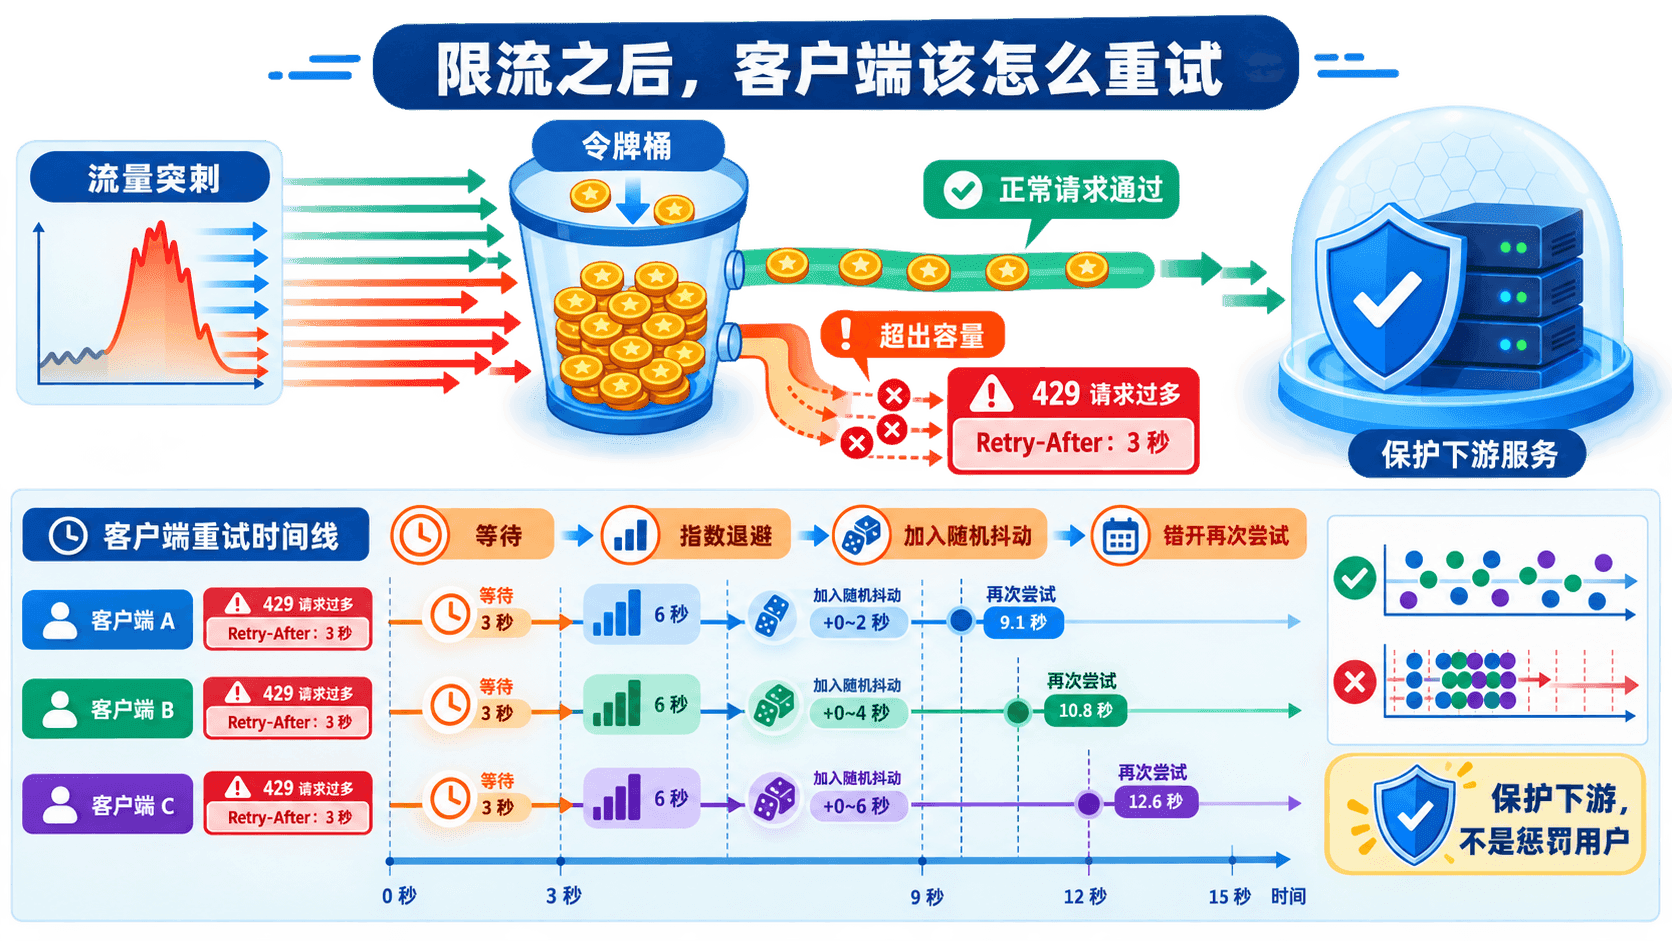
促销开始时,订单查询可能在一秒内涌入几千次。服务如果来者不拒,连接池、线程池或数据库连接会先耗尽,随后连健康检查和管理请求也无法完成。限流的目的不是惩罚调用者,而是在容量有限时保住系统的可预测性:明确拒绝一部分请求,让客户端知道何时再试,总比让所有请求一起等到超时更可控。
教学项目的网关按客户端 ID 维护一个一秒窗口,每秒允许 12 个请求。当前窗口里的第 13 个请求不会继续进入订单或库存服务,这样下游容量就不会被已经判定超额的流量占用。客户端会在入口处得到下面的响应:
http
HTTP/1.1 429 Too Many Requests
Retry-After: 1
X-RateLimit-Limit: 12
X-RateLimit-Remaining: 0
Content-Type: application/problem+json

{
  "code": "RATE_LIMIT_EXCEEDED",
  "title": "请求过于频繁",
  "detail": "每个客户端每秒最多发送 12 个请求。"
}
429 说明当前调用方在某个时间范围里发送得太多,Retry-After: 1 则建议至少等一秒再试。X-RateLimit-* 这组名字在许多接口中都能看到,但不同服务器对重置时间和计数范围的定义未必相同,因此字段是否返回、时间值是时间戳还是剩余秒数,都应该写进接口契约。
客户端退避不能只写一个 sleep
如果十万个客户端同时收到 Retry-After: 1,一秒后又整齐地发起请求,服务器只会迎来第二个波峰。因此,客户端不能把服务器建议理解成精确的统一闹钟,真正目标是把重试分散到一段时间内。指数退避和随机抖动可以这样配合:
js
function nextDelayMs({ retryAfterSeconds, attempt }) {
  const serverFloor = retryAfterSeconds * 1000;
  const exponential = Math.min(500 * 2 ** attempt, 30000);
  const jitter = Math.floor(Math.random
这里的随机抖动是为了让客户端错开时间,最大尝试次数或总等待上限则负责给重试设终点;如果无限重试,一次容量问题就会变成永久后台流量。对于非幂等操作,自动重试前还必须确认服务器有幂等键或其他去重机制,否则一次因为 503 或连接断开而发起的重试,仍可能把同一业务做两次。
限流放在哪里,没有唯一答案
网关适合做统一的身份级、租户级和入口级限流,因为它最早看到外部流量,也能在请求进入下游前拒绝。不过业务服务仍需要按真实成本保护自己,例如订单导出远比读取单个订单昂贵,即使入口总请求数不高,十个并行大导出也可能耗尽数据库。
因此常见做法是两层保护:网关控制整体流量,服务控制自己的并发和队列长度。固定窗口实现简单,但窗口交界处可能短时间通过双倍流量;令牌桶允许有限突发并控制长期速率;并发上限更适合昂贵的长任务。选择算法前,要先说清楚真正想保护的是请求次数、并发数,还是数据库工作量。
链接的实际价值,是公开“现在能做什么”
HATEOAS 经常被讲成一个很宏大的目标:客户端从入口开始,完全依靠超媒体发现整个 API。真实项目里,更务实的用法是让响应携带少量有业务意义的链接,尤其公开那些会随资源状态变化的下一步动作。教学项目里的订单表述会始终给出 self、items 和 collection,但只有状态为 COMPLETED 时才给出 cancel:
js
links: {
  self: `/orders/${order.id}`,
  items: `/orders/${order.id}/items`,
  collection: '/orders',
  ...(order.status === 'COMPLETED'
    ? { cancel: `/orders/${order.id}`
这比在前端复制一份“什么状态可以取消”的判断更可靠。订单已经取消后,响应里不再出现 cancel,客户端可以隐藏按钮,也可以把缺少链接当作重新读取状态的信号。操作资源同样适合这样做:执行中给 self 和 cancel,成功后给 result 或 download,失败后给 retry,把状态机允许的出口直接放进当前表述。
json
{
  "id": "op-0001",
  "status": "SUCCEEDED",
  "links": {
    "self": "/api/operations/op-0001",
    "result": "/api/order-exports/op-0001/file"
  }
}
不过,链接不能替代契约,客户端仍然要知道 result 表示什么、响应是什么结构、错误怎样处理。OpenAPI 适合描述稳定的输入输出和安全要求,运行时链接则告诉客户端这一个资源此刻有哪些入口,两者承担的是互补职责。
完全通用的超媒体客户端实现成本很高,移动端和普通 Web 前端也未必有对应工具。对内部、稳定、只有一个前端的接口,硬做一整套超媒体类型可能得不偿失;分页的 next、任务的 self、状态相关的 cancel,往往已经能拿到最有价值的部分。
链接是一种“服务器给客户端的下一步提示”,不是授权凭证。响应里出现 cancel,服务端仍然必须验证调用者身份、权限、当前 ETag 和业务状态。
把异步协议写进 OpenAPI,而不是留给口头约定
如果接口文档只写“提交导出,返回任务”,客户端会立刻追问:返回哪个状态码,任务地址在哪里,有哪些终态,多久查一次,失败体又是什么?这些问题不能留给群聊里的口头约定,而应该成为可以校验的契约。下面是一段针对导出端点的简化描述:
yaml
paths:
  /api/order-exports:
    post:
      summary: 创建订单导出任务
      responses:
        '202':
          description: 导出请求已接收,结果尚未生成
          headers:
            Location:
              required: true
              schema:
                type: string
            Retry-After:
              schema:
                type: integer
                minimum
如果创建任务时由调用方提交回调地址,可以用 OpenAPI 的 callback 描述“服务端随后会调用调用方”;如果 Webhook 是独立订阅、并非某次 API 调用直接产生,也可以在顶层描述入站 Webhook。这样的契约能让测试、模拟服务和客户端生成工具理解异步链路,但它不能替团队决定任务保留期、重试次数和重复事件处理方式,这些业务语义仍要写清楚。
REST 与 GraphQL:先看交互形状,不要站队
GraphQL 允许客户端声明需要哪些字段,也能在一次查询里沿关系取得多类数据;当一个页面要组合订单、商品和支付摘要时,这种查询形状很有吸引力。REST 的资源 URL 则天然适合 HTTP 条件请求和中间缓存,GET /orders/ord-0001 有独立 ETag,任务资源也有独立生命周期,网关可以对不同路径应用不同策略。
这不意味着 GraphQL 不能缓存,也不意味着 REST 一定要发很多请求,只是默认的工程路径不同。GraphQL 的查询形状更灵活,服务端必须控制查询深度、成本和批量解析;REST 的端点更固定,客户端可能需要组合多个资源。对“创建导出任务”这类有明显副作用和生命周期的操作,REST 的 202 + Operation 很直观;对复杂读取页面,GraphQL 可能更贴合客户端,因此很多系统会让两者共享同一业务层。
选择协议并不会让分布式事实消失。无论请求写成 REST、GraphQL mutation 还是消息,超时之后“到底有没有执行”仍然要靠幂等、状态查询和可观测性来回答。
哪些场景不值得使用这些模式
高级模式的风险,是读完后想把每个接口都升级一遍,结果尚未遇到原来的故障,就先承担了新状态和新运维成本。一个稳定在 50 毫秒完成的读取不需要强行改成 202,因为异步化会让客户端多一次查询,让服务端多一份任务存储,也让错误传播更慢。
如果只有一个同机房内部调用方,事件量很低且延迟不敏感,定时拉取可能比建设 Webhook 签名、订阅管理、失败重投和收件箱更省事。资源几乎不会并发修改时,ETag 写入保护的收益也有限;可一旦修改牵涉退款、库存或审批,防丢失更新通常就值得这点协议成本。
公开 API 面临未知调用者和流量突刺,限流是基础保护,单进程离线工具则可能只需要一个并发队列。完整 HATEOAS 更适合需要长周期演进、客户端种类很多的协议;如果只有一个随服务端同步发布的前端,保留关键链接即可,不必让每个字段都进入复杂媒体类型。做决定时,可以把现场问题、优先方案和新增成本放在一起检查:
这张表不是“必须全部实现”的清单,而是帮助团队把收益和代价放在同一张纸上。每采用一个模式,都意味着接受一组新的状态和失败路径,也要为这些路径安排测试、监控和恢复方式。
用可执行测试守住这些语义
这类协议最怕“文档写得很好,代码却少返回一个头”,因为正文数据看似正确,客户端的控制流程已经被破坏。教学项目没有只检查响应体,而是把状态码、头部和副作用一起放进集成测试。异步导出测试先断言创建操作返回 202,再沿 Location 查询,最后确认状态进入 SUCCEEDED:
js
const created = await api('/api/order-exports', {
  method: 'POST',
  body: {},
});

assert.equal(created.status, 202);
assert.equal(created.body.status, 'RUNNING');
并发控制测试关注的不是一次 PATCH 能否成功,而是旧版本必须被拒绝、新版本才能推进状态。两个分支都执行,才能证明服务既没有放过旧写入,也没有误伤合法修改。测试先用旧 ETag 提交并确认得到 412,再用最新 ETag 取消,确认订单进入 CANCELLED 且版本变成 "v2":
js
const stale = await api(`/api/orders/${firstOrder.id}`, {
  method: 'PATCH',
  headers: { 'if-match': '"v0"' },
  body: { status: 'CANCELLED' },
});
assert.equal(stale.status
当这些断言和缓存、限流测试一起执行时,输出会把协议行为逐项列出来。这样既能定位某一条语义是否退化,也能确认整套流程仍然连贯。相关结果如下,最后一行汇总所有测试:
text
✓ If-None-Match 命中时返回 304
✓ If-Match 防止旧版本覆盖,取消后执行退款和库存补偿
✓ 长时间任务先返回 202,再通过操作资源查询
✓ 限流超额时返回 429 和 Retry-After

12/12 项测试通过。
这些断言覆盖的不只是“接口能调用”。它们检查的是协议承诺:有没有明确表示未完成,有没有防止旧版本覆盖,有没有让缓存避免重复正文,有没有在拒绝流量时告诉客户端何时再试。
1
创建导出任务后,服务器立即返回 202。客户端此时最准确的理解是什么?
2
一个可靠的 Webhook 接收端在返回成功前,应该完成哪些动作?
下一步:把这些保护放到统一入口
到这里,我们已经能描述一条“不立即完成”的请求:用操作资源保存进度,用轮询或 Webhook 交付结果,用 ETag 避免并发覆盖,用条件 GET 减少重复传输,再用限流挡住突刺。但微服务一多,新的重复马上出现:订单服务要验身份,库存服务要限流,支付服务也要记录请求,外部客户端还得知道每个服务的地址。这正是下一节 API 网关要解决的问题,它可以统一认证、路由、外部限流和追踪入口,也可以把内部服务地址藏在后面。
不过,网关同样不是免费的午餐。它把分散的入口复杂度集中起来,也会变成所有流量都要经过的新节点。当我们走进网关时,仍然要问同一个问题:如果这一层超时、拒绝或丢掉响应,客户端和下游服务分别知道什么,又该怎样恢复?