全基因组重测序
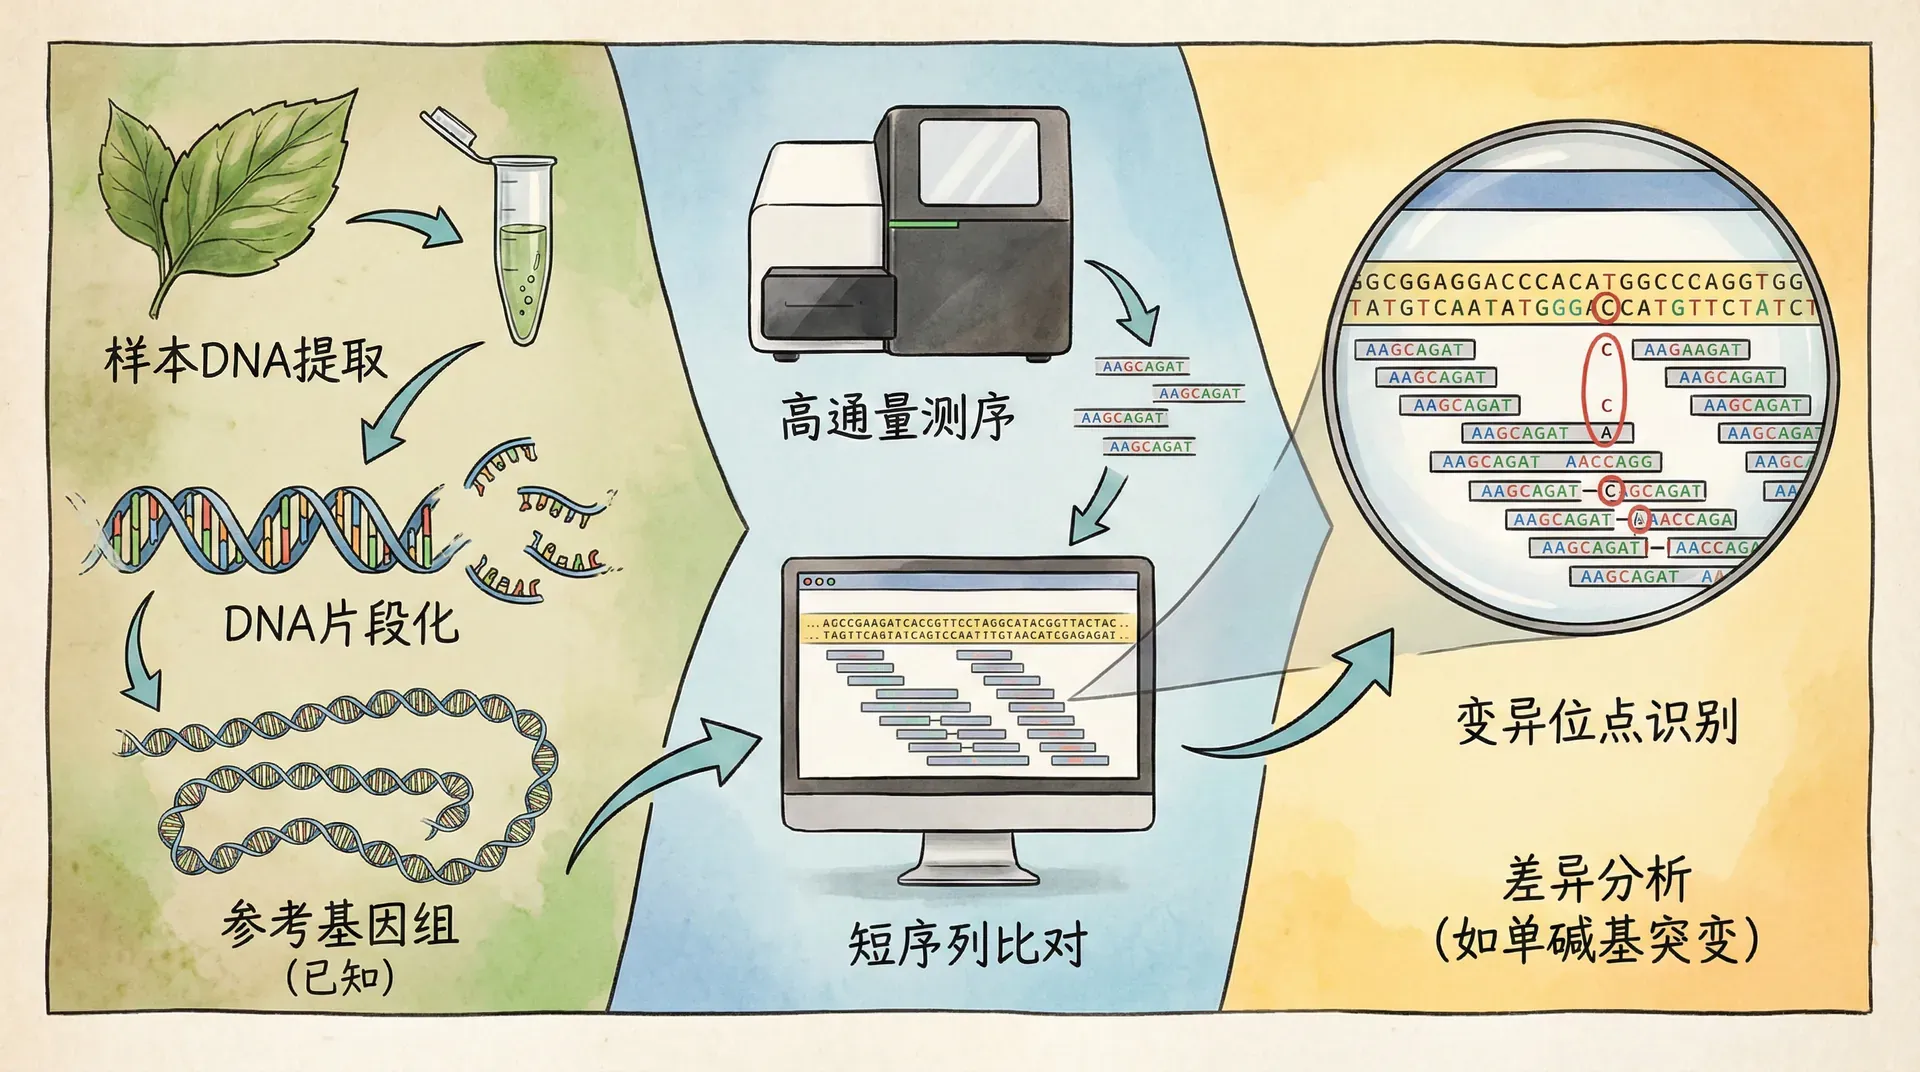
基因组重测序(Whole-genome resequencing, WGRS)是现代作物改良和进化研究的关键工具。它是在已有高质量参考基因组的基础上,对不同个体或品种进行全基因组测序,更高效地捕捉到SNP、InDel等遗传变异,也能检测到结构变异、拷贝数变化等复杂基因组重排,进而全面揭示物种内部的遗传多样性。
与传统测序相比,重测序不仅检测变异更准确高效,且适合大规模、多品种的系统分析,助力解析进化关系和筛选重要功能基因,为作物分子育种提供坚实基础。
全基因组重测序以已有参考基因组为坐标,对同一物种的多个样本测序并比对,识别SNP、短插入缺失和部分结构变异。能发现哪些变异取决于测序深度、读长、参考质量和分析流程,不能把“全基因组”理解为所有变异都被完整读出。
技术发展历程
基因组测序技术的发展极大推动了生命科学进步,主要历程如下:
- 第一代:Sanger测序——单次读取片段较长、准确性高,适合小规模测序和结果确认。
- 第二代:高通量测序(NGS)——大量短片段并行读取,显著提高通量并降低单位碱基成本,但重复区域和长结构变异较难解析。
- 第三代:单分子长读长测序——可跨越较长重复和分析单倍型,原始错误类型、成本和数据处理要求依平台而异。
测序技术的发展让作物群体研究从少量标记扩展到全基因组尺度。成本比较必须说明年份、平台、读长、覆盖深度和是否包含分析;“一次测序多少钱”并没有长期固定值。大型项目通常把参考组装、重测序、表型和种质保存结合起来。
中国团队参与了水稻、小麦等作物的参考基因组和群体研究。评价贡献时,更应看数据是否开放、样本是否有代表性、方法是否可复现以及候选位点是否得到功能验证,而不是用“领先”概括整个领域。
中国作物的进化历程探索
作物驯化是人类长期选择、自然环境和基因流动共同作用的过程。重测序能比较现代材料中保留的变异并推断群体历史,却不能恢复一条没有不确定性的“完整分子历史”。考古年代、古DNA、现代群体和语言历史等证据需要相互校验。
水稻驯化
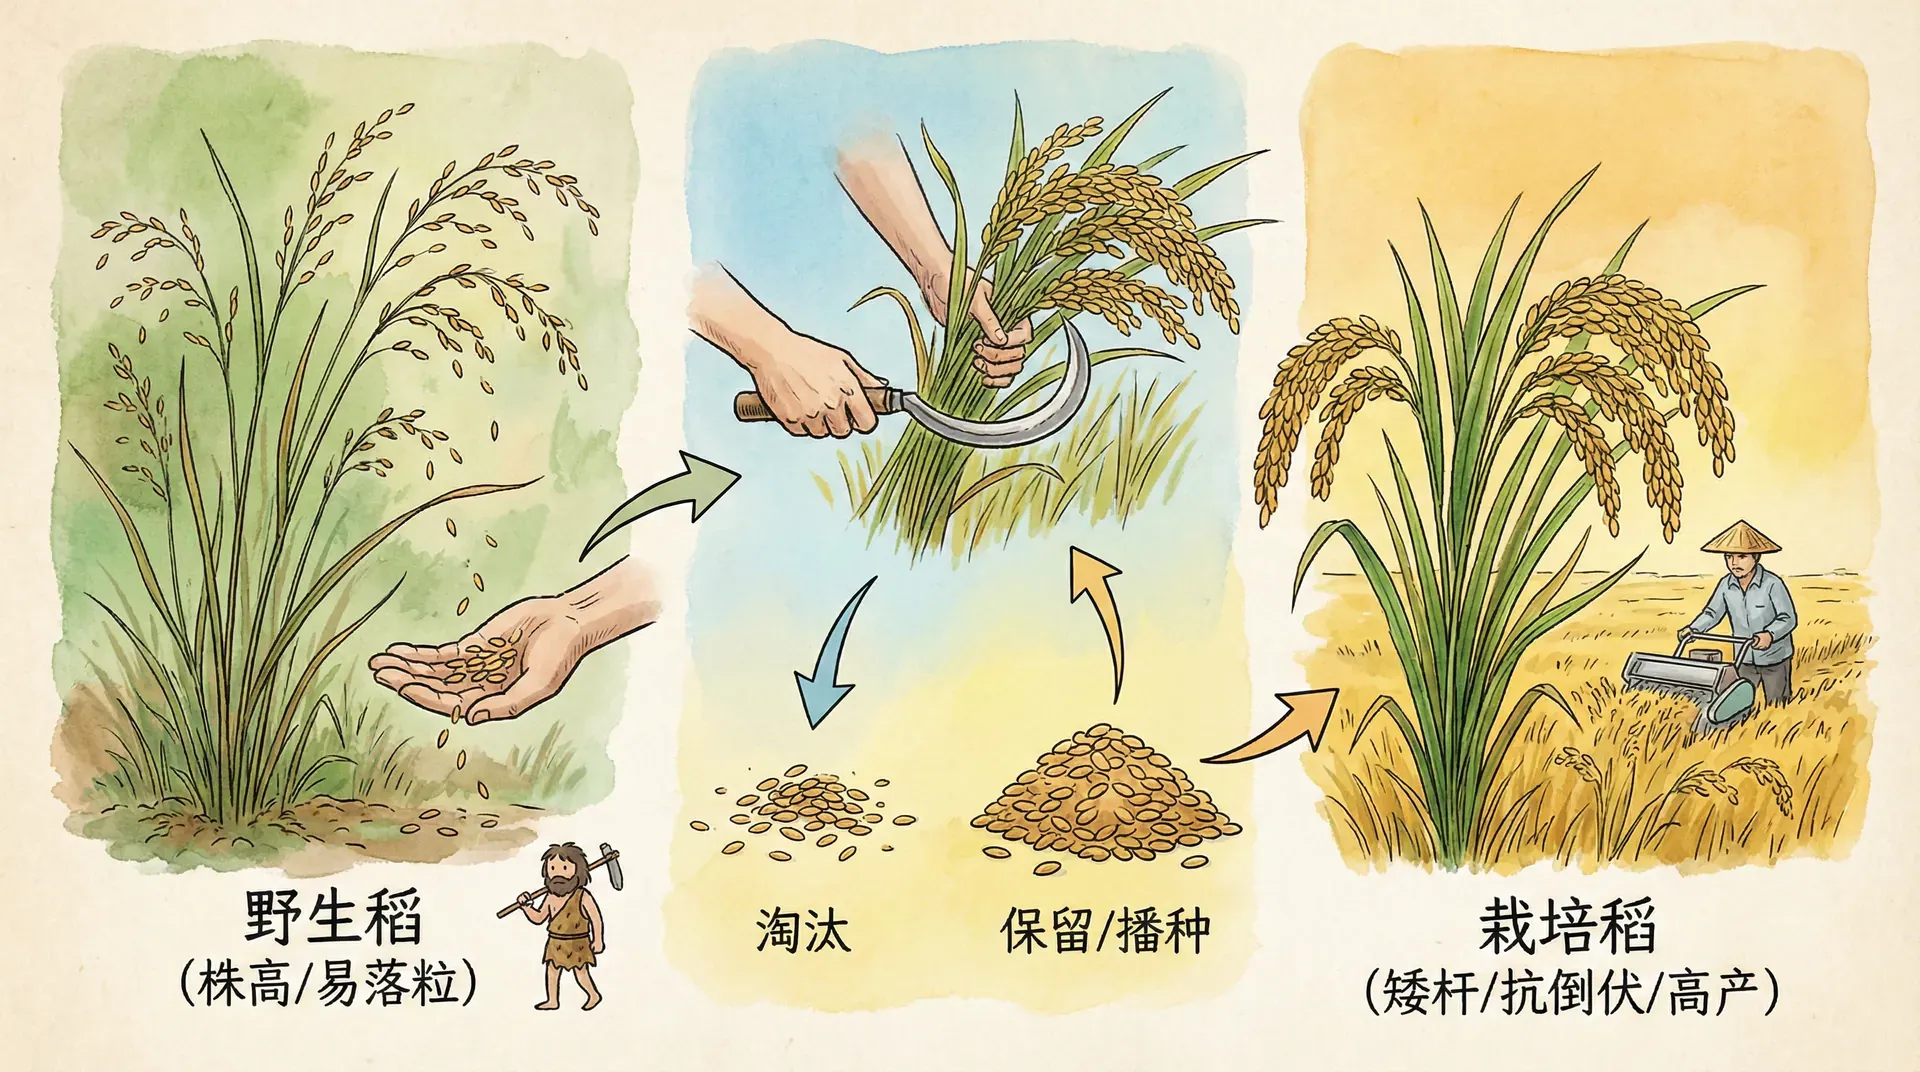
长江中下游保存了早期稻作的重要考古证据,水稻驯化经历了漫长过程。遗传数据支持粳稻与籼稻具有复杂关系,其中包括选择、分化和后续基因流动;不同模型对单次或多次驯化仍可能有不同解释。
某个样本集可以支持一种水稻群体历史模型,但结论受野生稻取样、群体结构、基因流动和统计假设影响。读到“粳稻先驯化、籼稻由杂交形成”等说法时,应把它视为有证据支持的模型,并与后续数据比较,而不是不可改变的定论。
近年来,借助古DNA分析、地理起源追溯与功能验证等多手段,科学家更深入地解析了水稻驯化过程中的时空线路及关键遗传突变事件。除了粳稻和籼稻,杂交稻与具有特殊抗逆性的地方类型,也在驯化过程中展现出特定基因片段的选择与保留机制。
水稻主要亚种的驯化路径及特点:
驯化在种子脱落、株型、成熟同步和食用品质等性状上留下选择信号,也常造成部分遗传多样性下降。重测序的作用是定位这些信号并提出候选基因;社会和文化影响则需要考古与历史证据,不能由序列数据单独推出。
主要作物的驯化和引种传播时间线
中国及其周边是水稻、粟、黍等作物早期驯化的重要区域,小麦、大麦和后来传入的美洲作物则经历了本地适应和再选择。时间线适合帮助建立大致顺序,但精确年代与路线会随着新考古和古DNA证据修订。
让我们通过下表梳理中国主要作物的驯化和传播进程:
随着科学考古与分子生物学的结合,每一项农作物考古证据、每一组基因数据,正逐步拼出中国农业“进化树”的宏伟画卷。
驯化相关候选位点的数量取决于样本、阈值和定义。真正有价值的问题是:信号是否在独立群体中出现,候选变异能否改变性状,以及它是否在不同环境中有稳定效应。一个固定“基因数”不能概括持续更新的研究结果。
驯化过程中的基因组变革
农作物的驯化不仅仅是人工选择性状的积累过程,更伴随着大规模的基因组重组、结构变异及表观遗传调控。以水稻为例,科学家发现了一系列决定“野生”到“栽培”转变的关键性状相关基因。这些改变,从亚基因组的大片段丢失、基因拷贝数变化,到小尺度的SNP和Indel,无不深刻塑造了现代作物的性状谱系。
下方列举了水稻驯化过程中重要性状的变化及其功能基因:
此外,诸如开花期调控、株高、抗旱等性状的改良,也都溯源到全基因组重测序发现的关键基因。这些基因有的源于驯化前的野生种,有的源于驯化后選育的新品种。科学研究还显示,部分家化性状存在“选择瓶颈”,即在驯化和扩散过程中丢失了部分有益变异,因此现今的功能基因挖掘和农艺性状改良越来越重视野生种和地方品种的遗传资源。
发现作物的遗传宝库
地方品种、现代品种和野生近缘种保存着不同类型的遗传变异。它们不是“取之不尽”的资源:小种群、栖息地丧失、混杂和保存条件都会造成遗传侵蚀。种质资源只有经过准确鉴定、繁殖更新和可获取的表型记录,才更容易被育种利用。
中国作物品种的遗传多样性
一个国家的地方稻种在某个样本库中可能表现出很高多样性,但“占全球多样性的百分比”强烈依赖采样范围和统计指标。更稳妥的结论是:东亚地方品种与野生稻保存了大量稀有等位变异,值得在统一质控下比较和保护。
事实上,中国不仅水稻,小麦、玉米、大豆、棉花等主要作物也都有庞大的地方品种库。科学家们常年对这些材料进行群体基因组分析,发现诸多具有抗逆、高产、优质等优势性状的新基因和功能位点。这些发现推动了中国特色的分子设计育种体系建设,有效支撑了国家粮食安全及农作物高质量发展。
图中的多样性高低应结合样本数、取样地点和指标解释。地方品种常保留现代育种未重点选择的变异,现代商业品种也可能通过广泛杂交拥有复杂来源。不能把所有作物都概括为同一种固定差距。
分子标记技术的应用
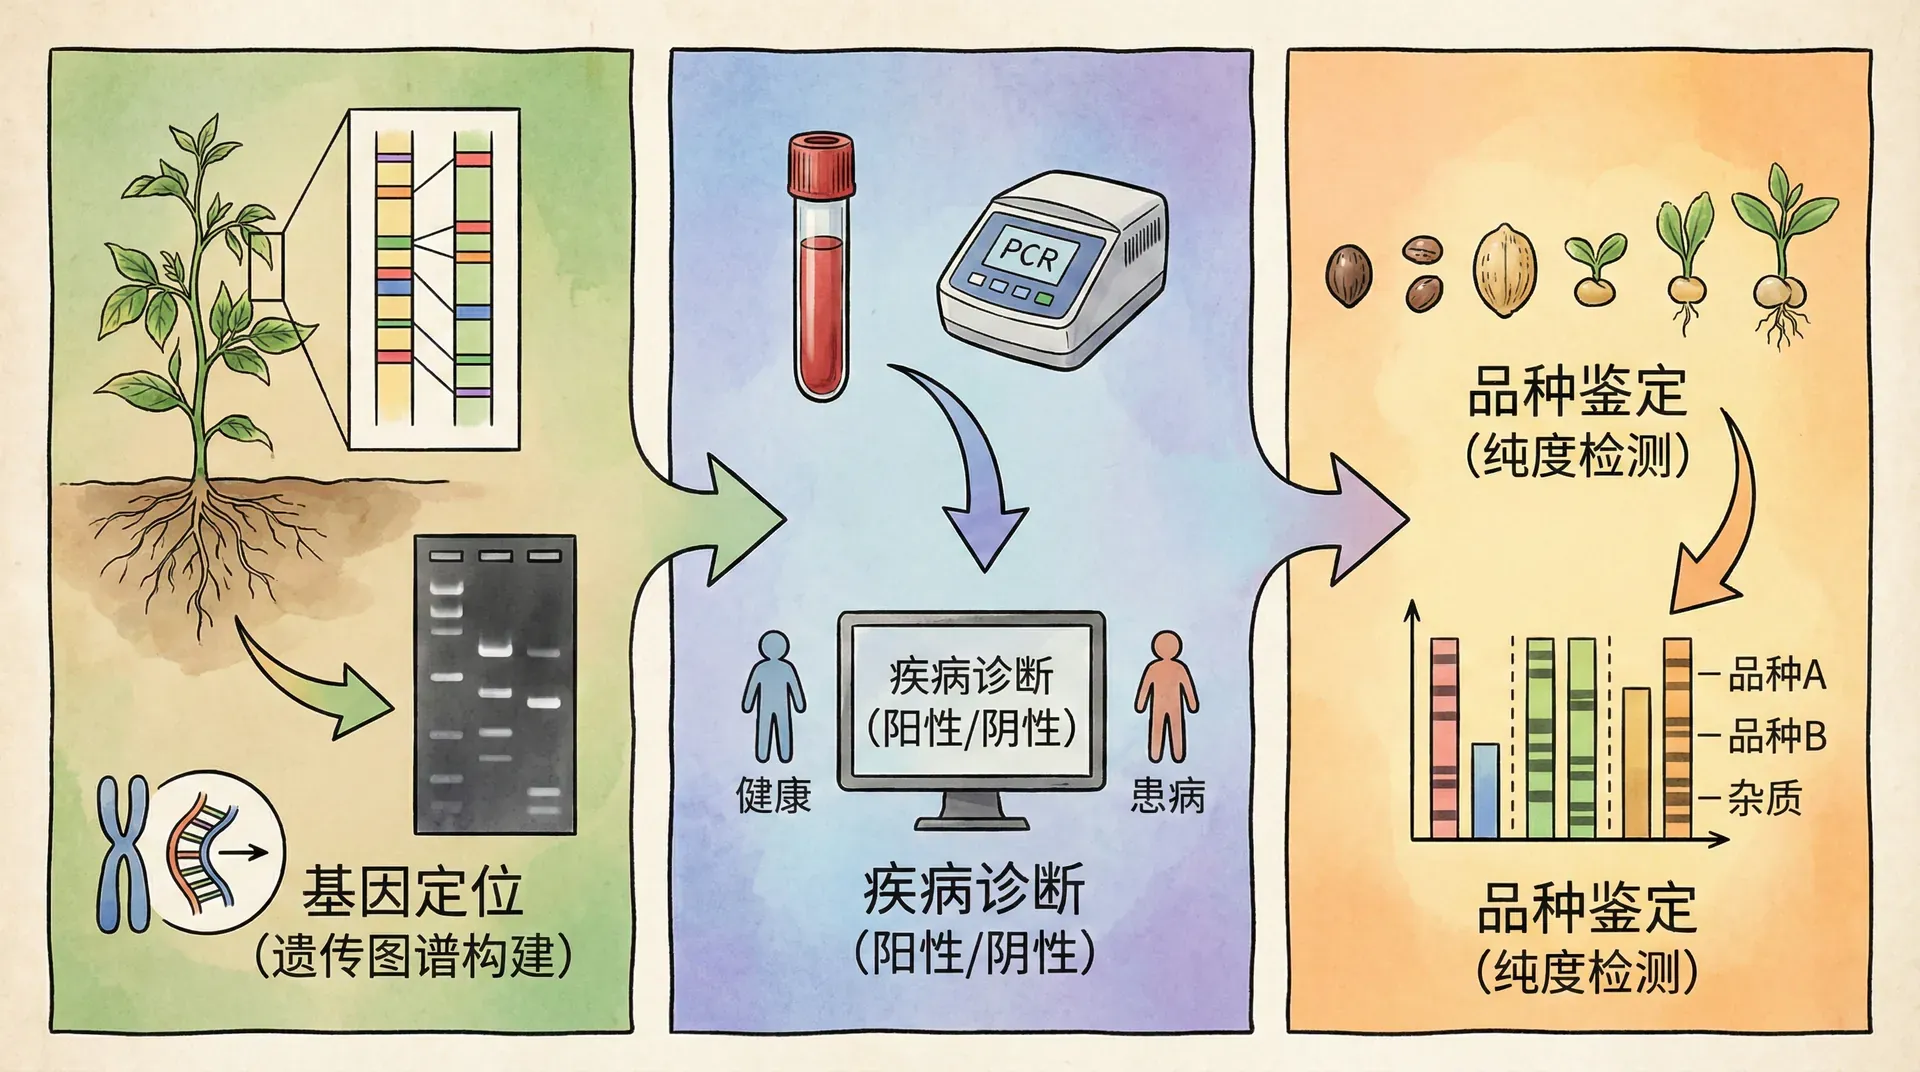
重测序可提供密集的SNP、短插入缺失和部分结构变异。分子标记是与某个基因或性状共同遗传的可检测位点;它本身未必具有功能。标记与目标位点距离越远,重组使两者分开的机会通常越大。
一次群体重测序可能识别大量候选变异,但数量会随样本规模、参考序列、测序深度和过滤标准变化。高密度标记提高定位分辨率的前提,是表型可靠、群体结构得到控制,并且关联结果能在独立材料中复现。
中国科学家广泛应用这些标记技术,推动了作物分子辅助育种、优良基因导入及全基因选择育种等一系列创新工程,取得了诸多突破性成果。例如:
随着第三代测序和人工智能分析等新技术加持,分子标记开发和应用的数量与精度还将持续提升,为中国乃至世界农业科技进步不断注入新动能。
寻找重要农艺性状基因
基因的发现与功能解析一直是作物遗传改良研究的核心内容。可以将基因发现过程形象地比喻为在浩瀚无垠的基因组“海洋”中撒网捞珍珠——每一个重要性状基因的发现,都能极大推动农业生产力的提升和作物品种的改良。
近年来,随着全基因组重测序(WGS)等高通量组学技术的发展,科学家们可以以前所未有的分辨率和速度从庞大的自然变异资源库中寻找与农艺性状紧密相关的关键基因。无论是产量、品质,还是抗逆性、抗病性等复杂性状的遗传基础,正被逐步揭开面纱。全基因组关联分析(GWAS)正是当今国际主流的基因挖掘手段之一。
全基因组关联分析原理
GWAS在自然群体中检验基因组变异与表型的统计关联。显著信号通常对应一个连锁不平衡区域,而不自动等于QTL中的因果基因。群体结构、亲缘关系和环境差异可能制造假关联,需要在模型中控制并用独立群体验证。
这类似于在浩繁的数据中运用“大数据挖掘+精细定位”技术,揭示遗传变异与表型变异之间的因果关系。GWAS可以定位到具体的染色体区段或候选基因,极大提升基因克隆和功能鉴定的效率。
成功的GWAS分析需要高质量的群体基因型数据和准确的表型测定结果,这往往依赖于全基因组重测序技术带来的高密度标记和更多的自然变异信息。
GWAS分析过程简述
- 群体与设计:选择能代表研究问题的材料,并记录亲缘、亚群和环境来源。
- 基因型质控:检查测序深度、缺失率、等位基因频率和批次效应。
- 表型测量:在适当重复与环境中测量性状,报告误差和遗传力。
- 关联分析:采用能处理群体结构和亲缘的模型,并校正大量检验。
- 功能验证:精细定位后,利用表达、遗传分离、编辑或互补等证据区分候选基因与邻近标记。
GWAS分析结果可视化
曼哈顿图以基因组位置为横轴,以−log10(P值)等统计量为纵轴。高点表示在当前数据和模型下关联更强,不表示效应一定大,也不能单凭峰顶确定因果基因。阈值、连锁不平衡范围和效应值应与图一起阅读。
曼哈顿图适合快速查看关联信号分布。下一步要检查QQ图、样本结构、效应方向和置信区间,再利用精细定位和功能实验追踪候选变异。可视化是分析入口,不是机制结论。
中国科学家的基因发现成果
中国科学家在重要作物基因发现与功能解析方面已取得大批突破性进展,并产生了世界级影响。例如:
中国科学家还积极开展功能基因网络解析、重要基因库构建、大规模基因编辑与分子设计育种,为全球农作物基因资源的发掘和利用做出了重要贡献。
基因发现的实际应用价值
候选基因只有在标记与性状稳定共分离、因果变异得到支持且育种背景中效应可重复时,才适合转化为选择工具。对复杂性状,基因组选择通常利用全基因组标记共同预测,而不是寻找一个“关键基因”。
通过对比可以发现,应用分子标记辅助选择(MAS),目标性状的改良速度和幅度明显提升。
分子标记可能在苗期提前选择、减少部分田间鉴定量,但不能给所有作物提供统一的“缩短几倍”效果。育种周期还受世代时间、目标性状、回交次数、多环境试验和审定流程影响。
此外,现代全基因组重测序结合分子标记开发,还推动了基因组选择(GS)等新兴育种技术的发展,使得全基因组范围的遗传潜力能够被系统性利用。未来的大数据、人工智能与基因编辑的深度整合,将进一步加速基因发现、标记开发与高效育种的实践落地。
全基因组重测序把遗传变异系统地映射到参考坐标,为群体历史、标记开发和关联研究提供基础。它的学习重点是理解证据链:变异发现需要质控,统计关联需要控制混杂,候选基因需要功能验证,育种价值需要田间检验。
将来随着测序技术更加普惠、人工智能分析能力提高与多组学信息的融合,全基因组重测序与基因发掘将在作物遗传改良、种质资源创新和应对全球粮食安全挑战中持续发挥更为核心的作用。