自在学

我们与你共同进步

  • 分类课程
  • 文章
  • 工作台
  • 订阅

  • 关于我们
  • 隐私政策
  • 使用条款

探索

  • 分类课程
  • 文章
  • 工作台
  • 订阅

网站信息

  • 关于我们
  • 隐私政策
  • 使用条款

加入社区

自在学学习社区微信二维码

微信扫码,交流学习

株洲市自在学教育科技有限公司© 2025 - 2026 版权所有

© 2025 - 2026 株洲市自在学教育科技有限公司 版权所有

湘公网安备43020302000292号|湘ICP备2025148919号-1
分类课程工作台文章订阅
分类课程工作台文章价格

优化与运筹基础:从模型到最优决策

  1. 01从问题到优化模型
  2. 02凸性:为什么局部信息能指向全局
  3. 03线性规划的几何与单纯形思想
  4. 04对偶与资源价值
  5. 05整数优化与离散决策
  6. 06网络优化:路径、流与割
  7. 07无约束数值优化:梯度与 Newton
  8. 08KKT 与约束最优性
  9. 09梯度算法的工程化使用
  10. 10综合决策与模型审计
正在加载课程章节内容
课程数学优化与运筹基础:从模型到最优决策无约束数值优化:梯度与 Newton

无约束数值优化:梯度与 Newton

前面关心的是模型结构和可证明的候选。变量很多时,逐个列角点并不现实,算法需要从一个初始点出发,产生一串越来越好的迭代。这里的重点不是重新求“极值点”,而是解释一次更新为何下降、什么时候会失败、停止时能说到什么程度。
二次函数等高线上的梯度下降轨迹

梯度给出局部下降方向

可微函数在 xxx 附近满足

f(x+d)=f(x)+∇f(x)Td+o(∥d∥).f(x+d)=f(x)+\nabla f(x)^Td+o(\|d\|).f(x+d)=f(x)+∇f(x)Td+o(∥d∥).

选择 d=−∇f(x)d=-\nabla f(x)d=−∇f(x) 时,一阶项为 −∥∇f(x)∥2<0-\|\nabla f(x)\|^2<0−∥∇f(x)∥2<0。因此对足够小的正步长 α\alphaα,更新

x+=x−α∇f(x)x^+=x-\alpha\nabla f(x)x+=x−α∇f(x)

会下降。注意“足够小”依赖函数的曲率;任意固定的 α\alphaα 都不是普遍安全的。

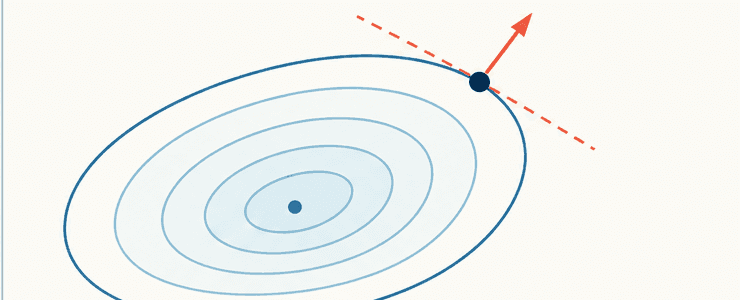
梯度向量、负梯度下降方向与等高线正交关系

对二次函数

f(x)=12xTQx−bTx,f(x)=\frac12x^TQx-b^Tx,f(x)=21​xTQx−bTx,

其中 QQQ 对称正定,梯度为 Qx−bQx-bQx−b,唯一最优点满足 Qx∗=bQx^*=bQx∗=b。梯度法便是在迭代地逼近这个线性方程的解。

步长稳定性

一维模型 f(x)=12λx2f(x)=\frac12\lambda x^2f(x)=21​λx2 的更新是

xk+1=(1−αλ)xk.x_{k+1}=(1-\alpha\lambda)x_k.xk+1​=(1−αλ)xk​.

误差收敛需要 ∣1−αλ∣<1|1-\alpha\lambda|<1∣1−αλ∣<1,也就是 0<α<2/λ0<\alpha<2/\lambda0<α<2/λ。步长接近上界会来回震荡;超过上界则误差放大。多维正定二次函数要同时满足所有特征值的稳定范围,最大特征值控制最严格的上限。

一维二次函数在小、临界、过大步长下的迭代对照

狭长二次等高线造成梯度法锯齿轨迹

Newton 用曲率改方向

在 xkx_kxk​ 处用二阶模型近似:

mk(d)=f(xk)+gkTd+12dTHkd,m_k(d)=f(x_k)+g_k^Td+\frac12d^TH_kd,mk​(d)=f(xk​)+gkT​d+21​dTHk​d,

其中 gk=∇f(xk)g_k=\nabla f(x_k)gk​=∇f(xk​)、Hk=∇2f(xk)H_k=\nabla^2f(x_k)Hk​=∇2f(xk​)。令模型梯度 gk+Hkdg_k+H_kdgk​+Hk​d 为零,得到 Newton 方向

Hkdk=−gk.H_kd_k=-g_k.Hk​dk​=−gk​.

二次正定函数的 Hessian 恒定,Newton 一步就到达解;一般函数只有在解附近 Hessian 非奇异且变化平稳时才有局部二次收敛。若 Hessian 不正定,Newton 方向可能不是下降方向,实际算法会配合阻尼或线搜索。

Newton 用局部抛物模型直接指向二次模型最小点

停止与解释

常用停止量包括 ∥∇f(xk)∥\|\nabla f(x_k)\|∥∇f(xk​)∥、步长 ∥xk+1−xk∥\|x_{k+1}-x_k\|∥xk+1​−xk​∥ 和目标变化。梯度小表示一阶驻点残差小,不自动表示全局最优;若函数已知凸且可行,才可把它升级为全局结论。数值实现还要看变量尺度和线性方程求解误差。

梯度法与 Newton 的误差、函数值和停止条件比较

练习

  1. 对 f(x)=12(4x2)−8xf(x)=\frac12(4x^2)-8xf(x)=21​(4x2)−8x,写出梯度法更新,并给出稳定步长范围。

梯度为 4x−84x-84x−8,更新为 xk+1=xk−α(4xk−8)x_{k+1}=x_k-\alpha(4x_k-8)xk+1​=xk​−α(4xk​−8)。这里曲率 λ=4\lambda=4λ=4,由 0<α<2/40<\alpha<2/40<α<2/4 得稳定范围 0<α<1/20<\alpha<1/20<α<1/2。

  1. 为什么 Newton 一步解二次正定函数?

二次函数的 Hessian QQQ 恒定,梯度为 Qx−bQx-bQx−b。Newton 方程 Qd=−(Qx−b)Qd=-(Qx-b)Qd=−(Qx−b) 给出 x+d=Q−1b=x∗x+d=Q^{-1}b=x^*x+d=Q−1b=x∗,正好满足最优性方程。

  1. 梯度范数很小但不能说明全局最优的情形是什么?

非凸函数的鞍点或局部极大也可能梯度为零;此外约束问题的边界解不一定满足无约束梯度为零。需要凸性或 KKT 等额外结构才能给出更强结论。

1
对一维二次函数,步长超过稳定上界通常会发生什么?
上一章网络优化:路径、流与割下一章KKT 与约束最优性