一枚公平硬币已经连续出现五次反面。第六次抛出前,你把下注金额加倍,能不能因此改变下一次的平均收益?如果一直等到累计赢一元才停,又能不能说最后一定赚一元,所以这个游戏其实不公平?
这两个问题看起来相似,关键却不在同一个地方。改变下注金额,要问金额是在结果揭晓前还是揭晓后决定的;等到赢一元才停,要问等待和亏损能不能得到足够控制。本章会把这些条件逐项写出来。你会看到,选对一个条件平均不变的过程,首达概率和平均等待时间就能从同一个模型中算出来;但省掉一个条件,也可能把正确等式用成错误结论。
信息不是一句“知道过去”就够了
设第 k 次结果为 ξk∈{−1,1},各次独立,暂取两种结果等概率。到第 n 次结束时,完整记录是 ξ1,…,ξn。把这些记录能够判断的全部事件组成的信息记为
Fn=σ(ξ1,…,ξn).这里的 σ 表示“由这些变量生成的事件集合”。例如“前三次中至少出现一次正面”属于 F3;“第四次是不是正面”则不属于 F3。暂时不用展开所有集合运算,你可以把 F 理解成此时能回答的全部是非问题。
信息不会遗忘已经发生的事,因而
F0⊆F1⊆F2⊆⋯这样一串递增的信息称为过滤。若随机变量 Mn 只用时刻 n 已有的信息就能确定,就说过程适应于这组过滤。
条件期望 E(Mn+1∣Fn) 也不是一个事先固定的常数。它随着你看到的历史改变:在每段可能的历史后,只平均还没有揭晓的未来。
假设当前位置为三,下一步以各 1/2 的概率到二或四,那么条件平均是 (2+4)/2=3。另一段历史可能把你带到负二,此时两个去向是负三、负一,平均就是负二。一个条件期望等式,要在这些可能的历史后都成立,不能只把所有历史混在一起算一次平均。
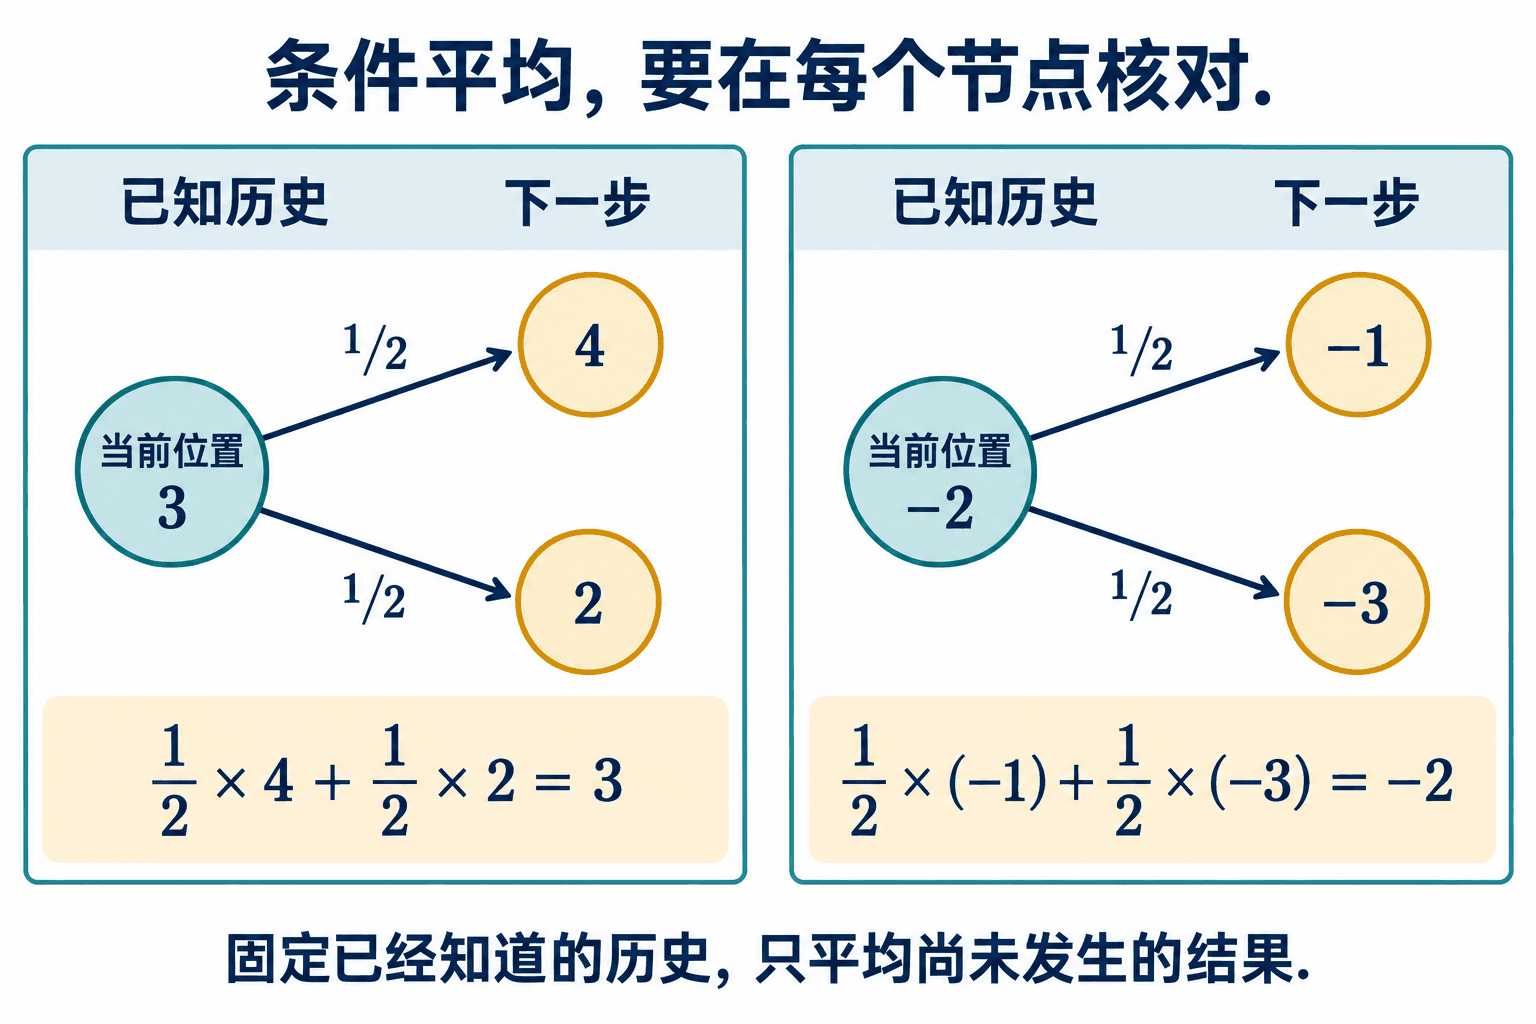
鞅要求核对三件事
相对于过滤 (Fn),过程 (Mn)n≥0 是鞅,要求它适应、每个固定时刻绝对可积,并满足
E∣Mn∣<∞,E(Mn等价地,下一步增量的条件平均为零:
E(Mn+1−Mn∣Fn)“可积”保证这里的条件平均有通常的有限含义。“适应”保证右边是当前已经知道的量。最后一个等式才表达条件平均没有漂移。它没有约束每条路径必须平稳,也没有保证波动很小。
再取一次期望,由全期望公式得到 EMn+1=EMn,所以 EM。反过来却不成立。例如令 等概率取正负一,取
M0=0,M1=ξ,M2三个时刻的无条件均值都是零。但看见 M1 后,M2 已经确定为 2M1,所以
E(M2∣F1)=2M1总体均值相同,掩盖不了已经可预测的下一步变化。
马尔可夫性约束的是给定历史后的整个下一步分布;鞅性只约束这个分布的平均。二者不是同一个条件,也不能互相替代。判断鞅时,我会保留“相对于哪组信息”这句话,避免在推导中悄悄改变观察者知道的内容。
如果观察者提前知道第一枚硬币,把 G0=σ(ξ1) 当作零时刻信息,则从零出发的游走满足 E(S,不再等于零。硬币的物理规律没有变,信息条件变了。
把可预测的漂移扣掉
令独立增量满足
P(ξk=1)=p,P(ξk并设 Sn=i+∑k=1nξk。在自然过滤下,
E(Sn+1∣Fn)=Sn公平情形 p=1/2 才有 d=0,此时位置本身是鞅。有偏时,扣掉累计平均漂移:
Mn=Sn−nd.于是
E(Mn+1∣F每个固定 n,它只取有限范围内的值,适应性和可积性也都成立。例如 p=0.65 时,每步平均右移 0.3,该扣掉的是 0.3n,而不是把某条观察到的样本斜率当成模型漂移。
如果适应、可积的过程满足 E(Mn+1∣Fn)≥Mn,称为次鞅;不等号反向则称为超鞅。名称容易记反,直接检查条件平均向哪边移动更可靠。鞅同时满足这两种不等式。比如有正漂移的位置过程是次鞅,但这不意味着每一步都上涨。
计数减去预期计数
每个时段独立以概率 p 到达一位顾客,否则没有到达。令指标 Ik 表示第 k 个时段有无到达,则
Nn=k=1∑nIk因为 In+1 与过去独立,
E(Mn+1∣Fn)=N原计数 Nn 会不断累积;补偿后的 Mn 则把模型预期的部分拿掉了。这不是说 Mn 每一步都回到零,更不是说累计计数永远贴着直线 。
若到达概率由过去决定为 pk=P(Ik=1∣Fk,对应的补偿量应改成 。逐步条件化仍有 ;直接使用一个固定 就未必正确了。
根据过去改变金额,条件平均仍可不变
令 Hk 是第 k 次结果揭晓前已经决定的金额,即 Hk 由 F 确定。为清楚处理可积性,本节取 。用补偿增量构成收益
Wn=k=1∑nHk已知过去时,Hn+1 是一个已知数,可以提出条件期望:
E(Wn+1−W因此 Wn 是鞅。金额可以依赖过去,也不必跨次独立。比如第一轮取一,之后若上一轮为反面就取二,否则取一;这个规则仍在下一轮开始前决定。
反过来,若偷看本轮结果后才取 Hk=ξk,就不能把它当作 Fk−1 已知的数。在公平情形,
Hkξk=ξk2=1,每轮都得到一。一般 p 下,用同一个偷看规则乘补偿增量,条件平均为
E[ξk(ξk−d)∣F通常为正。这个“优势”来自未来信息,不是前面的鞅推导出了矛盾。
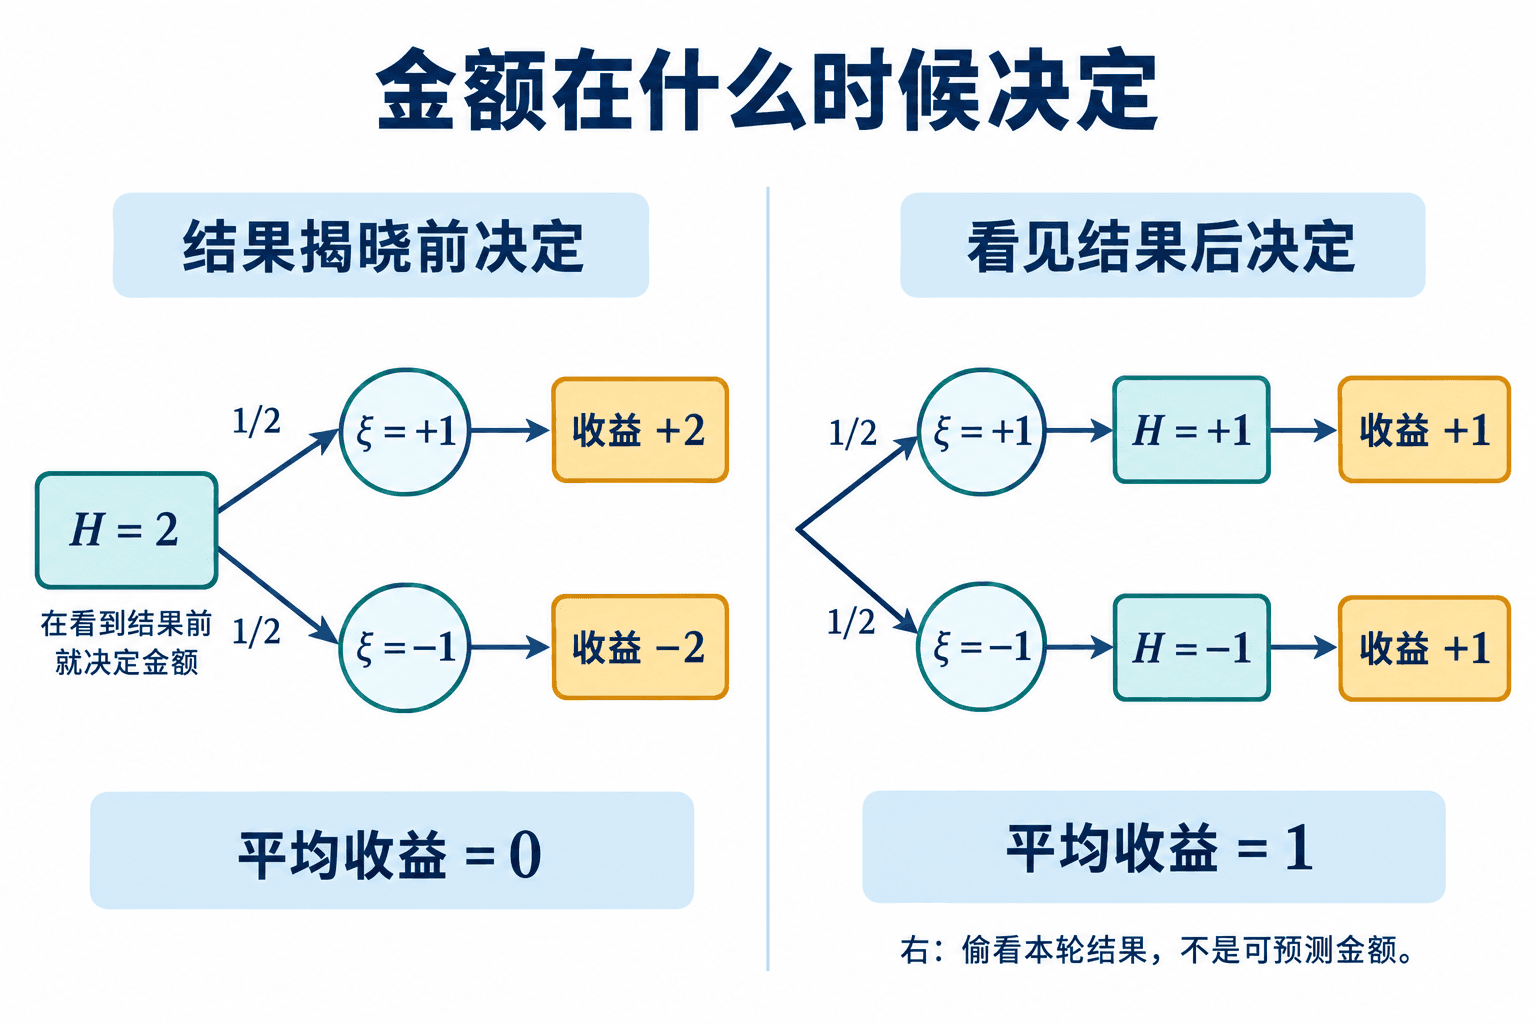
把正面概率设为 0.65,在树上选一段已经发生的历史,分别查看位置和补偿位置。比较的是这个节点的两个下一步去向及其加权平均,不只是整棵树最右端的平均。改成“上一轮反面后金额取二”,检查金额是否在两个未来分支分开前就相同;再切到“看见本轮结果后选正负金额”,看看是哪一项破坏了条件平均为零。树上的已知路径、下一步读数和全部终点分布会同时更新。
逐步更新的预测,也是一种鞅
还有一种常见过程,没有谁真的在下注。设一个最终量 Z 满足 E∣Z∣<∞,时刻 n 对它的预测为
Mn=E(Z∣Fn).信息越多,预测可能上升也可能下降。但如果现在就把明天所有可能的信息更新平均起来,应该仍等于今天的预测。数学上,这是条件期望的塔式性质:
E(Mn+1∣Fn同时 E∣Mn∣≤E∣Z∣,所以可积性没有漏掉。
例如公平硬币共抛三次,至少两次正面就支付一元,否则支付零元。让 Z 表示这笔支付。零时刻有四种获胜序列,占八种等可能序列的一半,所以 M0=1/2。
第一次为正面时,剩余两次只需至少一次正面,因此 M1=3/4;第一次为反面时,后两次必须都是正面,因此 M1=1/4。两支平均又回到 1/2。
两次结果为“正正”时,支付已经确定为一;“正反”或“反正”时,还要看最后一枚,预测为 1/2;“反反”时则已经确定为零。第三次结束,M3=Z。在每一个节点检查子节点的平均,就能看见塔式性质在具体问题里怎样工作。
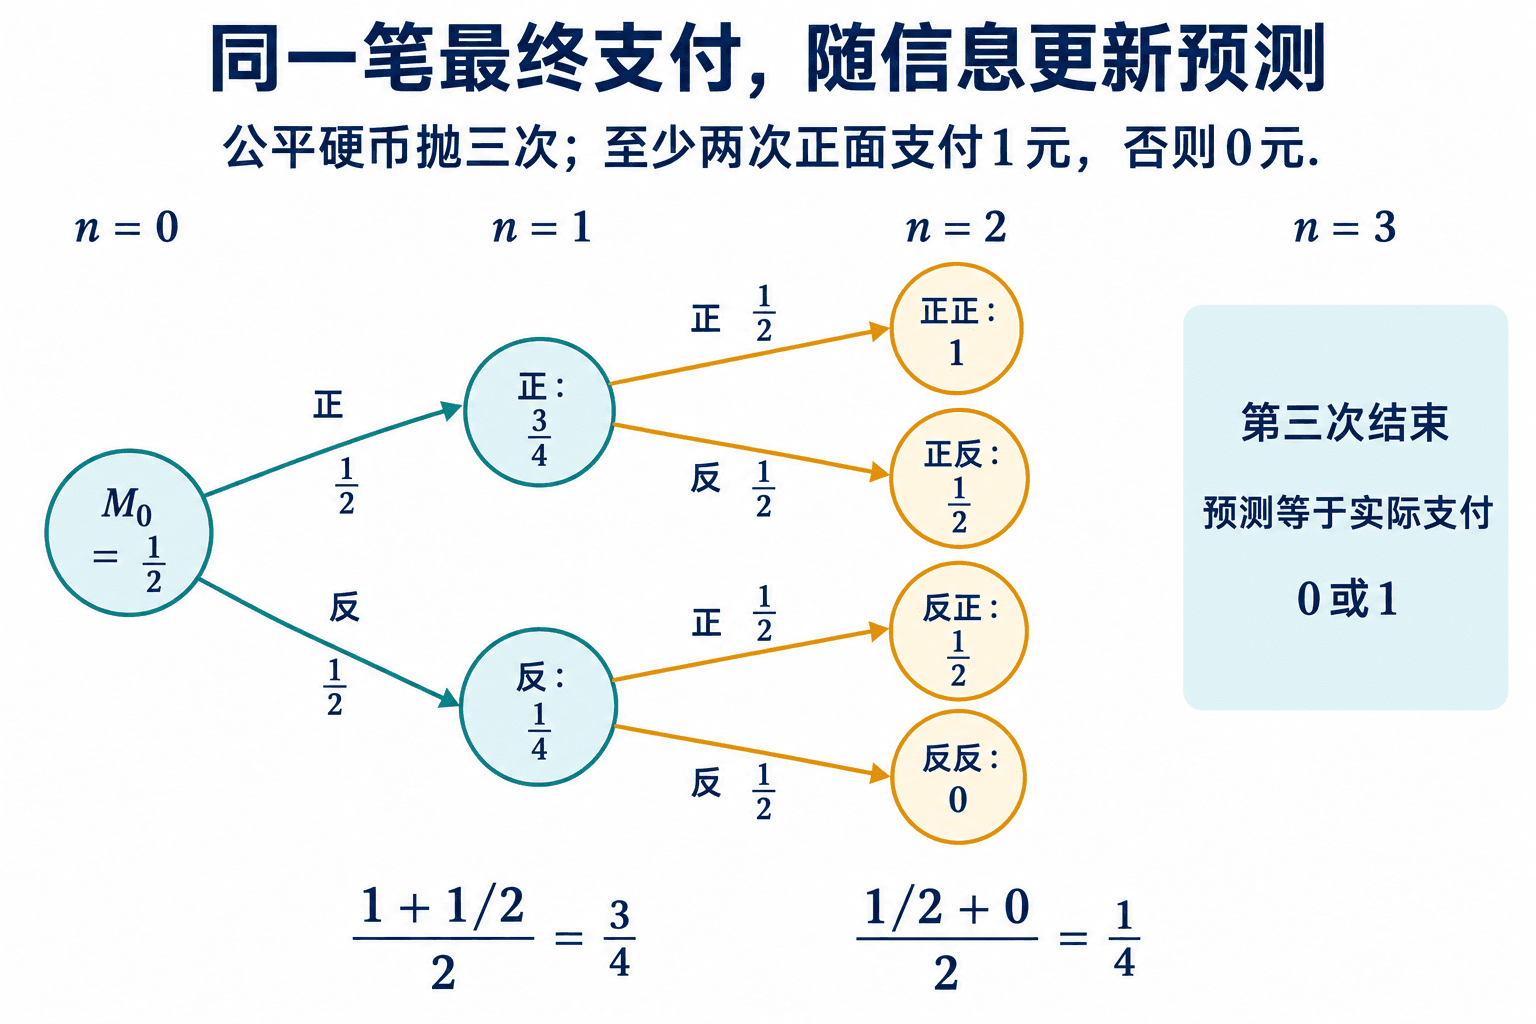
这里的预测过程与“期望永远不变”有一点值得分清:沿某条真实路径,预测确实不断改变;不变的是,在今天的信息下对下一次更新取条件平均。
停止时间,必须能在当时作出判断
把停手时刻记为 τ,允许它取 0,1,2,… 或 ∞。它是相对于 (Fn) 的停止时间,是指对每个 ,
{τ≤n}∈Fn.也就是走到第 n 步时,不看以后,就能判断是否已经停止。等价地,{τ>n} 也由当前信息确定。
固定在第二十步停,是停止时间。第一次碰到零或十便停,也是停止时间:
τ=inf{n≥0:Sn∈{0,10}}.若没有发生,约定下确界为 ∞。而“在前十步的最高点停”一般不是停止时间:站在第三步,即使当前是截至此刻的最高点,你也不知道后七步会不会更高。
一个更短的反例是:若第二次为正面,规定第一步停;若第二次为反面,规定第二步停。那么 {τ≤1}={ξ2=1},第一步的信息不能判断它。规则把决定停手所需的信息放到了停手之后。
截断后的过程为什么还是鞅
对鞅 Mn,停下以后保持当时的值,得到
Mn=Mn∧τ如果 τ>n,下一步仍走原过程;如果 τ≤n,下一步保持不变。因此有逐条路径成立的等式
Mn+1−M停止时间的作用就在这个指标上:1{τ>n} 已由 Fn 确定,可以提出条件期望,得到条件平均增量为零。停止后的过程也适应;而对每个固定 n,
∣Mn∧τ∣≤k=0∑n∣M所以它仍可积。于是对每一个固定的 n,
EMn∧τ=EM0.这一步不要求 Eτ<∞,甚至不要求停止一定发生。因为我们只走到有限的第 n 步,尚未停下的路径还在统计里。
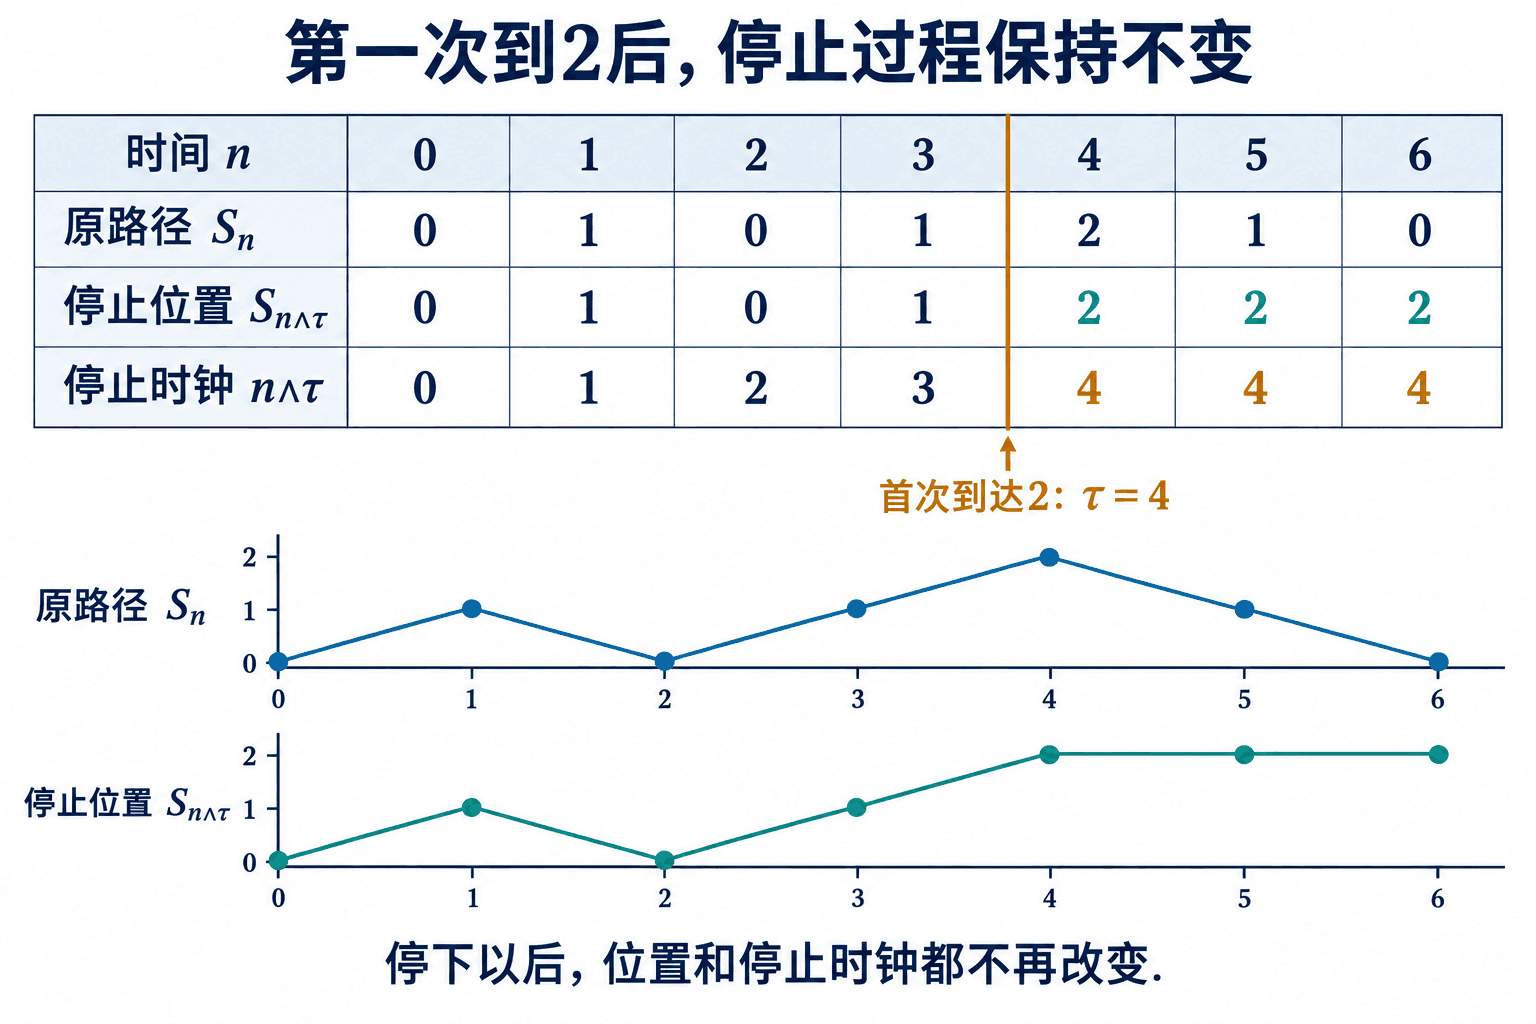
如果 τ≤K,其中 K 是固定有限整数,那么直接取 n=K,就得到 EMτ=。这是有界停止时间的结论,不需要让 趋于无穷。
对于无界停止时间,即便 τ 几乎必然有限,仍要检查能否把极限放进期望。一个方便的充分条件是存在可积随机变量 B,使所有 n 都满足 ∣Mn∧τ∣≤B。此时由支配收敛定理,
Mn∧τ→Mτ⟹EM若控制量只是一个固定常数,就是有界收敛的情形。下面先用最容易看清楚的有限边界来计算;一般的一致可积理论不在本章展开。
从两个终点求首达概率
对称随机游走从整数 i 出发,0<i<N,第一次碰到 0 或 N 时停止。记
τ=inf{n≥0:Sn∈{0,N}},它是否真的会停?从任何内部状态出发,只要接下来的 N 次全部向左,就会在这 N 步内碰到零。这一事件概率为 2−N。每隔 N 步检查一次,在尚未停止的条件下,下一段至少有这个概率停止,所以
Pi(τ>kN)≤(1−2−N)右边趋于零,证明 τ<∞ 几乎必然。进一步用尾和公式可得粗略但有限的界
Eiτ=n≥0∑P这个界不精确,但条件已经落实了,后面不会靠“应该总能停”来代替证明。
由于 Sn 是鞅,
EiSn∧τ=i.一步只走正负一,所以在首达前后,0≤Sn∧τ≤N;不会一步越过边界。有界收敛给出 EiS。停下时只有两种可能:
i=EiSτ=Nhi+因此
hi=Ni.选位置鞅,是因为停止后的随机变量只剩两个取值。把它们按概率平均,就能解出唯一未知量。
取 N=8,i=3,先到八的概率为 3/8,先到零的概率为 5/8。起点靠近下边界,上边界命中概率较小。作为另一种核对,第三章的一步分析给出 h,边界为 ;线性函数 确实满足它。
平均停多久,需要把时间放进鞅
终点只记录最后在哪一边,没有直接记录走了多久。对称游走的平方多出一个稳定的一步增量:
Sn+12=Sn2+2S条件化后中间项均值为零,于是
Qn=Sn2−n是鞅。注意停止的是整个过程,因此在截断时刻,
Qn∧τ=Sn∧τ2−(n∧τ不是 Sn∧τ2−n。停下以后,修正中的时钟也停了。
固定 n 的鞅等式给出
Ei(n∧τ)=EiSn∧τ右边被 N2 控制,左边随着 n 单调增加。由单调收敛,Ei(n∧τ)↑E;平方位置被 控制,又可用有界收敛。两边分别取极限,得到
Eiτ=EiSτ2−这个论证也独立证明了 Eiτ<∞,没有先假设我们正要计算的均值存在。
停下时 Sτ2 为 N2 或零,所以
EiSτ2=N在刚才 N=8,i=3 的例子里,平均需要十五步。起点改成五,平均时长仍是十五步,但命中上界的概率变成 5/8。两项统计量描述的不是同一件事。关于中点对称的是平均时长;命中上界概率则随起点上升。
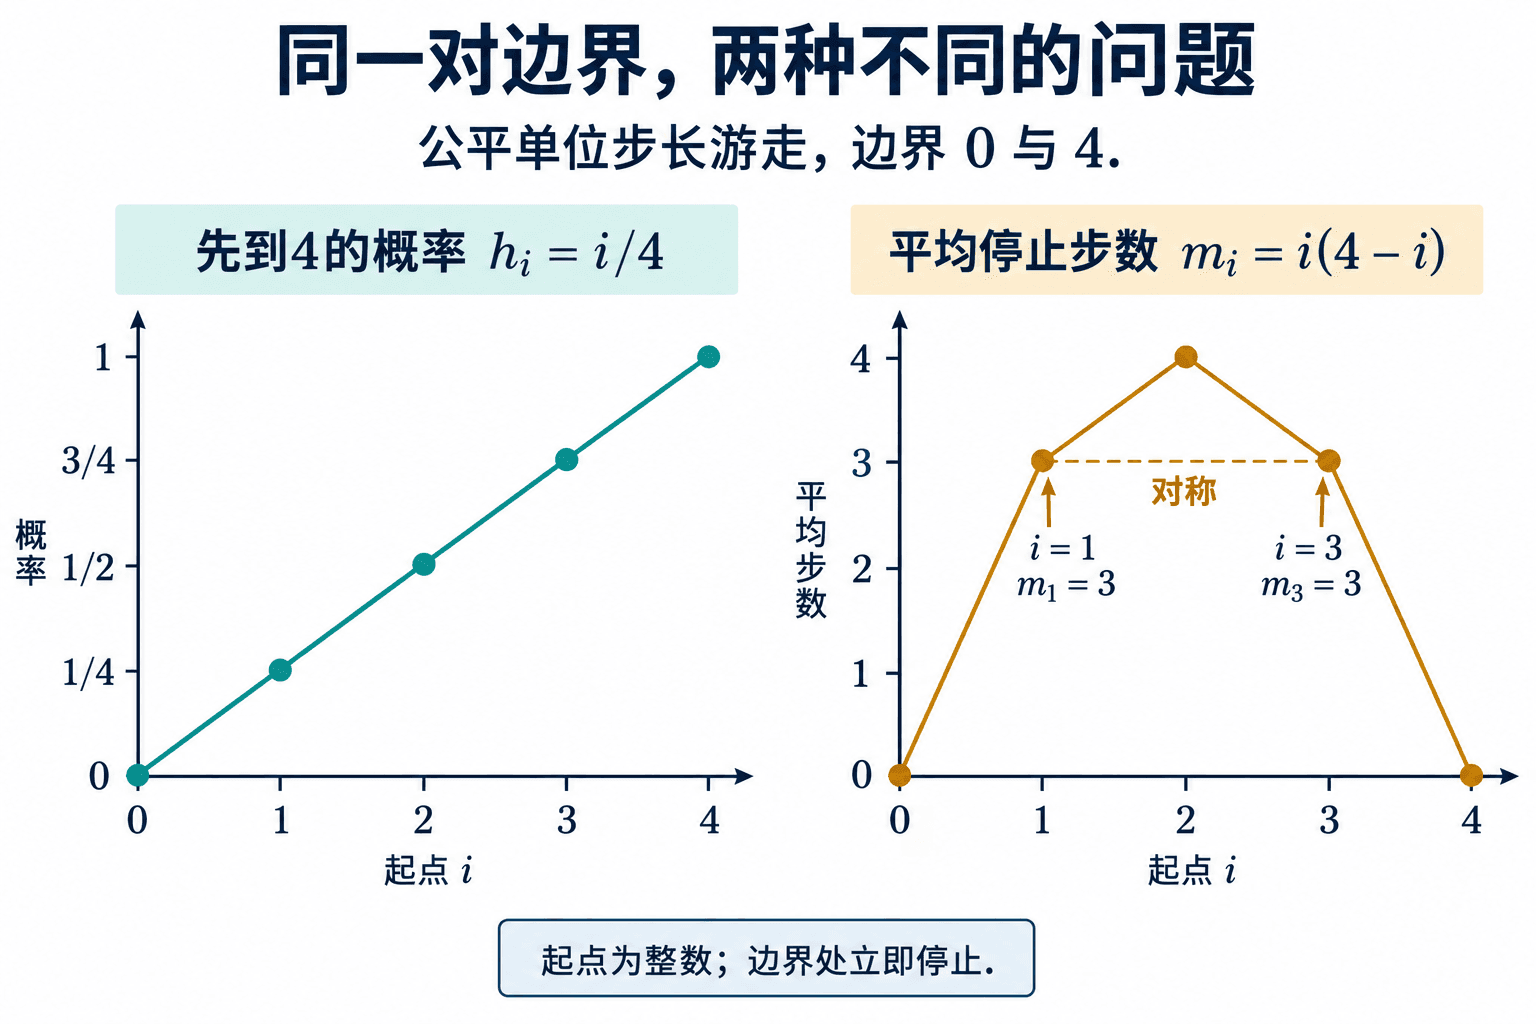
如果边界是整数 a<b,从内部整数 i 出发,把位置平移成 Sn−a,就得到
Pi(Sτ=b)=这里用到了单位步长。若一次可以跳两格甚至更远,停止时可能越过边界,终点就未必恰好是 a,b,上面的两点平均不能原样使用。
有漂移时,换一个条件平均不变的量
回到边界 0,N,设向右概率为 p、向左为 q=1−p,其中 0<p<1 且 。位置本身每步有漂移 ,不能写 。
试着找一个函数 f,满足
pf(s+1)+qf(s−1)=f(s).这是“下一步平均回到当前值”的函数形式。取 f(s)=rs,需要 pr+q/r=1。除了没有信息的常数解 r=,另一个选择是 。因此
Mn=(q/p)Sn是鞅:条件平均的倍率为 p(q/p)+q(p/q)=q+p=1。
在有限区间内,这个停止过程被有限常数控制。前面的分段尾界也仍有效,把每段全向左的概率改成 qN>0 即可,所以停止几乎必然发生,平均时间有限。令 r=q/p,有
ri=EirSτ解得
hi=1−rNp=1/2 时这里出现零除以零,应回到 hi=i/N。也可以约去共同因子 1−r,把比值写成 ;令 ,分子、分母分别趋于 ,得到同一极限。 或 时路径完全确定,分别直接向下或向上走,没必要套指数公式。
同时算出有偏情况下的平均耗时
此前的漂移补偿过程 Sn−dn 也是鞅。停止后,
Ei[Sn∧τ−d(n∧τ)]=位置部分有界;Eτ<∞ 已由尾界证明,因此时间部分可以收敛到 Eτ。得到
Nhi−dEiτ=i,例如 p=2/3,N=3,i=1,有 r=1/2,因此
h1=1−1/81−1/2可以用一步分析独立检查。记从一、二出发的平均时长为 m1,m2,则
m1=1+32m联立得到 m1=15/7,m2=12/7。这次时间公式来自补偿鞅,平方鞅 S 在有偏情况下已经不能照搬,因为平方展开中的 不再消失。
等到赢一元再停,问题出在哪里
让对称游走从零出发,不设亏损下界,只在第一次达到一时停止:
τ=inf{n≥0:Sn=1}.它确实是停止时间,而且几乎必然有限。为了看见后一点,暂时加一个下界 −L,记 τL 为首次到达 {−L,1} 的时刻。有限边界公式给出
P0(SτL=1)=“在负 L 之前先到一”包含在“最终曾经到过一”这个事件中。因此最终到一的概率至少为 L/(L+1),对任意 L 都成立。让 L 增大,得到最终到一的概率为一。
但这并不提供一个有限的平均等待。因为 τL≤τ,而有限边界平均时间为
E0τL=L.所以 E0τ≥L 对任意 L 成立,只能有 E0τ=∞。
停止后 Sτ=1,故 ESτ=1。与此同时,对每个固定 n,停止过程仍是鞅,。哪部分抵消了已经赢一元的路径?
把它分成已停止与未停止两群:
0=ESn∧τ=P(τ≤n)+E第一项趋于一,所以第二项趋于负一。未停止路径所占概率虽然趋于零,但它们的负值越来越难控制,总的期望贡献并没有消失。只看最后都赢一元的路径,会漏掉固定观察时刻仍在亏损的一小群。
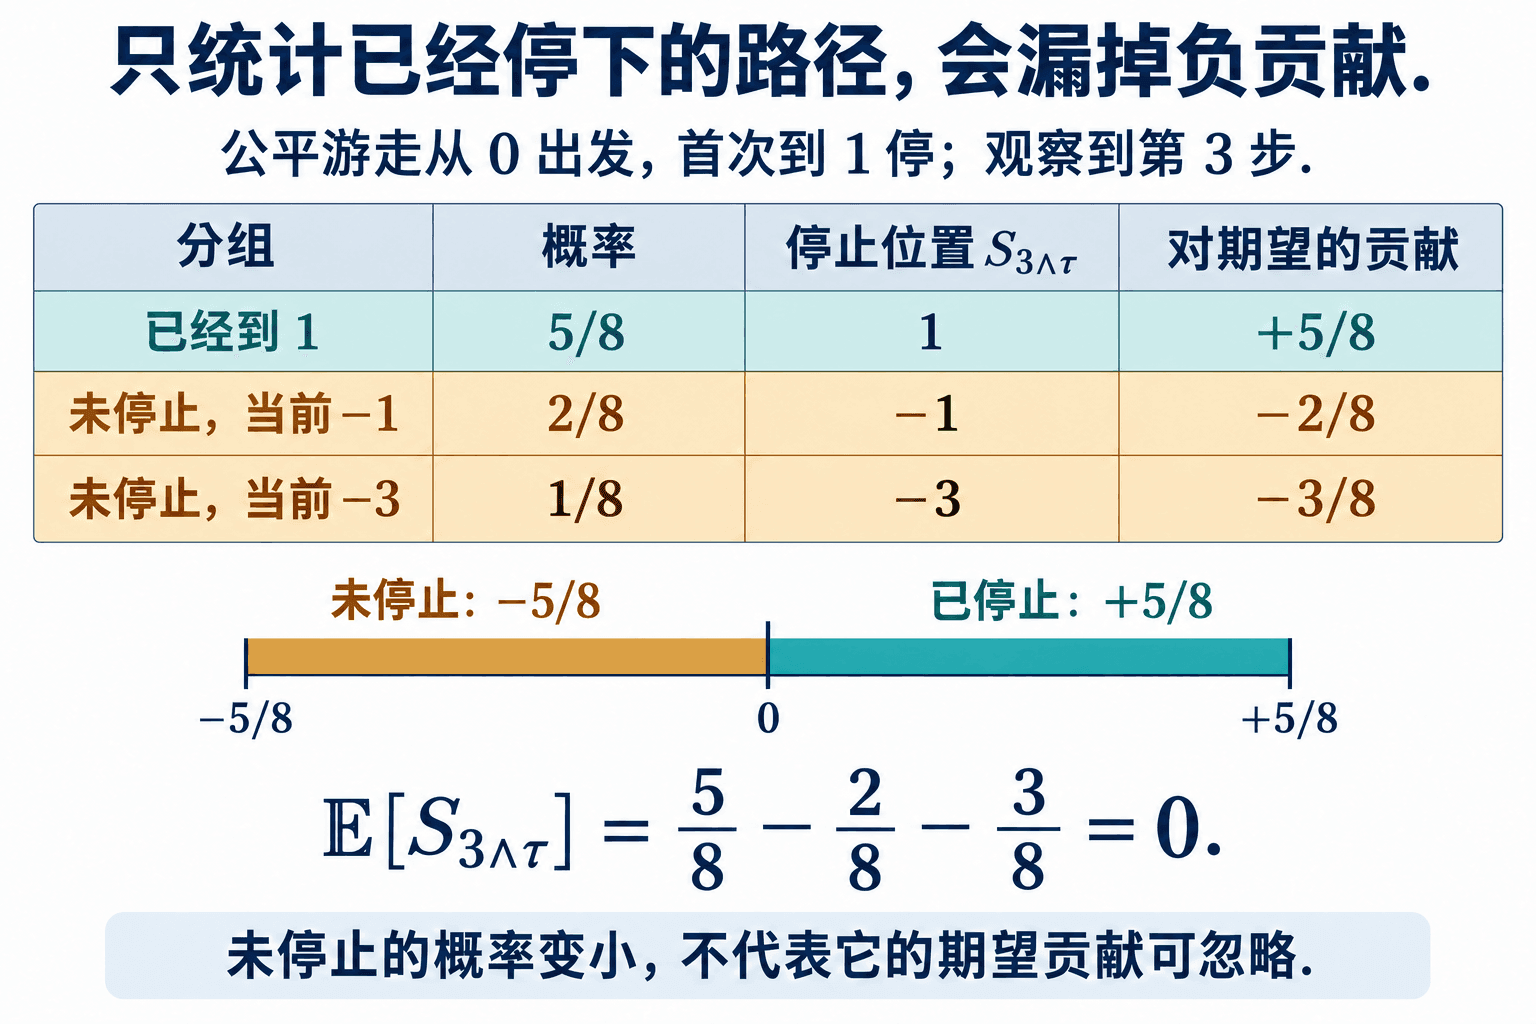
这里不是说“平均停止时间无穷就一定不能使用任何停止结论”。它说明仅有停止时间几乎必然有限、终值可积,还不足以交换极限与期望。实际失败的是对停止过程缺少足够的统一控制;上面的负尾部贡献把这一点直接算了出来。
模拟到了上限,还没停的路径怎样统计
计算机通常只观察到某个固定步数 H。如果一条路径此时还没碰到边界,它贡献的时长是 min(τ,H)=H,不是已知的真实 τ。不能把它删掉,也不能宣布它已在下界停止。
设存活概率为 sn=P(τ>n)。对整数停止时间,逐条路径都有
min(τ,H)=n=0∑H−11{τ>n所以
Emin(τ,H)=n=0∑H−1s这个量随着观察上限增加而增长,但只有在 Eτ<∞ 时才趋于有限的平均停止时间。样本里“已经停止的那些路径的平均时长”则是另一个经过筛选的统计量,通常偏向较早停止的路径。
有限步的精确分布可以逐步推。对尚未吸收的位置 s,把当前概率质量的 p 倍送到 s+1、q 倍送到 s−1;碰到边界的质量留在对应终点,以后不再移动。单侧模式则只在一处吸收,负方向仍继续展开,不能偷偷加一个计算方便的下界。
在两个边界模式中取 N=8,i=3,p=1/2,把 3/8 与十五步作为最终理论预测。逐渐增加观察上限,核对“已到上界”“已到下界”“仍未停止”的概率之和,同时观察截断平均时长怎样接近十五。再改成单侧首次到一:到达概率会增大,截断平均也会继续增大;把停止位置的期望拆成已停止与未停止两部分,就能看见为什么不能把后者扔掉。随机样本用于对照,逐步分布计算给出有限观察窗的精确基准。
练习
1.均值相同不等于鞅
令 ξ 等概率取正负一,M0=0,M1=ξ,M,信息为已经观察到的这些变量。三个均值是否相同?这个过程是不是鞅?若只观察到零时刻,预测第二步的期望又是多少?
三个无条件均值都为零。但 E(M2∣F1)=−M1,所以不是鞅。从零时刻看,尚不知道 ,仍有 。两种预测使用的信息不同,不能互相替代。
2.会改变的到达概率
每一步至多到达一人。第一步到达概率为 1/2;从第二步起,若上一步有到达,本步到达概率为 3/4,否则为 1/4。写出累计到达数的补偿鞅,解释为什么减去固定的 n/2 一般不能验证一步条件平均为零。
令 p1=1/2,pk=1/4+I 对 成立。取
3.金额规则和服务费
公平硬币下,第一轮金额为一,此后若上一轮是反面则金额为二,否则为一。证明前 n 轮总收益是鞅。如果每轮另付固定服务费 ε>0,扣费后的收益属于鞅、次鞅还是超鞅?
Hk 由 Fk−1 确定,且 1≤H。因此 适应、固定时刻有界,下一步条件平均增量为 。
4.从支付反推逐步预测
公平硬币抛两次,只有两次都是正面才支付四元,其余支付零。写出 M0,M1,M2 的各个可能值,并逐节点核对它是最终支付的条件期望过程。
M0=4(1/4)=1。第一次正面时,最后支付四或零,各概率一半,所以 M1=2;第一次反面时不可能再满足条件,。
5一个过程每个时刻的无条件均值都相同,就足以证明它是鞅。
6.什么时候可以决定停下
对公平硬币的自然过滤,判断下列规则:第一次连续出现两次正面;前三次中最后一次正面所在的位置(没有正面时取三);若第一枚正面就在第一步停,否则第二步停。对合法规则说明如何实时判断,对不合法规则给出两条此前记录相同却要求不同决定的路径。
第一次连续两次正面是停止时间,到第 n 步检查已有相邻结果即可。第三个规则也是停止时间:第一步后已经知道是否应停;否则第二步必停,且停止时间被二控制。
“最后一次正面”不是停止时间。第一步都是正面的两条路径“正反反”和“正正反”,分别要求在第一步和第二步停。站在第一步不能区分它们,却被要求作出不同决定。
7.有界停止可以直接枚举核对
从 S0=0 开始公平游走,若第一步为正就停,否则再走一步后必停。列出停止位置的分布,求 ESτ 和 Eτ。为什么第二个均值不应等于零?
第一步正面,概率 1/2,停止位置一、时长一;先反后正,概率 1/4,位置零、时长二;两次反面,概率 1/4,位置负二、时长二。所以
ES8.换一组边界
单位步长对称游走从一出发,碰到负二或五即停。求先到五的概率和平均步数。若每步可以跳正负二,为什么不能沿用刚才的两个答案?
平移后下界零、上界七、起点三,所以命中上界概率为 3/7,平均时长为 3⋅4=12。
步长改成二时,起点一只能访问奇数,根本到不了负二。即便把规则改为首次越过边界,停止值也不再恰为负二或五。例如向下会越到负三。必须重新写停止状态和模型,不能只保留原公式。
9.有偏首达要选对鞅
向右概率为 1/3,在零与三之间从二出发。求先到三的概率和平均停止步数。指出错误地使用 ESτ=S0 会给出什么答案。
r=q/p=2,故
h2=1−10.只观察两步时,哪些路径还在走
对称游走在零与四之间从一出发,只观察到 H=2。求已经到下界、已经到上界、尚未停止的概率,以及 Emin(τ,2)。再核对停止位置的期望。
第一步向左,概率 1/2,已经在零停止。第一步向右后,第二步分别到一、三,各概率 1/4,都未停止。所以下界概率 1/2、上界概率零、存活概率 1/2。
截断平均时长为 (1/2)⋅1+,也等于 。截断位置的均值为 ,仍等于起点。真正平均停止时间为 ,不是当前观测得到的 。
11.单侧首达的负贡献
从零开始的对称游走首次到一时停止。只观察前三步,列出未停止路径在第三步的位置及概率,计算已停止与未停止两部分对 ES3∧τ 的贡献。
第一步为正的路径已经停止,概率 1/2;路径“反正正”在第三步首次到一,概率 1/8。已停止总概率为 5/8,终值一,贡献 5/8。
未停止的路径为“反正反”“反反正”“反反反”,各概率 1/8,第三步位置分别为负一、负一、负三。贡献为 (−1。两群相加为零。若把未停止的路径删去,剩余平均当然是一,但已经不再是原来的全体期望。
12.停止了位置,时钟也要停止
有人证明 Sn2−n 是公平游走的鞅后,把“到边界就不再移动”的过程写成 Sn∧τ2−n,并声称它仍是鞅。指出停止后的条件增量,并写出正确形式。
在 τ≤n 的事件上,平方位置不再变化,但减去的时间从 n 增为 n+1,所以下一步增量恒为负一,不是零。正确的停止过程是
Qn