样品采集、制备与预处理
引言:仪器再准,也救不回一份“拿错了”的样品
某工厂收到一批颜色深浅不一的颗粒原料。你从表面抓一把,送进再灵敏的仪器,读数稳定、重复性也很好。那这个结果能代表整批原料吗?未必。深色颗粒可能沉在底部,细粉可能集中在一侧;你测得很准的,也许只是“这一小把”的组成。
这正是分析工作最容易被低估的地方:仪器回答的是送到它面前的试样,而不是自动回答你原来关心的总体。 从总体到最终测量之间,要经历采集、保存、制备和预处理。每一步都在决定“我们究竟测谁、测什么状态、结果能代表什么”。
这一章不教一套放之四海皆准的操作配方。你要建立的是一套先问问题、再作选择、最后留下证据的判断框架:明确待测量 → 制定采样计划 → 让样品保持可追溯 → 使待测组分进入适合测量的状态 → 检查有没有污染、损失或变化。
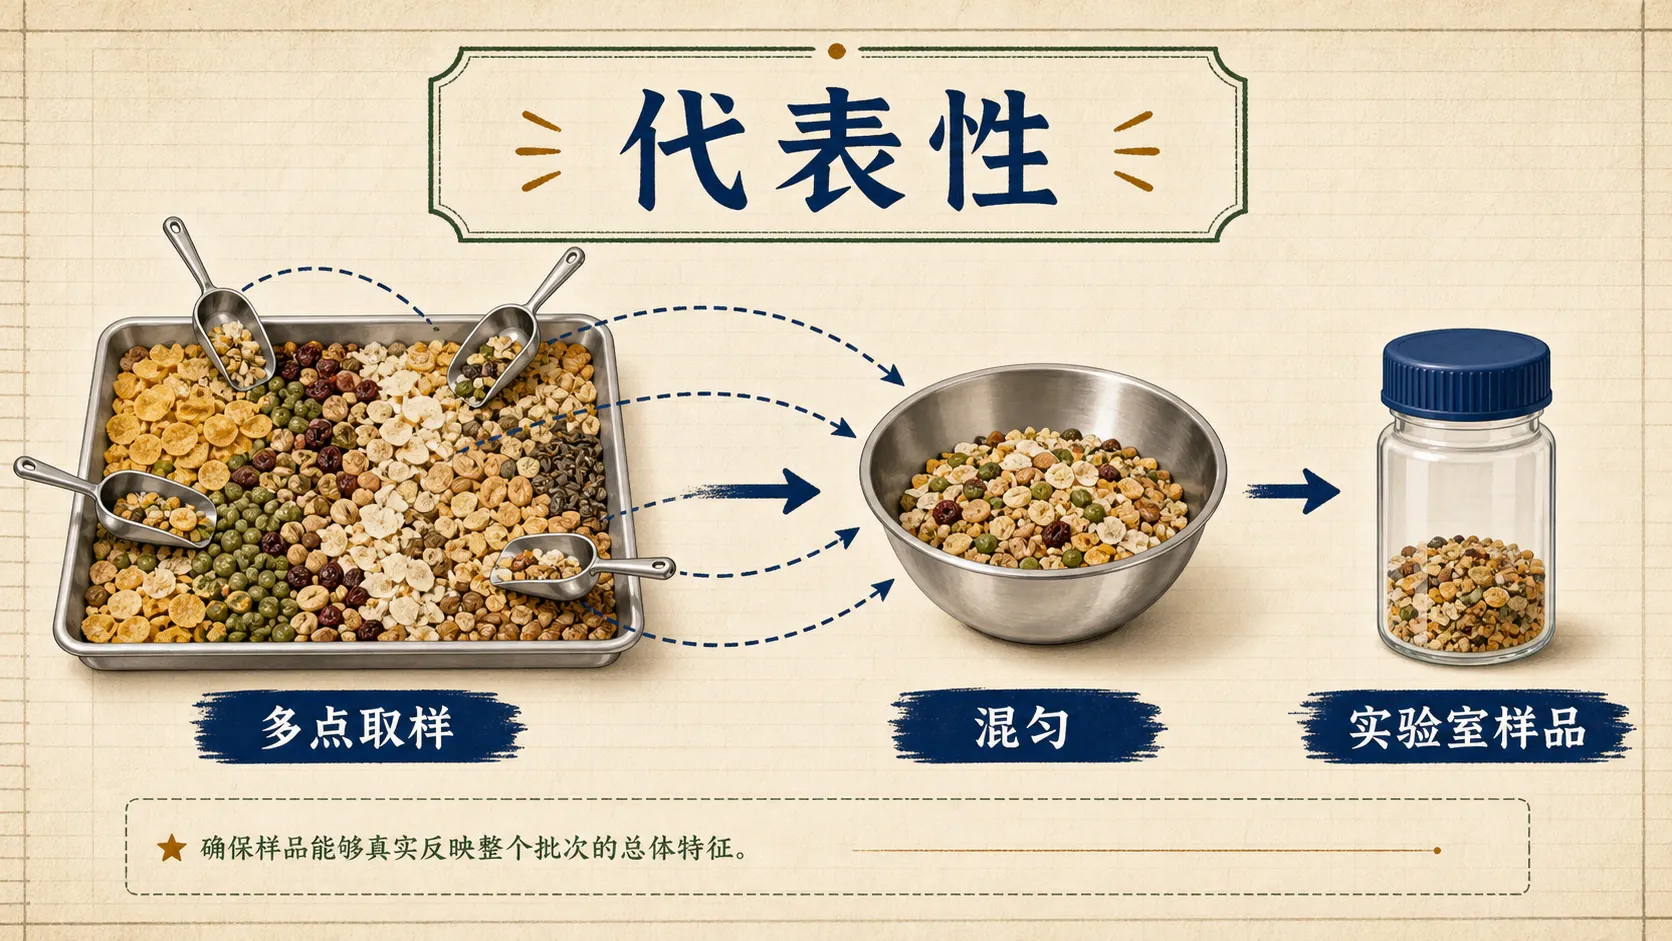
一、采样不是“取一点”,而是替总体发言
1. 先把问题问完整:你要测的到底是什么?
一杯浑浊河水摆在面前,题目若问“某元素的总含量”,你不能一上来就过滤;过滤会把颗粒物留在膜上,之后测到的是滤液中那一部分。反过来,若问题本来就是“滤液中可测到的某离子浓度”,过滤可能正是定义的一部分。看起来只差一个动作,实际改变了待测量的边界。
所以采样前先写一句完整的话:在什么总体、什么位置或时段、以什么状态,测哪个组分。 例如“比较三台反应釜出料中某组分的批次平均含量”和“找出哪一台反应釜的出料异常”都在测同一种组分,但前者可以考虑合成样,后者必须保留分釜信息。
分析记录里常把样品沿着一条明确的链条交接:
- 总体(或批、母体):你希望结论适用的全部对象,例如一车原料、一天的出水或一批产品;
- 初级样:从总体不同位置、时段或单元取得的一份份样品;
若分析目的需要平均信息,初级样可按预先规定的规则合成为合成样;它描述的是采样计划中的合并动作,不是“实验室样品”的同义词。随后,送达实验室或由实验室接收的样品称为实验室样品。实验室样品经干燥、粉碎、混匀、缩分等必要制备后形成试样;若不需要制备,试样可以与实验室样品相同。最后,从试样中取出用于一次测定或分析的确定量,才是试份。试份小,不等于它不必代表总体;代表性的证据应该在前面的采样和制备链条中已经建立。
你可能会问:“那我多取一点总可以吧?”注意,这是个陷阱。样品量多,只会让同一个偏位置的错误取样更重;它不能替代覆盖不同位置、不同时间和不同批次。代表性来自覆盖和抽取规则,不来自样品瓶看上去很满。
先写清待测量,才能判断某个动作是不是合理。例如“过滤”“烘干”“合并”都不是中性的按钮:它们可能在定义测量对象、改变浓度基准,或把原本应分别比较的信息混在一起。方法选定前,先让分析目的说话。
2. 不均匀时,怎样让取样不偏向“看起来方便”的地方?
总体可能沿空间、时间或组成分层。罐底与罐顶不同,河流近岸与中心不同,连续生产的换班前后也可能不同。看到这种可能性,不要机械地背“随机”两个字,而要问:不均匀性可能藏在哪里?
- 随机取样适合总体单位没有已知分层、且希望每个单位都有相近机会被抽到的情况。随机不是随手抽;它需要事先规定可抽取的单位和抽取办法。
- 分层取样先按与分析目标有关的层次分开,例如不同深度、不同包装规格、不同班次,再在每层内抽取。它的价值是防止一个很方便到达的层把其他层淹没。
- 系统取样按固定时间间隔、固定空间间隔或固定件号取样,便于连续过程执行。但若过程本身也有同周期波动,固定间隔可能总撞上同一相位;通常先随机选择起点;若取样间隔恰与过程周期重合,还须改变间隔或采用随机化时点,单独更换起点不能保证消除周期偏倚。
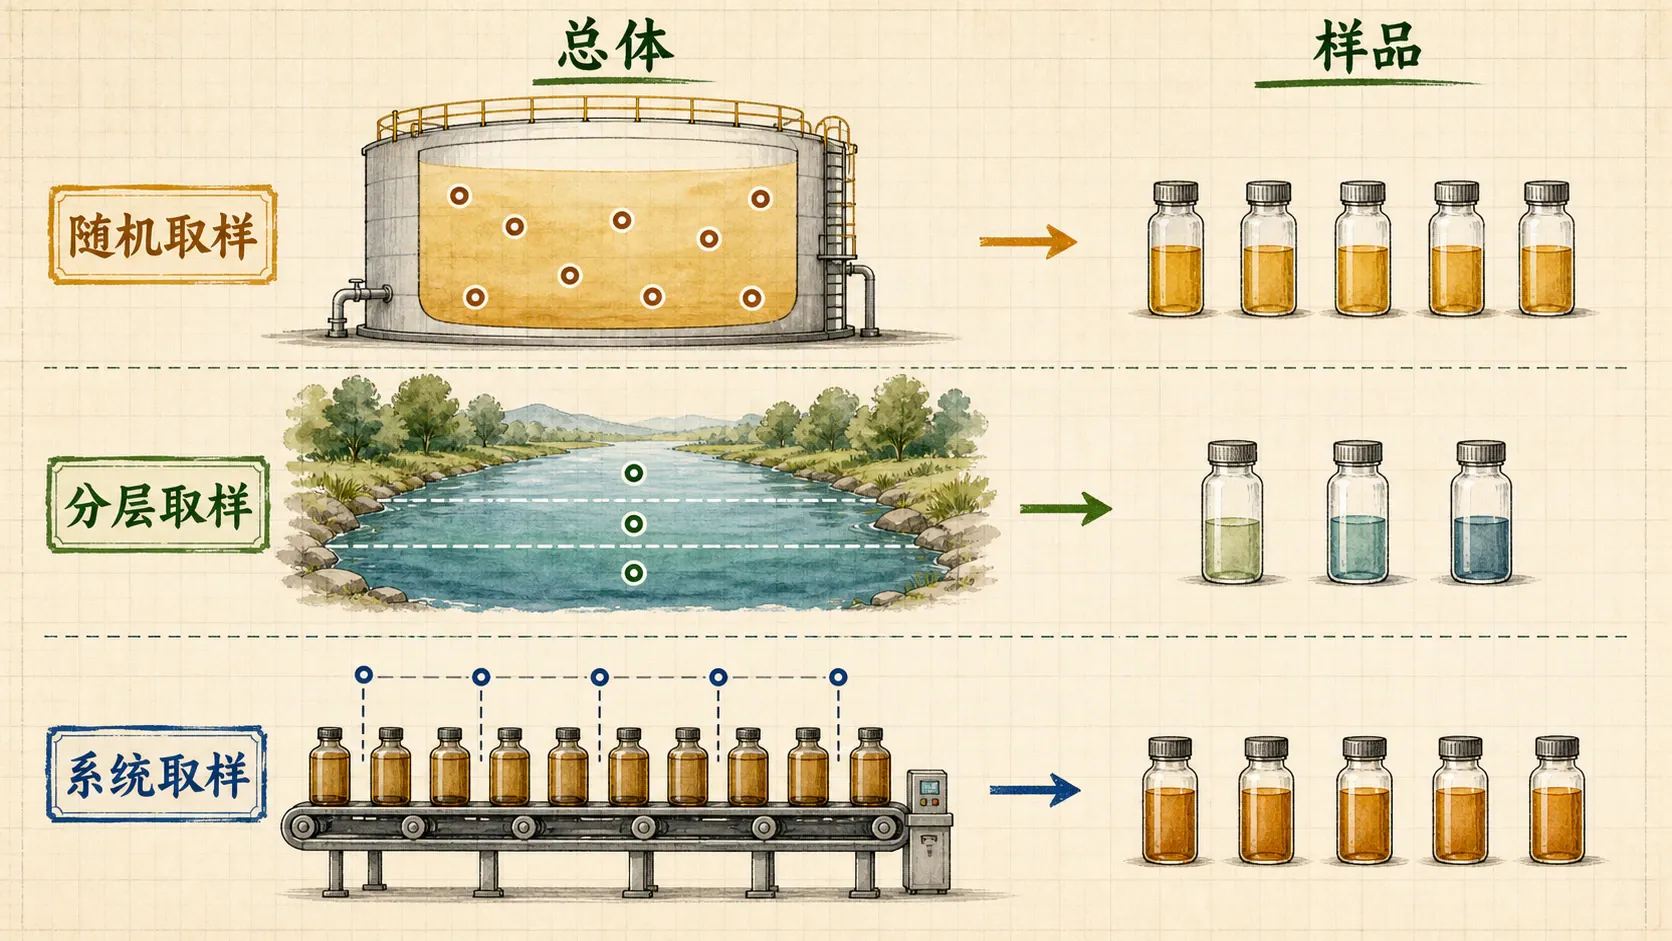
不妨先想一个场景:一条河横向混入排口水,近岸、中部、远岸颜色不同。只在岸边装满三瓶水,算不算“三次平行”?可以构成该近岸位置的现场平行样,但不能代表整个横断面的三份独立代表性样品。它们最多说明近岸位置的重复取样情况,却没有覆盖横向差异。若你的问题是河段平均状况,需要先把横向位置纳入采样计划;若你的问题是排口影响范围,则还需要保留每个位置的身份,不能过早混成一瓶。
在交互中分别处理“分层颗粒”“河段”和“连续批次”。你会看到,同样是取多个点,是否保留分层信息、是否选择合成样,取决于你的结论要回答“平均值”还是“差异在哪里”。
3. 采样计划里,哪些信息必须能让别人复盘?
一份可用的采样计划不只写“取样三份”。至少要把总体与待测量、采样单元、位置或时间、容器与保存条件、合成或不合成的规则、样品编号以及异常情况写清。这样,别人才能判断结果适用的范围,也能在出现异常时追查链条。
容器、工具和标签看似琐碎,却常是污染和混样的入口。要让接触样品的材料与待测组分、后续方法相容;要防止前一份样品残留进入下一份;要在现场就标注身份、时间和状态,而不是回到实验室凭记忆补写。对于需要质量控制的任务,还应按计划设置空白、平行样或加标回收等检查。它们不是为了“凑项目”,而是分别帮助你发现环境或器皿带来的污染、采样/处理的重复性问题,以及处理过程中的损失或基体影响。更系统的误差评价和质量控制会在后续章节继续展开。
二、制备的目标是缩小质量,不缩小代表性
1. 为什么“从上面抓一把”常常不可靠?
固体样品通常不能把整袋、整车都送进仪器。实验室接收实验室样品后,必要时经干燥(是否需要先由待测量决定)、粉碎、混匀、缩分形成试样;再从试样中取确定量作为试份用于一次测定。听起来像把大样变小样,真正的难题却是:每减一次量,组分有没有被重新偏向某一侧?
想象一袋土壤中混有粗颗粒、细颗粒和少量碎屑。粗颗粒容易滚到边缘,细粉容易沉到局部。你若只从上层抓一把,取到的粒度和组成可能都偏离总体。先适当粉碎、再充分混匀、再按规则缩分,目的不是把样品“处理得好看”,而是让每一次减量尽可能不偏袒某种颗粒或某个位置。
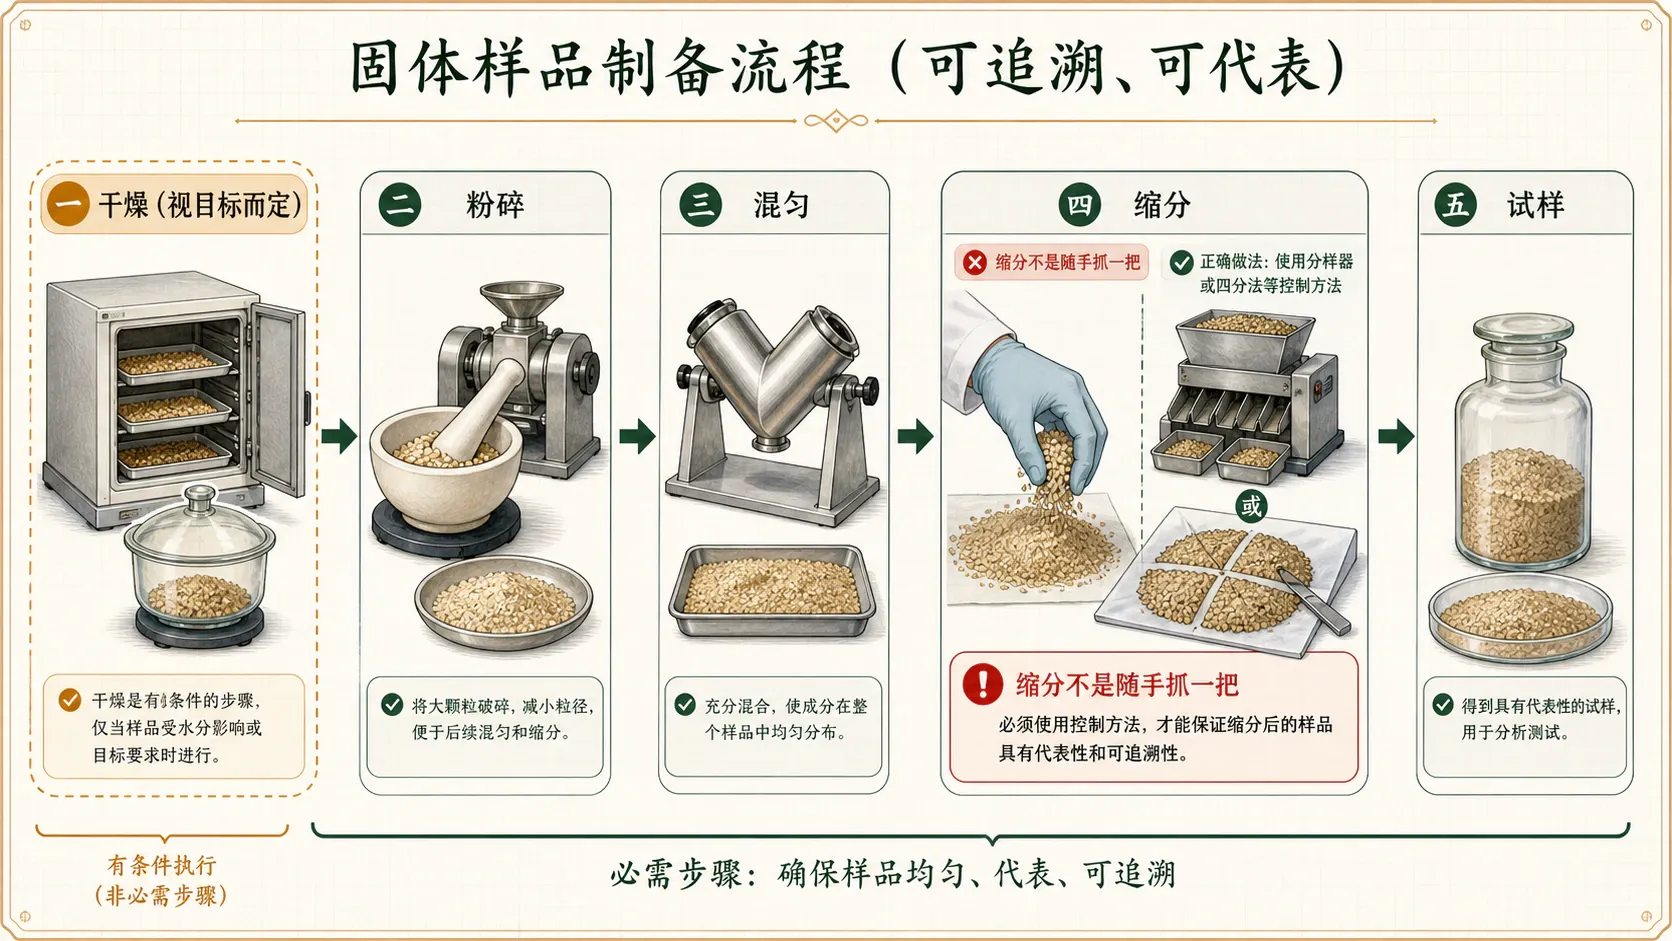
常见的缩分思路包括把均匀铺开的样品按规则分成若干部分、取对角部分后再混合的四分法,以及用分样器让颗粒交替进入多个接收槽。它们的共同点不是某个固定动作,而是让“保留哪一部分”不由手伸得最方便的位置决定。对粒径差别很大、易吸湿、易挥发或可能在研磨中被污染的样品,制备条件要另行验证;把粉碎或干燥当作一律必须的步骤,反而会改变待测量。
干燥能让某些固体更易研磨和按干基比较,却可能损失挥发性组分或改变样品中的水分状态;研磨能提高均匀性,也可能带来工具磨损污染或发热。先问“待测组分会不会在这一步离开或变化”,再决定是否做、怎样做,并把条件记录下来。
2. 例题:平均质量和“找异常”为什么不能共用一瓶合成样?
例题:四个等质量储料仓分别装有同一批粉体。任务 A 是报告整批的平均某元素含量;任务 B 是判断是否有某个储料仓异常。怎样采样与处理?
你可能会说:“每仓取一点混起来,两个任务都省事。”这正好把两个问题偷偷合并了。合成样擅长回答平均水平,却会抹掉仓与仓之间的差别。
先区分结论对象。任务 A 的对象是四仓合起来的整批平均,任务 B 的对象是每一仓的单独状态;因此任务 B 必须让每仓样品的身份保留下来。
在每个储料仓内,按预先规定的位置或深度取若干初级样,避免只取表层;把同一储料仓内、符合目的的初级样混匀后,可以形成该仓的代表性样品。
若四仓质量相等,任务 A 可从四个已保留身份的仓样中按相同质量取份额、混成合成样,或分别测定后按同样权重计算平均。两种路线都应保留原始仓样与合成规则。
任务 B 则测定四个仓样,比较结果是否存在异常。若一开始就把四仓全混成一瓶,即使测出平均值,也无法倒推异常来自哪一仓。
答案的关键不是“合成样永远好”或“永远不好”,而是它压缩了空间或批次差异。要平均,就按可说明的权重合成;要找差异,就别过早把差异混掉。
试着先不混匀就缩分,再改成混匀后使用规则缩分。模拟的数字不是替代真实验证,而是让你看见偏差怎样从“抓一把”的动作中被放大。
三、预处理不是做得越多越好,而是只做必要的转移与分离
1. 三个问题决定路线:组分、基体、后续方法
原始样品往往不能直接测量:泥水会堵塞或干扰测量,固体中的元素需要先转入溶液,低含量组分的信号可能被背景淹没。但“多做几步”不等于更可靠;每多一步,就多一次污染、损失和化学形态改变的机会。
因此,预处理前依次问三个问题。
- 待测组分是什么状态,要报告什么边界? 是总量、滤液中的部分,还是某种特定形态?
- 基体在妨碍什么? 是颗粒、油脂、盐分、颜色,还是浓度太高/太低?
- 后续方法需要样品呈什么状态? 需要澄清溶液、适当浓度、去除干扰,还是把目标从固体转入溶液?
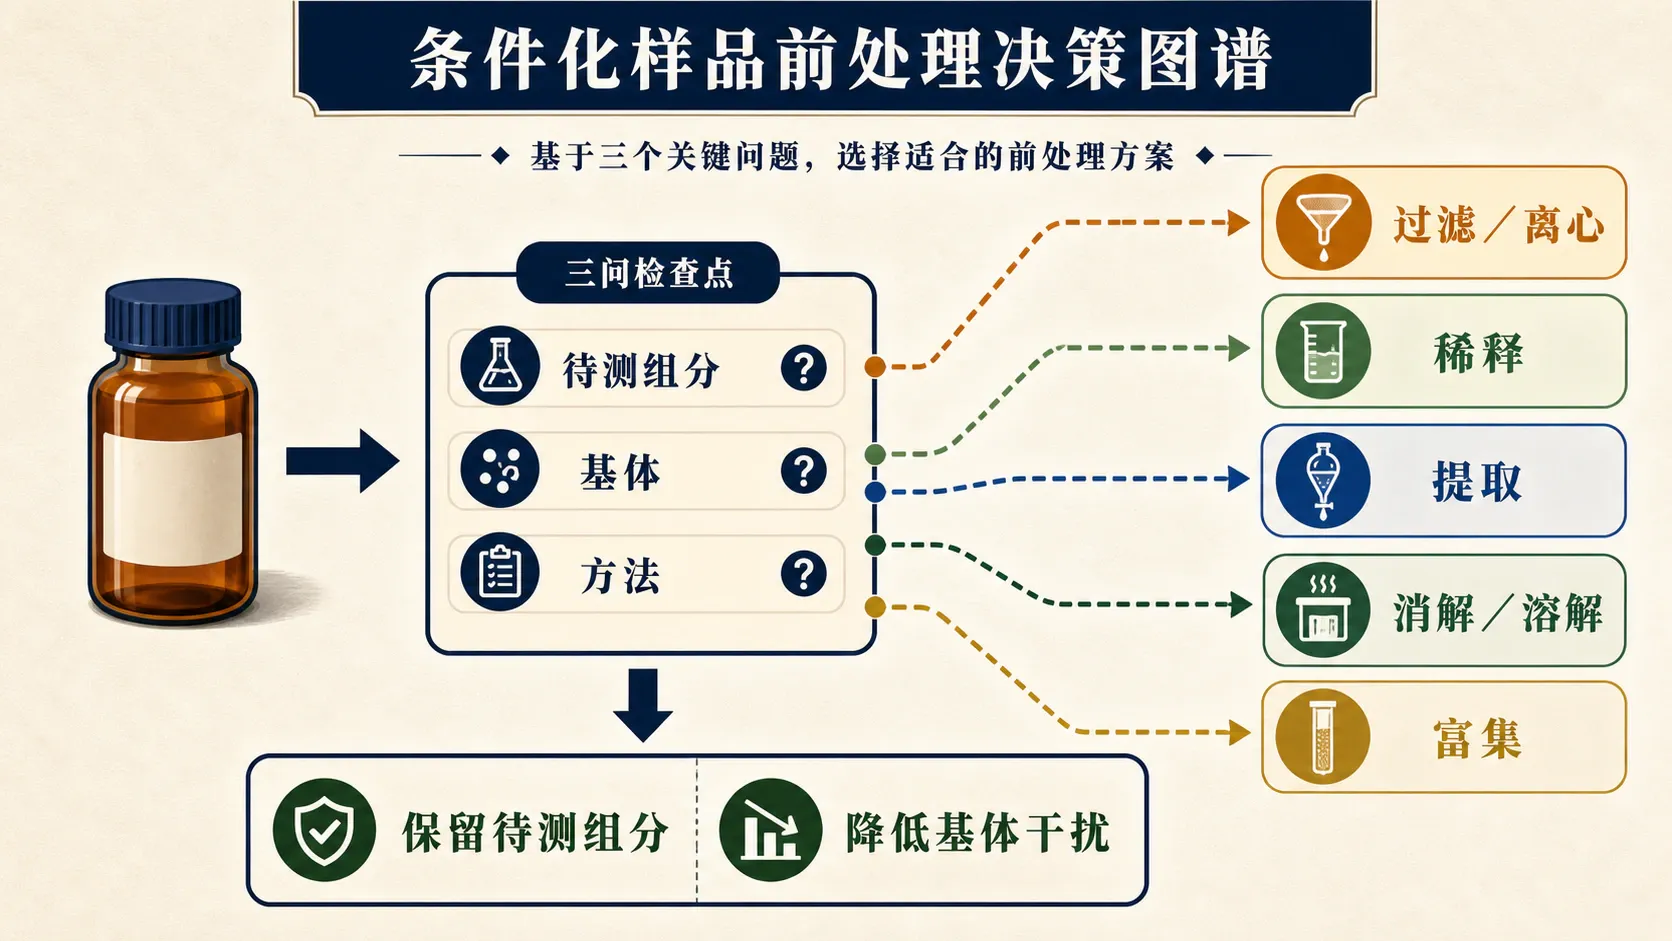
在这个框架下,过滤或离心用于把颗粒与液相分开;稀释把浓度调入方法适用范围;提取把目标组分转移到更适合测量的相;消解或溶解使固体基体中的组分进入溶液;富集则在含量低时提高可测信号。每个动作都要接着问一句:目标组分是否仍被完整、稳定、可追溯地保留在我要测的那一相里?
注意,过滤并不自动等于“更干净、更正确”。它会把颗粒留住,从而可能改变报告对象;提取或消解也不自动等于“全部转移”,必须考虑回收、空白和处理条件。具体试剂、温度、时间和器皿选择必须服从经验证的方法与实验室安全要求,不能从一张通用流程图里直接照搬。
预处理的目标是让待测量进入可测状态、降低与该测量无关的干扰,而不是把样品变得越“纯”越好。若一个动作会带走待测组分、改变其形态,或把“总量”换成“滤液中的部分”,它就必须被重新审查、记录并用合适的质量控制证据支持。
2. 案例:同一瓶浑浊水,先过滤还是先保存?
现场拿到一瓶含悬浮物的水样,大家常抢着问:“先过滤吗?”更好的第一个问题是:“本次报告的待测量是总量,还是滤液中部分?”
- 若测量对象包含颗粒与液相,过滤会改变对象,不能把“过滤后的结果”称为原待测量的总量;
- 若测量对象明确定义为滤液中部分,过滤就是路线的一环,但滤膜、时间、保存和容器都要纳入记录;
- 不论哪一种,样品在运输和等待中都可能继续发生沉降、吸附、挥发或反应。应依照选用方法的规定采取合适的避光、密闭、控温或稳定化措施,并记录异常;不要凭经验给所有样品套同一种保存处理。
这时你已经在做分析化学最重要的取舍:不是问“哪一步最常见”,而是问“哪一步仍忠实于我要报告的量”。
在三个案例中分别选择路线,并特别留意每个选项下方的“保留什么、去除什么、最可能错在哪里”。这比只记住“过滤、提取、消解”几个词更接近真实决策。
四、在送去测量之前,做一次损失与污染检查
采样和预处理像一条传递链。链上的任何一个环节都可能让目标组分减少、增加或换了形态:容器吸附、挥发、光照或氧化还原变化会造成损失或转化;工具、试剂和空气尘埃可能带来污染;混样、标签或记录错误会让一份本来正确的结果失去身份。
此时不必急着背很多质控术语,先掌握三个朴素问题:
- 有没有不该出现的东西进来? 用空白等方式检查环境、容器和试剂带来的背景;
- 同一流程重复一次,结果是否接近? 用平行样观察采集与处理的稳定性;
- 目标经过这条路线后还回得来吗? 用加标回收或合适的对照材料检查损失和基体影响。
它们不会替你自动修正一个失败的采样计划,却能尽早暴露问题。下一章会把误差、有效数字和数据处理系统化;本章先把一个习惯钉牢:看到离奇结果,先追问样品链条,再怀疑仪器。
一份能站得住的分析结果,至少应能回答四件事:它代表哪个总体;待测量如何定义;样品经历了哪些会改变组成的步骤;又用什么证据检查污染、损失和混样。把这些写进记录,结果才有可解释的边界。
本章练习
1
要比较一条河横截面近岸、中部和远岸的差异,下列做法最合适的是?
2
关于样品制备与预处理,下列说法正确的是?
3
把样品减量时,先充分混匀、再按规则分取的核心目的,是尽量保持样品的 ____。
4
只要仪器校准合格且重复测定结果接近,最初采样位置的偏差就可以被消除。
练习 5:给“先过滤”补上前提
同学说:“水样有悬浮物,所以一定先过滤,结果更可靠。”请指出这句话缺少的首要前提,并说明若任务是测水样中目标元素的总量,为什么不能直接套用这句话。
练习 6:平均值与异常定位
四个等质量储料仓的粉体需要分析。请分别说明:报告整批平均组成时,怎样利用仓样形成合成样或平均结果;判断哪一仓异常时,为什么不能一开始就把四仓样混合?