自在学

我们与你共同进步

  • 分类课程
  • 文章
  • 工作台
  • 订阅

  • 关于我们
  • 隐私政策
  • 使用条款

探索

  • 分类课程
  • 文章
  • 工作台
  • 订阅

网站信息

  • 关于我们
  • 隐私政策
  • 使用条款

加入社区

自在学学习社区微信二维码

微信扫码,交流学习

株洲市自在学教育科技有限公司© 2025 - 2026 版权所有

© 2025 - 2026 株洲市自在学教育科技有限公司 版权所有

湘公网安备43020302000292号|湘ICP备2025148919号-1
分类课程工作台文章订阅
分类课程工作台文章价格

数理统计 I

  1. 01统计模型:把问题变成可检验的假设
  2. 02抽样分布:正态、卡方、t 与 F
  3. 03估计量的评价:偏差、方差与一致性
  4. 04矩估计:用样本特征解出参数
  5. 05最大似然:让已观察的数据得到合理解释
  6. 06充分统计量:压缩数据而不丢参数信息
  7. 07信息与最优性:估计精度的界限
  8. 08大样本推断:从极限到标准误
  9. 09置信区间:构造并解释覆盖保证
  10. 10检验原理:错误率、功效与最强检验
  11. 11似然比、Wald 与得分:三条检验路径
  12. 12综合推断:正态线性模型与可复核报告
正在加载课程章节内容
课程数学数理统计 I统计模型:把问题变成可检验的假设

模型说明要能让别人按同样的规则重做研究。哪些信息被记录下来、哪些已经丢失,会决定后面的推断能走多远。

1. 同样的比例,不同的抽样波动

10 人里有 6 人成功,1000 人里有 600 人成功,两组的成功比例都是 0.6。光看这个数,看不出估计有多稳。换一批人,比例通常会变;小样本尤其容易偏离原来的结果。不过,人数的比较还有个前提:如果这 1000 次记录全来自同一个人反复尝试,就不能直接当成 1000 位不同参与者的数据。每一行代表谁、是怎样收集来的,需要在计算之前弄清楚。
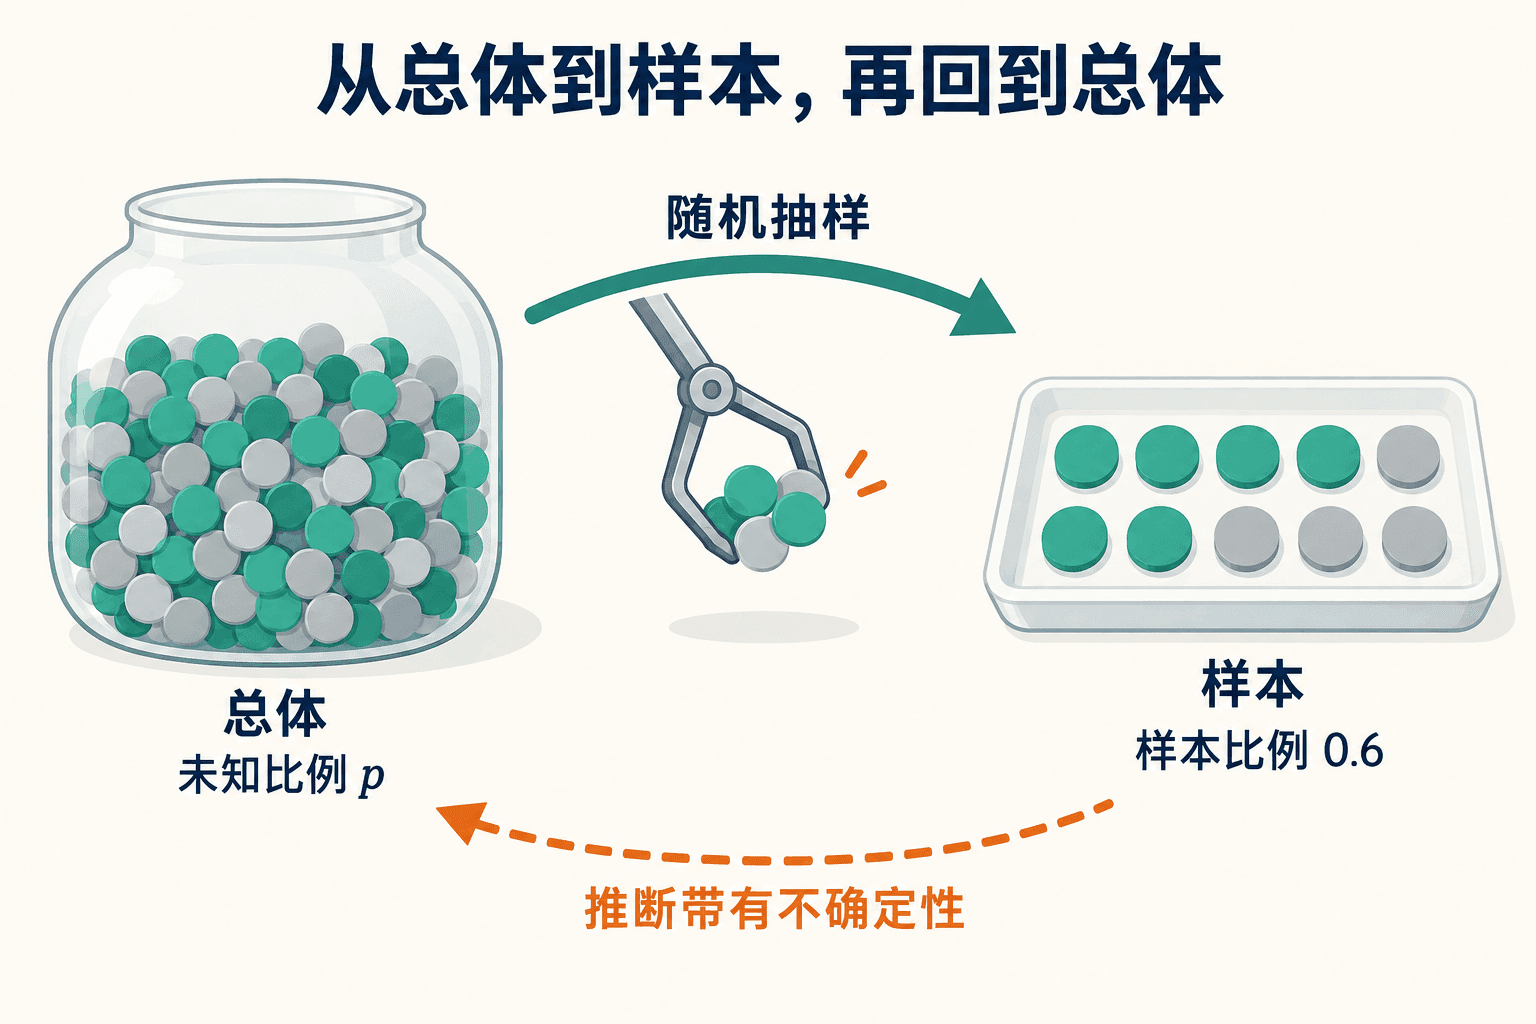
总体与样本
图 1-1:总体与样本

图中的抽样箭头从总体指向样本,推断则沿相反方向寻找总体的信息。样本只留下了部分记录,不确定性也由此产生。后面给出的概率保证,都依赖相应的模型条件。

一次操作是否成功,可以用伯努利模型描述;设备的等待时间需要连续正值模型。到研究测量值怎样随输入变化时,正态线性模型会派上用场。这些情境和数字均为独立设计的教学构造,不代表真实平台表现。

同一个 60%,可以支持完全不同的结论

设两份记录都写着“100 次操作,60 次成功”。甲来自随机抽取的 100 位用户,每人首次尝试一次;乙来自一位熟练用户连续尝试 100 次。两个表格的平均数相同,但回答的问题并不相同。甲有机会描述目标用户的首次成功率;乙主要反映一个人在这段时间里的表现,还混入了练习效应。

甲的一行对应一位用户。乙虽然也有 100 行,背后却只有一个人的习惯和练习过程,后面的表现可能受前面的尝试影响。表格多了一行,不一定就多了一份独立信息。 目标人群或采集方式弄错了,标准误算得再精细也回答不了原来的问题。

模型说明需要交代清楚目标人群与采集规则。比如,“新用户”是否包括用过旧版界面的人,会直接影响成功率所描述的对象。这里所有数值场景均为教学构造。

2. 采集前的随机变量与采集后的观测值

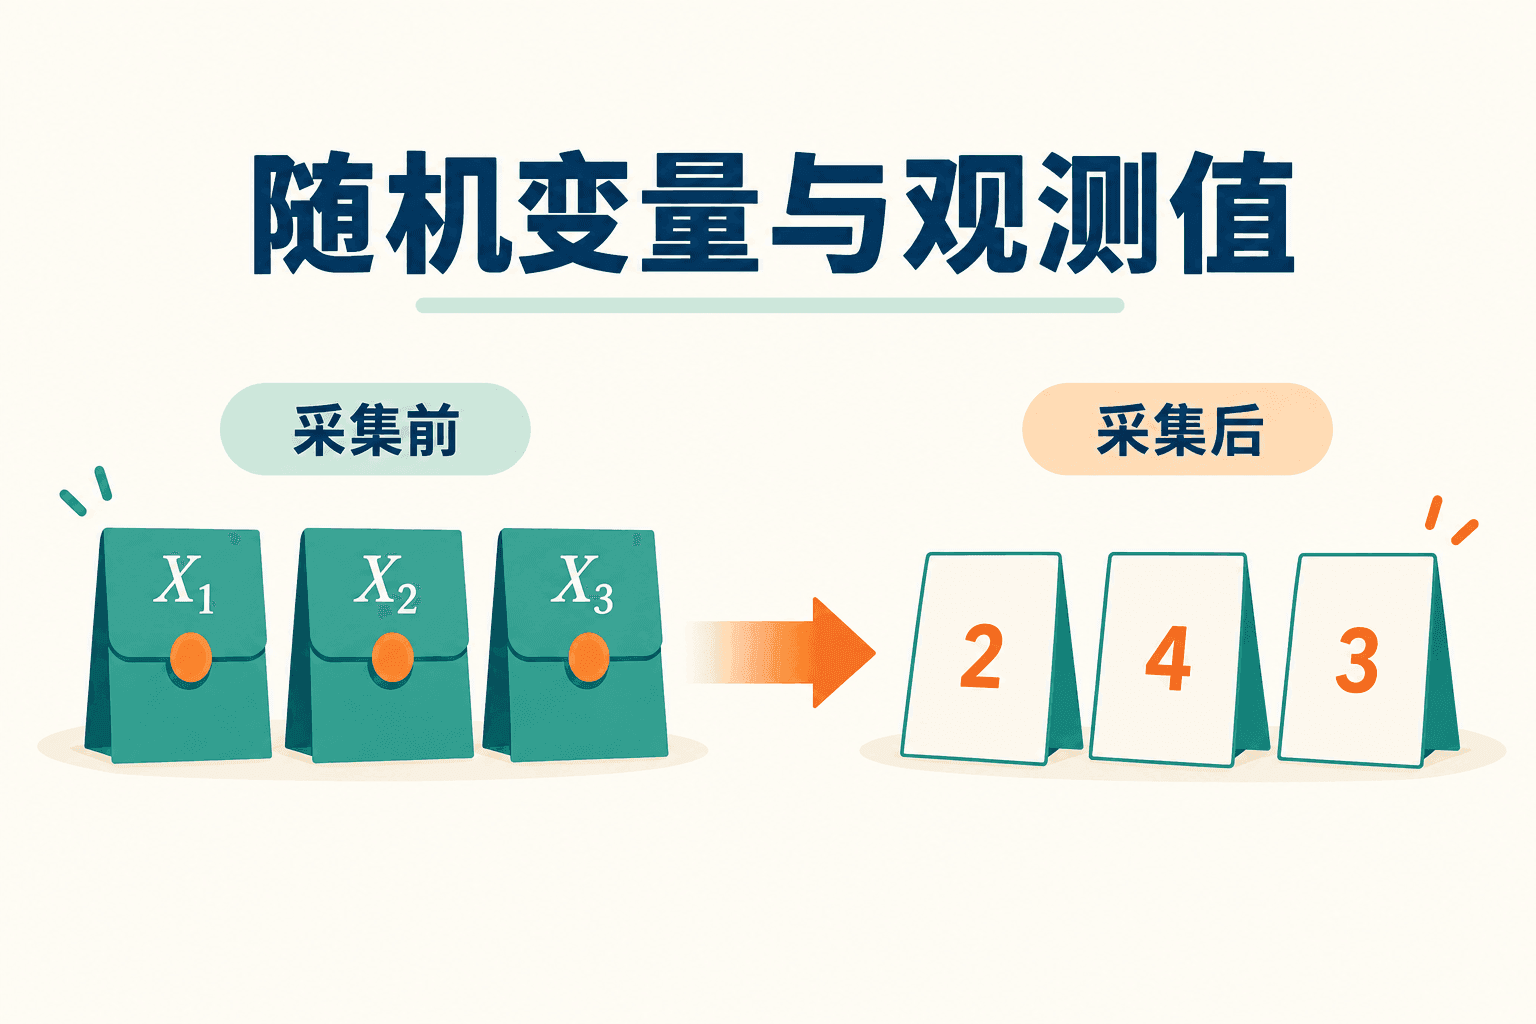
大小写用来区分采集前后。第 iii 次结果尚未出现时,用随机变量 XiX_iXi​ 描述;实际记录下来的是小写的 xix_ixi​。例如拿到三个观测 2,4,32,4,32,4,3,就可以写出 x1=2,x2=4,x3=3x_1=2,x_2=4,x_3=3x1​=2,x2​=4,x3​=3。随机变量包含可能的结果及其概率规律,这一次的观测值只是其中一次实现。

随机变量与观测值
图 1-2:随机变量与观测值

因此 Xˉ=(X1+⋯+Xn)/n\bar X=(X_1+\cdots+X_n)/nXˉ=(X1​+⋯+Xn​)/n 是随机变量,xˉ=(x1+⋯+xn)/n\bar x=(x_1+\cdots+x_n)/nxˉ=(x1​+⋯+xn​)/n 是已经算出的数。同样,p^=∑Xi/n\hat p=\sum X_i/np^​=∑Xi​/n 在采集前会变化;某次得到 0.60.60.6 并不意味着估计规则没有随机性。

参数描述总体模型。伯努利分布的参数 ppp 是成功概率;正态分布则可以用均值 μ\muμ 和方差 σ2\sigma^2σ2 来确定。这门课主要使用频率学派框架,参数固定但未知,随机变化来自样本。因此,“估计量的期望”是在同一个参数下,对不同可能样本给出的估计结果取平均。

一次恰好估得准,还不足以判断方法可靠。真实问题中的真值通常未知,眼前这次误差甚至无法直接核对。评价估计规则,需要考察它在重复抽样中的表现。

3. 模型规定了推理的范围

统计模型可以写成一族分布

P={Pθ:θ∈Θ}.\mathcal P=\{P_\theta:\theta\in\Theta\}.P={Pθ​:θ∈Θ}.

Θ\ThetaΘ 是参数空间,列出允许的参数;PθP_\thetaPθ​ 则规定每个参数下可能观察到哪些结果,以及它们的概率。写出这族分布后,你就得按这些规定推理,不能只凭“数据看起来差不多”来选公式。

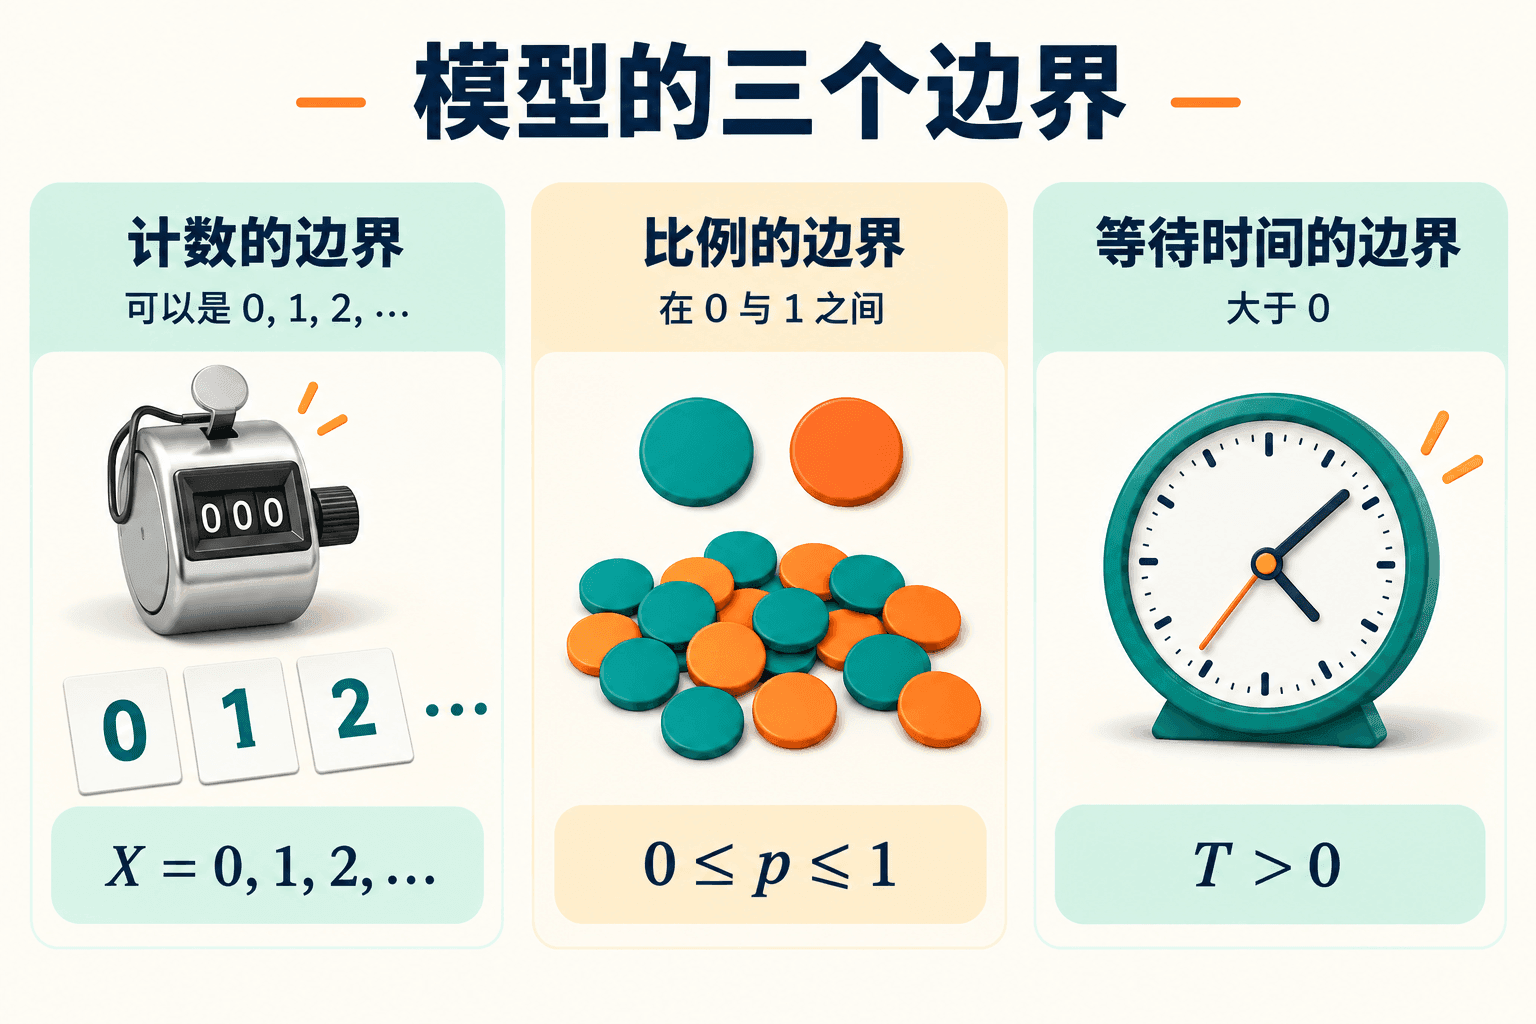
例如 Xi∼Bernoulli⁡(p)X_i\sim\operatorname{Bernoulli}(p)Xi​∼Bernoulli(p) 表示 XiX_iXi​ 只能取 0 或 1,且 Pp(Xi=1)=pP_p(X_i=1)=pPp​(Xi​=1)=p。若把 p=0p=0p=0 与 p=1p=1p=1 也纳入,则 Θ=[0,1]\Theta=[0,1]Θ=[0,1]。它们分别表示必然失败与必然成功。需要求对数和导数的正则论证,常把参数限制到内部 0<p<10<p<10<p<1;必须明确什么时候改变了讨论范围。

模型的三个边界
图 1-3:模型的三个边界

这里容易把两个集合混在一起:观测值可以取什么,参数又可以取什么。前者是“观测变量的支持”,后者是“参数空间”。拿泊松模型来说,计数 XXX 只能取非负整数,平均计数参数 λ\lambdaλ 却可以取正实数。概率、计数和等待时间各有自己的取值限制,写模型时要分别交代。

模型还要能够识别参数:不同参数不能产生完全相同的观测分布。如果记录仪只保存一个测量值的平方,某些模型里的正负方向信息就可能丢失。即使观测无限多,也不能从没有被记录的信息中恢复方向。增加样本量不能修复不可识别的设计。

不可识别需要证明“整个观测分布相同”

设真实信号 Z∼N(θ,1)Z\sim N(\theta,1)Z∼N(θ,1),但仪器只记录 X=Z2X=Z^2X=Z2,参数允许正负。因为 −Z∼N(−θ,1)-Z\sim N(-\theta,1)−Z∼N(−θ,1),而 (−Z)2=Z2(-Z)^2=Z^2(−Z)2=Z2,所以参数 θ\thetaθ 与 −θ-\theta−θ 给出完全相同的 XXX 分布。无论重复多少次平方记录,两种方向仍无法区分。这比“本次数据碰巧相同”更强:所有可能记录的概率规律都相同。

数据仍能识别 θ2\theta^2θ2,例如 E(X)=1+θ2E(X)=1+\theta^2E(X)=1+θ2 就含有这个量。如果领域知识事先限定 θ≥0\theta\ge0θ≥0,方向的问题也消失了。这里的“事先”很关键:分析完才任意选正号,不能把方向归功于数据。完整参数不可识别时,它的某个函数仍可能由观测分布确定。

从平台的目标写出模型

假设团队关心的是“目标用户第一次使用新界面时,无协助完成任务的比例”。这句话里的对象和限制,都要落实到采集规则中。

总体限定为目标范围内尚未使用过该界面的用户。成功指在事先约定的时限内、没有人工提示地完成指定任务。中途改了时限或任务,参数表示的就已经是另一个成功概率了。

给每名入选用户定义一个变量:成功时取 1,否则取 0。取值只有两种,因此伯努利模型是自然候选。参数 ppp 表示该抽样机制覆盖的用户首次成功概率,而不是这一次样本里成功人数占比。

说明如何获得联合分布。如果抽样近似独立、实验条件一致,才进一步写成 X1,…,Xn∼iidBernoulli⁡(p)X_1,\ldots,X_n\overset{\mathrm{iid}}{\sim}\operatorname{Bernoulli}(p)X1​,…,Xn​∼iidBernoulli(p)。由独立性,观察到特定序列的概率为 p∑xi(1−p)n−∑xip^{\sum x_i}(1-p)^{n-\sum x_i}p∑xi​(1−p)n−∑xi​;这个乘积不是单靠“每项是伯努利”就能得到的。

成功比例可以作为估计,但收集人数、未完成和缺失记录的处理规则需要事先确定。失败用户若更容易退出,而退出者又被删掉,留下的比例就可能系统偏高。缺失原因没有查清,直接把剩余人数代入独立样本公式并不能解决偏差。

如果系统进一步简化记录,只保存“有人成功过”,连尝试人数也丢掉了。1 位用户全部成功,与 100 位中只有 1 位成功,都会留下这句话。两种情况已无法从记录中分辨,更复杂的估计公式也找不回丢掉的人数。

观察机制也是模型的一部分

设目标成功概率为 ppp,成功者的记录保留概率是 r1r_1r1​,失败者为 r0r_0r0​。以 R=1R=1R=1 表示记录被留下,条件概率公式给

P(X=1∣R=1)=pr1pr1+(1−p)r0.P(X=1\mid R=1)=\frac{pr_1}{pr_1+(1-p)r_0}.P(X=1∣R=1)=pr1​+(1−p)r0​pr1​​.

代入 p=0.6,r1=1,r0=0.5p=0.6,r_1=1,r_0=0.5p=0.6,r1​=1,r0​=0.5,留下的记录成功率是 0.6/(0.6+0.2)=0.750.6/(0.6+0.2)=0.750.6/(0.6+0.2)=0.75。样本继续增加,比例会更稳地停在 0.75 附近,离目标 0.6 的差异却还在。若不知道保留概率,仅凭这个比例通常分不开 p,r1,r0p,r_1,r_0p,r1​,r0​。完整记录或有关选择过程的信息,才可能帮助区分这些参数。

目标人群构成也会改变参数。假设目标用户中熟练者占 30%、新手占 70%,两类成功率分别为 0.9、0.5,目标总体成功率为 0.3⋅0.9+0.7⋅0.5=0.620.3\cdot0.9+0.7\cdot0.5=0.620.3⋅0.9+0.7⋅0.5=0.62。若样本却各招一半,直接合并的平均目标变成 0.70。分层估计 0.3p^熟+0.7p^新0.3\hat p_{\mathrm{熟}}+0.7\hat p_{\mathrm{新}}0.3p^​熟​+0.7p^​新​ 在各层随机采集、权重已知时可恢复目标;它的方差在两层独立时为 0.32p熟(1−p熟)/n熟+0.72p新(1−p新)/n新0.3^2p_{\mathrm{熟}}(1-p_{\mathrm{熟}})/n_{\mathrm{熟}}+0.7^2p_{\mathrm{新}}(1-p_{\mathrm{新}})/n_{\mathrm{新}}0.32p熟​(1−p熟​)/n熟​+0.72p新​(1−p新​)/n新​。不能把这个加权规则的精度继续当作一个简单同分布比例来算。

4. 独立与同分布的不同约束

本课程的基础情形是随机样本

X1,…,Xn∼iidPθ,X_1,\ldots,X_n\overset{\mathrm{iid}}\sim P_\theta,X1​,…,Xn​∼iidPθ​,

iid 表示独立且同分布。同分布要求每个观测遵循同一概率规律;独立性还涉及它们的联合分布,要求知道其他观测后,某个观测的条件概率规律不变。仅满足其中一项,不能使用依赖两者的结论。

来自不同噪声水平的仪器读数可能独立但不同分布。重复测量同一台设备的相邻时刻读数,可能边缘分布相同却相互相关。共享温度、同一用户的习惯、一次故障造成的连续异常,都可能产生相关性。
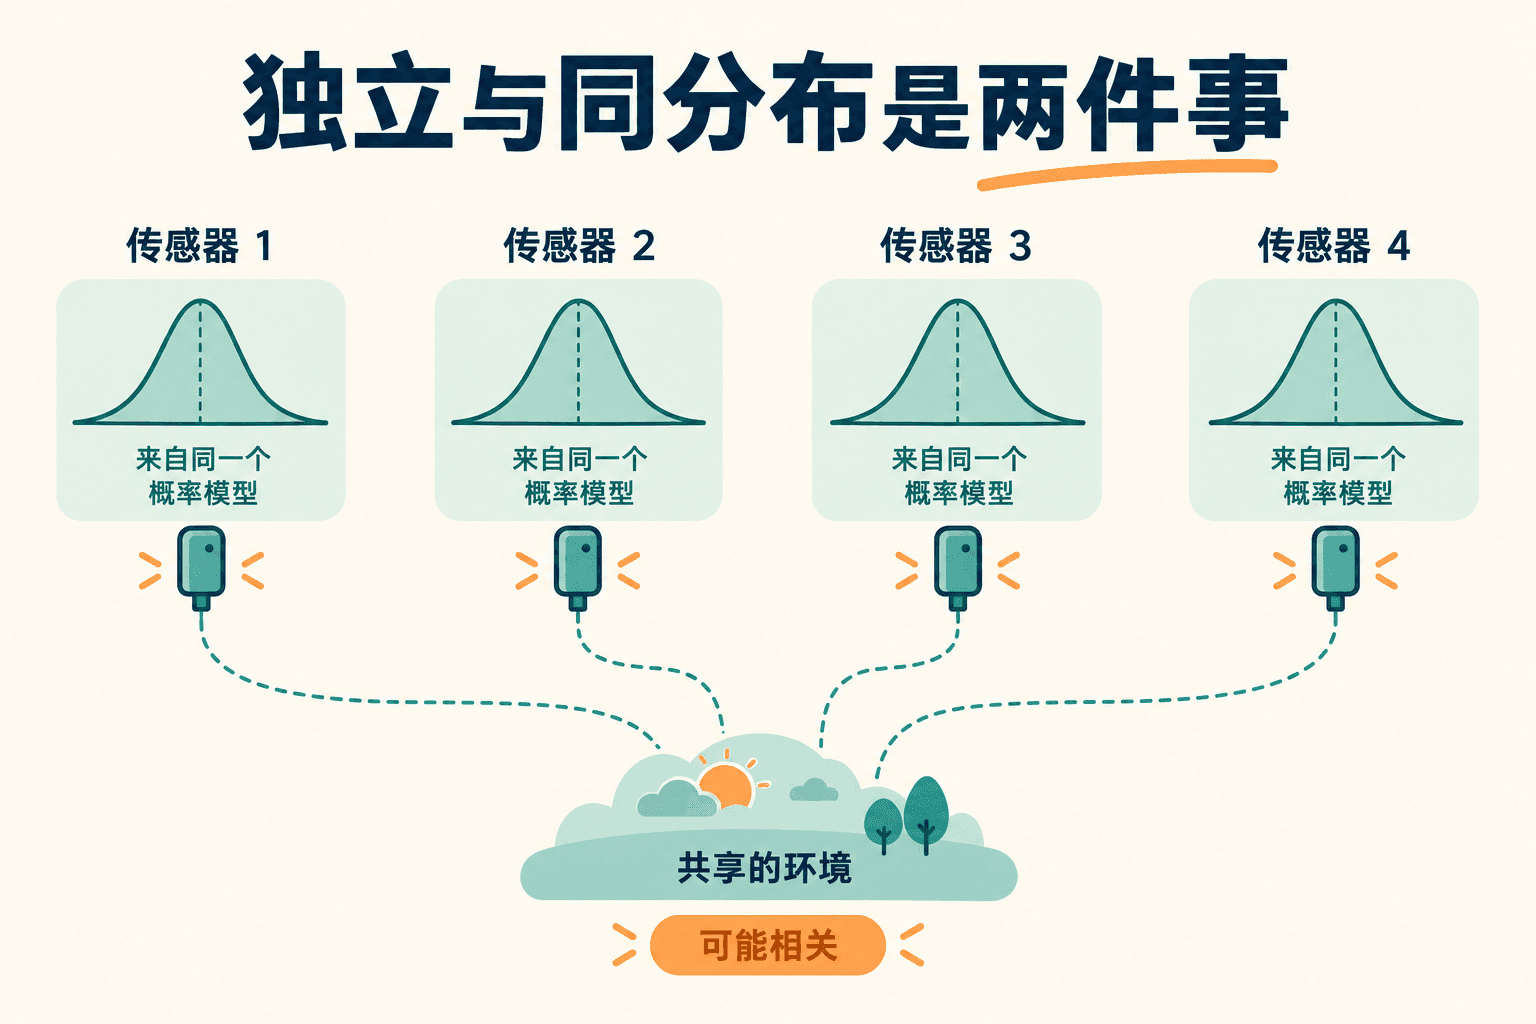
独立与同分布是两件事
图 1-4:独立与同分布是两件事

设每个观测的均值为 μ\muμ、方差为 σ2\sigma^2σ2,则不论是否独立,E(Xˉ)=μE(\bar X)=\muE(Xˉ)=μ;但方差为

Var⁡(Xˉ)=1n2[∑i=1nVar⁡(Xi)+2∑i<jCov⁡(Xi,Xj)].\operatorname{Var}(\bar X)=\frac{1}{n^2} \left[\sum_{i=1}^n\operatorname{Var}(X_i) +2\sum_{i<j}\operatorname{Cov}(X_i,X_j)\right].Var(Xˉ)=n21​[i=1∑n​Var(Xi​)+2i<j∑​Cov(Xi​,Xj​)].

独立时协方差项全为零,才得到 Var⁡(Xˉ)=σ2/n\operatorname{Var}(\bar X)=\sigma^2/nVar(Xˉ)=σ2/n。假设每两个观测的相关系数都为 ρ\rhoρ,则

Var⁡(Xˉ)=σ2n[1+(n−1)ρ].\operatorname{Var}(\bar X)=\frac{\sigma^2}{n}[1+(n-1)\rho].Var(Xˉ)=nσ2​[1+(n−1)ρ].

例如 n=20,ρ=0.1n=20,\rho=0.1n=20,ρ=0.1,真实方差是独立公式的 2.92.92.9 倍。按独立样本计算会把标准误算小。此时需要调整抽样设计,或采用处理相关性的方法;在报告末尾加一句“可能相关”,并没有修正计算。

不放回抽样带来的负相关

一个固定总体有 NNN 个对象,其中 KKK 个成功,目标比例 p=K/Np=K/Np=K/N。等概率不放回抽 nnn 个,令每次抽中的成功指示为 XiX_iXi​。每个 XiX_iXi​ 都有成功概率 ppp,但抽到一个成功后,剩余成功比例变为 (K−1)/(N−1)(K-1)/(N-1)(K−1)/(N−1)。

对 i≠ji\ne ji=j,E(XiXj)=K(K−1)/[N(N−1)]E(X_iX_j)=K(K-1)/[N(N-1)]E(Xi​Xj​)=K(K−1)/[N(N−1)],减去 p2p^2p2 得

Cov⁡(Xi,Xj)=−p(1−p)N−1.\operatorname{Cov}(X_i,X_j)=-\frac{p(1-p)}{N-1}.Cov(Xi​,Xj​)=−N−1p(1−p)​.

代入协方差求和公式便有

Var⁡(p^)=p(1−p)nN−nN−1.\operatorname{Var}(\hat p)=\frac{p(1-p)}n\frac{N-n}{N-1}.Var(p^​)=np(1−p)​N−1N−n​.

例如 N=200,n=50,p=0.4N=200,n=50,p=0.4N=200,n=50,p=0.4,方差为 0.0048⋅150/199≈0.0036180.0048\cdot150/199\approx0.0036180.0048⋅150/199≈0.003618,标准差约 0.0602;独立模型会给 0.0693。抽查全体即 n=Nn=Nn=N 时方差为零,因为固定总体的比例已被完整计数。这是抽样设计的结果,与共同扰动造成的正相关恰好方向相反。

成功总数这时服从超几何分布,质量为 (Ks)(N−Kn−s)/(Nn)\binom Ks\binom{N-K}{n-s}/\binom Nn(sK​)(n−sN−K​)/(nN​)。只有当抽样比例足够小、精度要求允许时,才可考虑二项近似。总体有限并不妨碍每次边缘为伯努利,真正改变的是联合分布。

平均后仍然留下的共同噪声

同一环境下第 iii 个读数可以拆成共同部分和各自的扰动:

Xi=μ+A+εi,X_i=\mu+A+\varepsilon_i,Xi​=μ+A+εi​,

其中共同扰动 AAA 与各自扰动 εi\varepsilon_iεi​ 相互独立、均值为零,方差分别为 τ2\tau^2τ2 和 ω2\omega^2ω2。于是 Xˉ=μ+A+εˉ\bar X=\mu+A+\bar\varepsilonXˉ=μ+A+εˉ:取平均缩小的是各自扰动,共同扰动原封不动地留下。

Var⁡(Xˉ)=τ2+ω2n.\operatorname{Var}(\bar X)=\tau^2+\frac{\omega^2}{n}.Var(Xˉ)=τ2+nω2​.

若总方差 σ2=τ2+ω2\sigma^2=\tau^2+\omega^2σ2=τ2+ω2、相关系数 ρ=τ2/σ2\rho=\tau^2/\sigma^2ρ=τ2/σ2,就重新得到前面的相关样本公式。即使 nnn 很大,方差也仍有 τ2\tau^2τ2 这个下限。解决办法可能是增加独立批次、独立环境或独立用户,而不是在同一个环境里无限重复。

令独立观测的均值方差 σ2/neff\sigma^2/n_{\mathrm{eff}}σ2/neff​ 等于这些相关读数的均值方差,便能比较两者的精度,得到

neff=n1+(n−1)ρ.n_{\mathrm{eff}}=\frac{n}{1+(n-1)\rho}.neff​=1+(n−1)ρn​.

n=20,ρ=0.1n=20,\rho=0.1n=20,ρ=0.1 时约相当于 6.906.906.90 个独立观测的均值精度。这里的“有效样本量”只是在这个等相关模型下比较均值方差,不能直接当成所有检验的自由度。

实验:同一批读数的共同偏移

rho=0.1 时,均值方差里有一部分来自共同噪声。结合上式,估计一下记录数不断增加时曲线会靠近什么值。

将滑块设在 n=20、rho=0.1,增加记录数,观察虚实两条曲线的间距。独立情形提供了一个参照。重抽噪声时,那些共享方块会落在同一横坐标上,可以对照它们与各自噪声增量的位置。

同一批里的共享方块位置相同,只有各自的独立噪声增量不同。rho>0 时,均值方差逐渐靠近 sigma²rho,n_eff 的增长也越来越慢。

把这个现象写回模型就是 Xᵢ=mu+sigma√rho Z₀+sigma√(1−rho)Zᵢ。于是 Var(X̄)=sigma²rho+sigma²(1−rho)/n:独立项会被平均掉,共享项还在。这里的 n_eff 只比较当前模型下的均值精度。

5. 统计量:计算规则不能偷偷借用答案

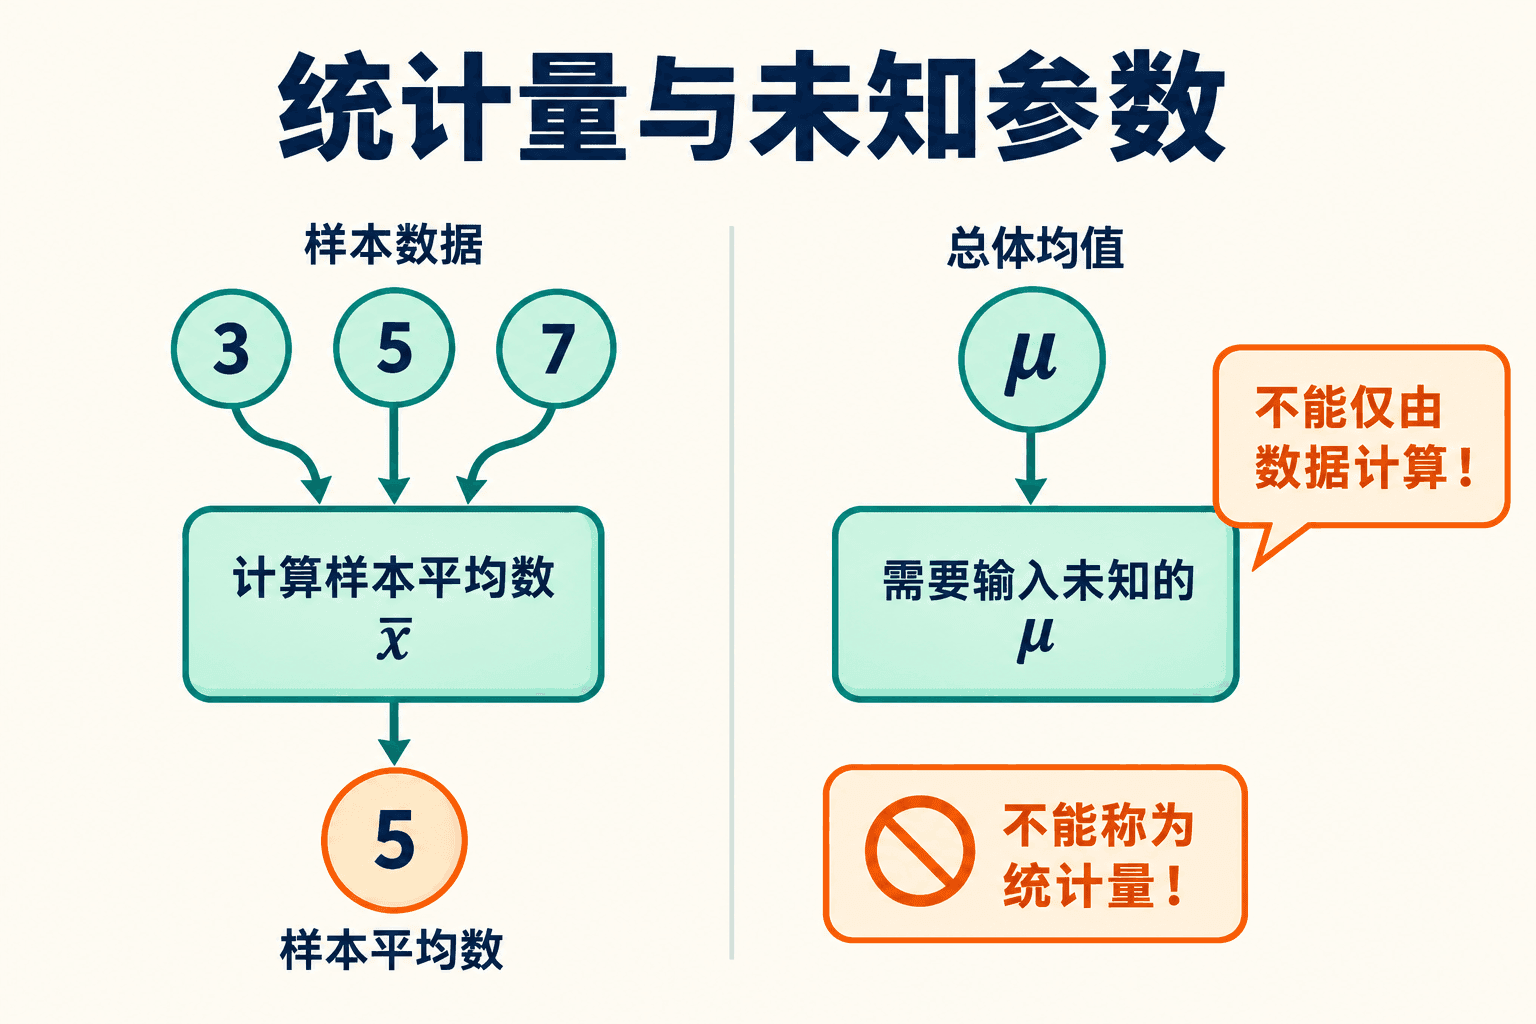
统计量是只依赖样本和已知量的可测函数 T(X1,…,Xn)T(X_1,\ldots,X_n)T(X1​,…,Xn​)。样本平均、样本最大值、成功次数都是统计量。若总体均值 μ\muμ 未知,∑(Xi−μ)2\sum(X_i-\mu)^2∑(Xi​−μ)2 就不是统计量,因为仅靠记录无法算出它。

统计量与未知参数
图 1-5:统计量与未知参数

统计量可以有偏,也可以保留多个分量。完整样本本身就是一个向量统计量,甚至没有压缩数据。选择哪种计算规则,取决于要回答的问题以及其中用得上的样本信息。

例:从计数推到比例。 在独立伯努利模型中,S=∑Xi∼Bin⁡(n,p)S=\sum X_i\sim\operatorname{Bin}(n,p)S=∑Xi​∼Bin(n,p),于是

E(p^)=E(S/n)=p,Var⁡(p^)=p(1−p)n.E(\hat p)=E(S/n)=p,\qquad \operatorname{Var}(\hat p)=\frac{p(1-p)}n.E(p^​)=E(S/n)=p,Var(p^​)=np(1−p)​.

第一式说长期平均不偏离 ppp;第二式说每次结果仍有波动。n=10,p=0.6n=10,p=0.6n=10,p=0.6 时,方差为 0.0240.0240.024、标准差约 0.15490.15490.1549。将样本量增为 404040,标准差减半,而不是变为原来的四分之一。

实验:把同一次抽样重做许多遍

固定 p=0.6,考虑每批人数由 10 增至 40 的情形。方差公式已经给出了标准差的变化比例,模拟可以把这种收窄显示出来。还有一个容易误读的地方:只抽一批时,经验方差会显示为 0,但这不足以说明估计量没有随机性。

初始化的一批逐人记录可以和理论柱图直接对照。“重做 1000 批”会留下更多抽样结果,n=10 / n=40 按钮用于比较每批人数的影响。p=0 和 p=1 则适合检查分布的端点。

一批记录只在一个比例位置增加频率,重复 1000 批后,空心柱才逐渐接近理论实心柱。n 越大,分布越集中;到了 p 的两个端点,结果只剩一种可能,分布也就退化了。

这和 Var(p̂)=p(1−p)/n 对得上:标准差按 √n 的倒数变化。别把批数和每批人数混在一起——多重做几批会改善模拟近似,却不会改变单批的抽样规则。

固定样本量与见到成功就停,不是同一个实验

计划甲事先规定做 4 次,记录成功总数 SSS;计划乙一直做到首次成功,记录等待次数 NNN。即使甲恰好出现“失败、失败、失败、成功”,两个计划都得到同一串四次记录,也不能把抽样分布视为相同。

甲的样本空间是所有长度为 4 的二元序列,总数 S∼Bin⁡(4,p)S\sim\operatorname{Bin}(4,p)S∼Bin(4,p)。乙的样本空间是长度可变、最后一项是首次成功的序列,Pp(N=k)=(1−p)k−1pP_p(N=k)=(1-p)^{k-1}pPp​(N=k)=(1−p)k−1p、k=1,2,…k=1,2,\ldotsk=1,2,…。在乙中,成功数恒为 1、样本量随机;在甲中恰好相反,样本量固定、成功数随机。

对这条具体序列,两种设计的似然都与 p(1−p)3p(1-p)^3p(1−p)3 成比例,因此第 5 章的最大似然会给相同的 1/41/41/4。但按重复实验定义的概率、偏差与错误率,需要在各自样本空间里计算。不能因本次似然相同就自动搬用固定样本量的所有保证。第 10 章还会看到,反复查看结果直到显著才停止,需要为整套查看规则控制错误率。

6. 计算后的模型检查
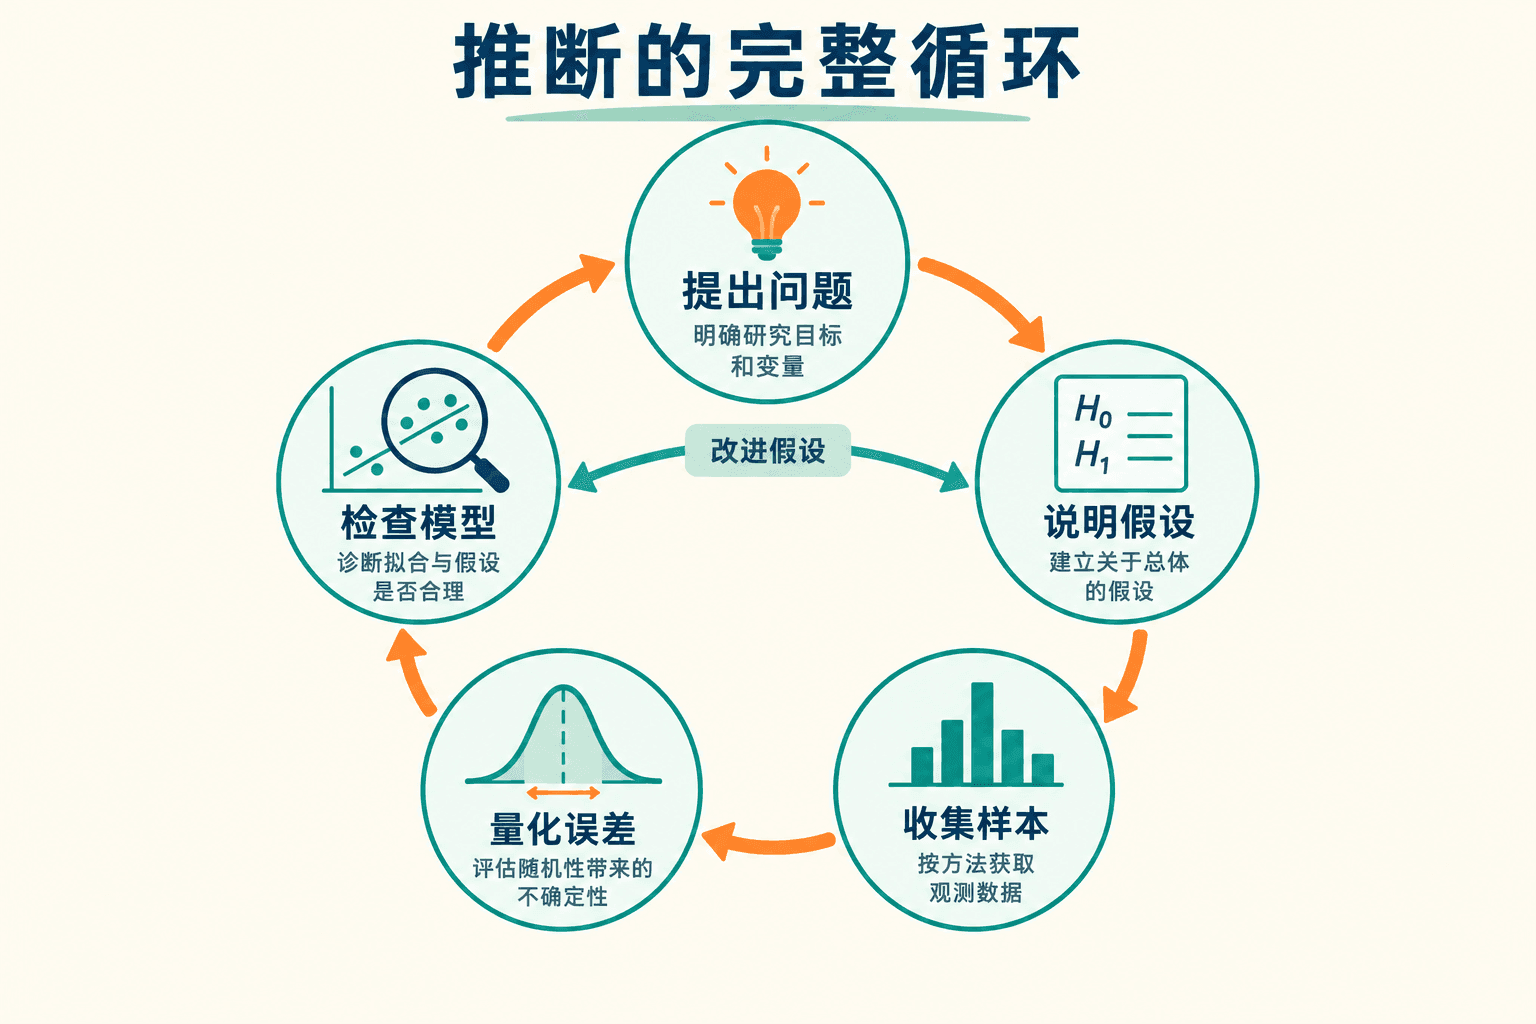
推断的完整循环
图 1-6:推断的完整循环

估计规则应对应明确的目标人群、观测单位和记录方式。算出结果后,还要检查异常、相关性以及观测是否落在模型支持内。数据结构与模型不符时,可能需要调整模型或缩小结论范围。不过,用同一批数据反复改模型、挑结论,会改变错误率;第 10 章会处理这个问题。

本课程的通用约定是:nnn 为样本量,θ\thetaθ 为一般参数,θ^\hat\thetaθ^ 为估计量,Xˉ\bar XXˉ 为样本均值,S2S^2S2 为分母 n−1n-1n−1 的样本方差,ℓ\ellℓ 为对数似然。若使用伽马分布,会明确采用形状与尺度还是形状与速率,避免同一个字母代表相反量。

采集方式的判断

1
100 行数据来自同一用户的连续尝试。哪一步应先于套用独立样本公式?
2
得到成功比例 0.6 后,估计量在重复抽样中就不再随机。
3
独立抽样下,要把样本均值的标准差减半,样本量应变成原来的多少倍?填写数字。

7. 练习:记录与可回答的目标

练习 1|识别真正可回答的目标。 仪器记录 X=Z2X=Z^2X=Z2,Z∼N(θ,4)Z\sim N(\theta,4)Z∼N(θ,4)、θ∈R\theta\in\mathbb Rθ∈R。证明符号不可识别,并给出一个能由 E(X)E(X)E(X) 识别的参数函数。

将 ZZZ 换为 −Z-Z−Z 把参数变成 −θ-\theta−θ 而平方保持不变,因此两参数的完整观测分布相同。E(X)=Var⁡(Z)+(EZ)2=4+θ2E(X)=\operatorname{Var}(Z)+(EZ)^2=4+\theta^2E(X)=Var(Z)+(EZ)2=4+θ2,所以 θ2\theta^2θ2 可由这一矩识别。识别幅度不等于识别方向。

练习 2|丢失记录会把目标推到哪里。 真实成功概率为 0.4,成功与失败记录的保留概率分别为 0.9、0.3。求留下记录中的成功概率;若只增加记录数量,能否修复差异?

保留且成功的概率为 0.36,另有 0.18 的概率保留了一条失败记录。以两者之和作为条件概率的分母,得到 0.36/0.54=2/30.36/0.54=2/30.36/0.54=2/3。增加记录只会减少围绕这个比例的波动,不能把它变回 0.4;还得处理记录的选择过程,或取得完整记录。

练习 3|不放回也能无偏。 固定总体有 100 个对象、30 个成功,随机不放回抽 20 个。求样本成功比例的期望与方差;解释独立性并不是无偏性的必要条件。

每次成功指示的期望都是 0.3,所以用期望的线性性质,比例的期望就是 0.3。这一步没有用独立性。方差则为 0.3⋅0.7/20⋅80/99≈0.0084850.3\cdot0.7/20\cdot80/99\approx0.0084850.3⋅0.7/20⋅80/99≈0.008485。你可以看到,协方差项改变了精度,却没有改变这些边缘期望的平均。

练习 4|多批次怎样平均共同扰动。 有 BBB 个独立环境,每个环境测 mmm 次,模型 Xbi=μ+Ab+εbiX_{bi}=\mu+A_b+\varepsilon_{bi}Xbi​=μ+Ab​+εbi​,环境方差 2、个体方差 6,所有不同来源独立。推导全部记录均值的方差,并比较总计 60 次时 (B,m)=(3,20)(B,m)=(3,20)(B,m)=(3,20) 与 (20,3)(20,3)(20,3)。

总平均为 μ+B−1∑bAb+(Bm)−1∑b,iεbi\mu+B^{-1}\sum_bA_b+(Bm)^{-1}\sum_{b,i}\varepsilon_{bi}μ+B−1∑b​Ab​+(Bm)−1∑b,i​εbi​,方差为 2/B+6/(Bm)2/B+6/(Bm)2/B+6/(Bm)。前一方案为 2/3+0.1≈0.76672/3+0.1\approx0.76672/3+0.1≈0.7667,后一方案为 0.1+0.1=0.20.1+0.1=0.20.1+0.1=0.2。固定记录总数时,多一些独立环境能降低尚未被平均掉的共同误差,前提是各环境仍针对同一目标均值。

练习 5|目标权重与招募权重。 目标群体中甲类占 80%、乙类占 20%,两类各采 50 人,成功数为 30、45。求直接合并比例与按目标构成加权的比例,并写出后者在层内 iid、两层独立时的方差公式。

直接比例为 75/100=0.75,加权为 0.8⋅0.6+0.2⋅0.9=0.660.8\cdot0.6+0.2\cdot0.9=0.660.8⋅0.6+0.2⋅0.9=0.66。方差为 0.82pA(1−pA)/50+0.22pB(1−pB)/500.8^2p_A(1-p_A)/50+0.2^2p_B(1-p_B)/500.82pA​(1−pA​)/50+0.22pB​(1−pB​)/50。直接比例对应各占一半的构成,加权比例对应题目目标;两者估计的组合不同。

练习 6|统计量与理论工具。 均值 μ\muμ 未知、标准差已知为 2。判断 Xˉ\bar XXˉ、n(Xˉ−μ)/2\sqrt n(\bar X-\mu)/2n​(Xˉ−μ)/2、∑(Xi−Xˉ)2\sum(X_i-\bar X)^2∑(Xi​−Xˉ)2 是否是统计量。不是统计量的式子为何仍可能有用?

第一个和第三个只用数据与已知量,能直接算出来,属于统计量。第二个含有未知均值,无法给出数值。不过,它的分布仍有推导价值:若分布不依赖参数,就能通过不等式反解未知参数,构造置信区间。

练习 7|停止规则改变了什么。 一个计划固定做 5 次,另一个直到首次成功为止。两次都记录到四次失败后一次成功。写出两种计划的随机变量与样本空间,并解释为什么本次都报 0.2 不证明其重复抽样风险相同。

前者固定 n=5n=5n=5,随机成功数为二项,序列空间大小 252^525;后者成功数恒为 1,随机等待次数取任意正整数、服从几何分布。前者比例为 S/5S/5S/5,后者为 1/N1/N1/N,两条规则的分布不同。相同的一次取值不决定风险函数。

练习 8|写一份可复核的模型说明。 要估计新用户第一次无协助完成任务的概率。招募方案允许同一人重复参加,而且系统只保存完成记录。请分别修改观测单位、纳入规则、成功标准和记录字段,使目标能够由采集数据回答。

观测单位应是目标范围内的新用户,每人只取事先定义的第一次尝试,招募方式也要能覆盖目标群体。任务、时间窗和无协助标准在采集前固定。全部入选者的标识需要保留,是否尝试、是否成功以及退出或缺失的原因也不能遗漏。重复尝试可以另存,不能混进首次尝试的分母。有关用户间独立性的依据和结论适用范围,应在模型说明中写明,便于别人核对参数、联合模型和分母的含义。

下一章抽样分布:正态、卡方、t 与 F