样本的平均和波动可以组成矩方程,用来反解模型参数。得到解只是构造的起点,它的偏差、合法范围和一致性还需要检验。
1. 平均之外的分布特征
两批等待时间平均都是 4 秒:一批大多在 4 附近,另一批多数很短,偶尔却等很久。仅匹配平均,会遗漏这种差别。矩估计用模型特征与样本中的同类特征建立方程,反解其中的参数。候选参数是否能合理解释全部记录,还需要另外检查。
矩估计把这个想法推广:选择若干总体矩,用相应的样本矩替代,再解出参数。r 阶原点矩是 mr(θ)=Eθ(Xr);样本原点矩是
m^r=n1i=1∑nXir.
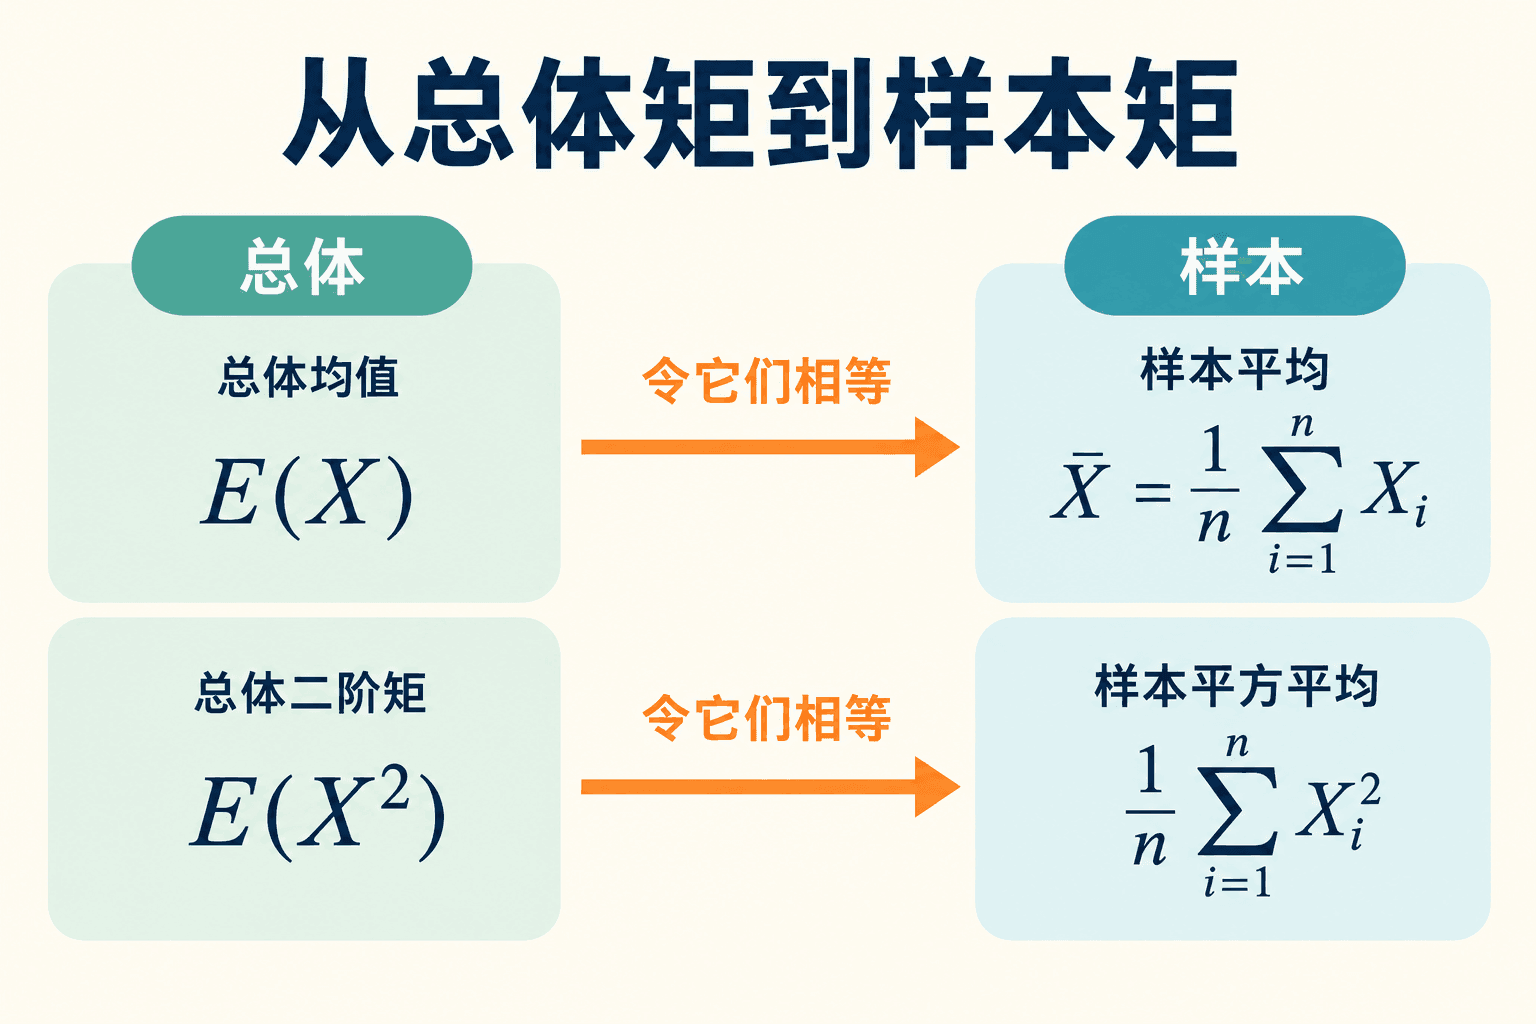 图 4-1:从总体矩到样本矩
均值和方差只是分布的部分特征。两个分布可以有相同的均值和方差,形状却不同。所以矩估计是在已选定的模型族里找参数;匹配成功以后,还不能反过来说总体一定属于这个模型。
一个参数常用一道矩方程,但方程数与未知数相等,并不保证唯一合法的解。如果模型均值只依赖 θ2,正负 θ 就无法分开。能识别方向的其他特征,或问题本身合理的参数限制,可能解决这类歧义。
经验分布中的矩与分母 n
把这批记录暂时当成一个分布:每个观测各占 1/n 的概率,这就是经验分布。按这个分布抽一个记录值,平均是 xˉ,平方的平均是 m^2。矩估计做的事情由此很具体:让模型特征等于经验分布的相应特征。
矩匹配没有要求无偏。上一章定义的 n−1 不能成为把所有分母改成 n−1 的理由。规则应按矩方程确定,随后评价偏差、方差和 MSE;有理由修正时,需要明确指出修改了什么。
方程的方向也不能颠倒。指数速率对应的均值为 1/λ,均匀上界对应的均值为 θ/2。用样本均值替代模型均值后,不同的反解关系会给出不同参数估计,即使输入的是同一批数据。
2. 一参数例:平均时间与速率不要混用
本课程把指数分布的速率参数记为 λ>0:
fλ(x)=λe−λx,x≥0,E(X)=λ1.
令 1/λ^=Xˉ,得到
λ^MM=Xˉ1.
如果改用平均时间 μ=1/λ 参数化,则 μ^MM=Xˉ。同一个模型可以换参数,但单位必须同步变化:μ 的单位是秒,λ 的单位是每秒。
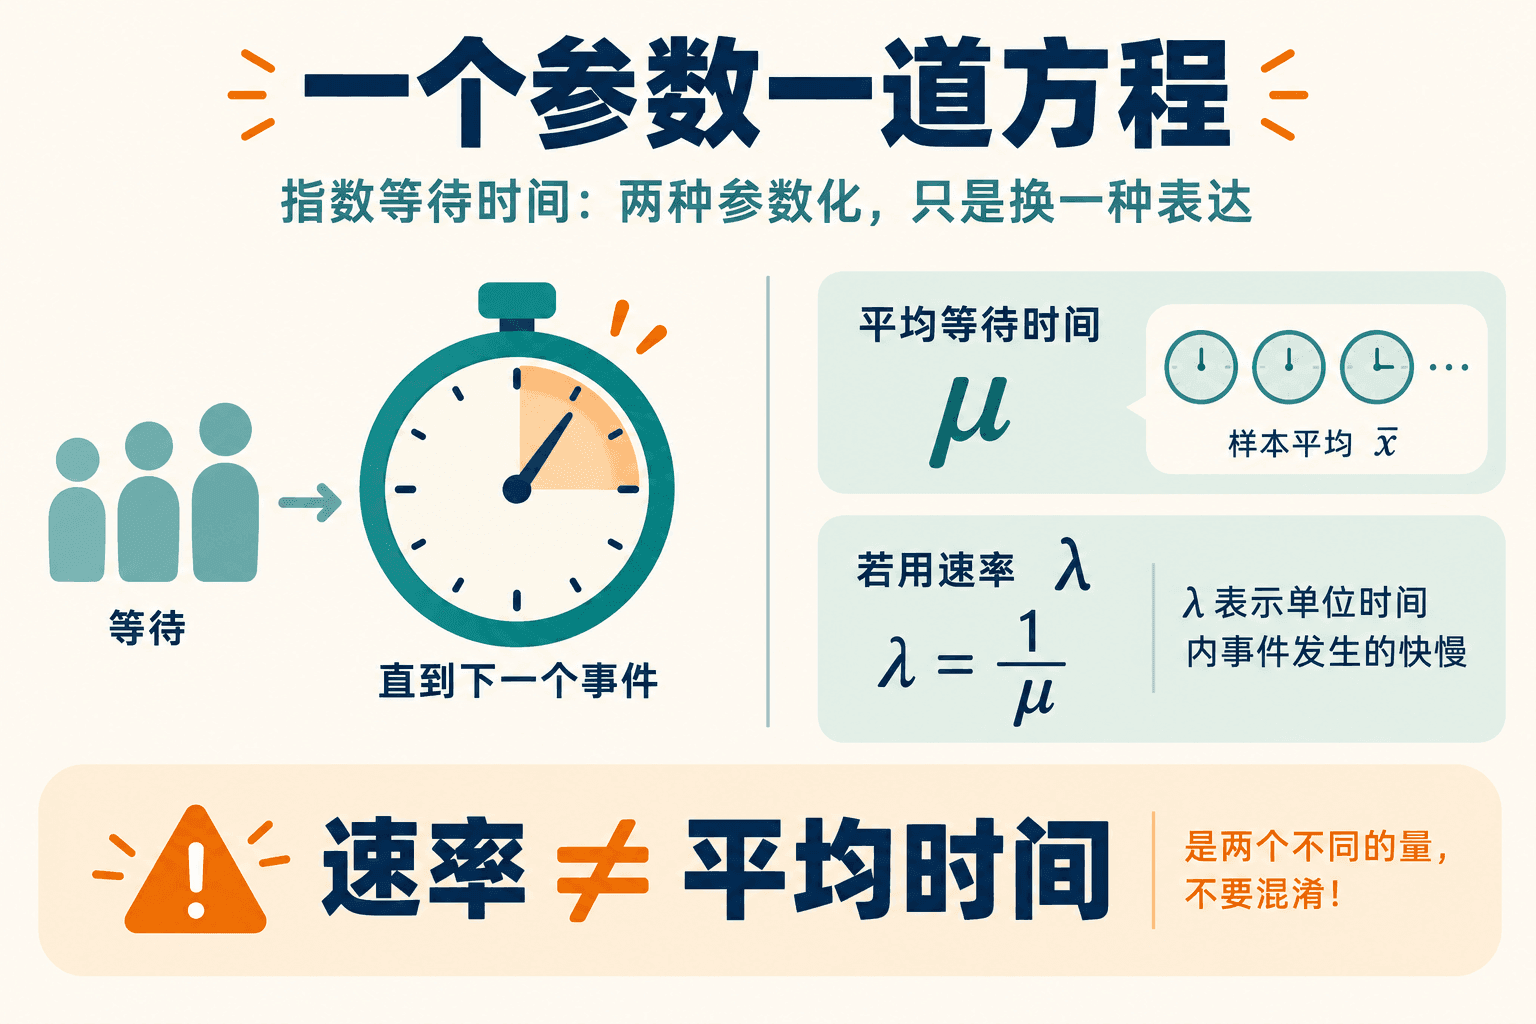 图 4-2:一个参数一道方程
例如四次等待时间为 2,3,5,6 秒,平均是 xˉ=4 秒。速率估计应为 0.25 每秒,不能写成 4 每秒。你可以用单位核对,看看这一步是否该取倒数。
平均时间估得无偏,速率估计却通常有偏。非线性函数 1/x 不与取期望交换,E(1/Xˉ) 一般不等于 1/E(Xˉ)。指数模型在 n>1 时满足 E(1/Xˉ)=nλ/(n−1),说明速率矩估计偏高。这个偏差可以从下面的积分直接求出。
把有限样本偏差从积分中算出来
独立指数变量的总和 T=nXˉ 具有密度 λntn−1e−λt/Γ(n)。要评价 n/T,需要倒数矩。对 r>0,
E(T−r)=Γ(n)λn∫0∞tn−r−1e−λtdt=λrΓ(n)Γ(n−r),n>r.
最后一步用了 u=λt。这里必须保留 n>r:少了它,零附近的积分就不可积了。因此在 n>1 时有
E(λ^)=n−1nλ,Bias(λ^)=n−1λ.
当 n>2,再用 r=2 并减去期望平方,得到
Var(λ^)=(n−1)2(n−2)n2λ2,MSE(λ^)=(n−1)(n−2)(n+2)λ2.
于是,n=1 时,虽然每次都可能算出有限的估计值,期望却无限;n=2 时,均值有限,平方风险仍无限。问题在那些很小的总等待时间:它们不常出现,但取倒数后误差会被放得很大,足以破坏相应的矩。
若任务要求无偏,可以将规则修正为 (n−1)/T。修正后的估计已经不满足原矩方程 1/λ^=Xˉ,因此应明确称为经过偏差修正的规则。
3. 两参数例:伽马模型的形状与尺度
现在等待时间未必像指数分布那样只有一个形状。考虑形状 k>0、尺度 ϑ>0 的伽马模型:
f(x;k,ϑ)=Γ(k)ϑkxk−1e−x/ϑ,x>0.
密度乘上 xr 后积分,采用换元 u=x/ϑ,可以推导总体矩:
E(Xr)=ϑrΓ(k)Γ(k+r),k+r>0.
Gamma 函数满足 Γ(z+1)=zΓ(z):对 ∫0∞uze−udu 分部积分,边界项在 z>0 时为零,便得到递推。因此 E(X)=kϑ,E(X2)=k(k+1)ϑ2,两者相减给方差 kϑ2。这解释了为什么二阶原点矩不能直接写成 kϑ2。
记样本中心二阶矩
vn=n1∑(Xi−Xˉ)2=m^2−Xˉ2.
用 Xˉ=kϑ、vn=kϑ2 联立:第二式除第一式得 ϑ^=vn/Xˉ,再代回得
k^=vnXˉ2,ϑ^=Xˉvn.
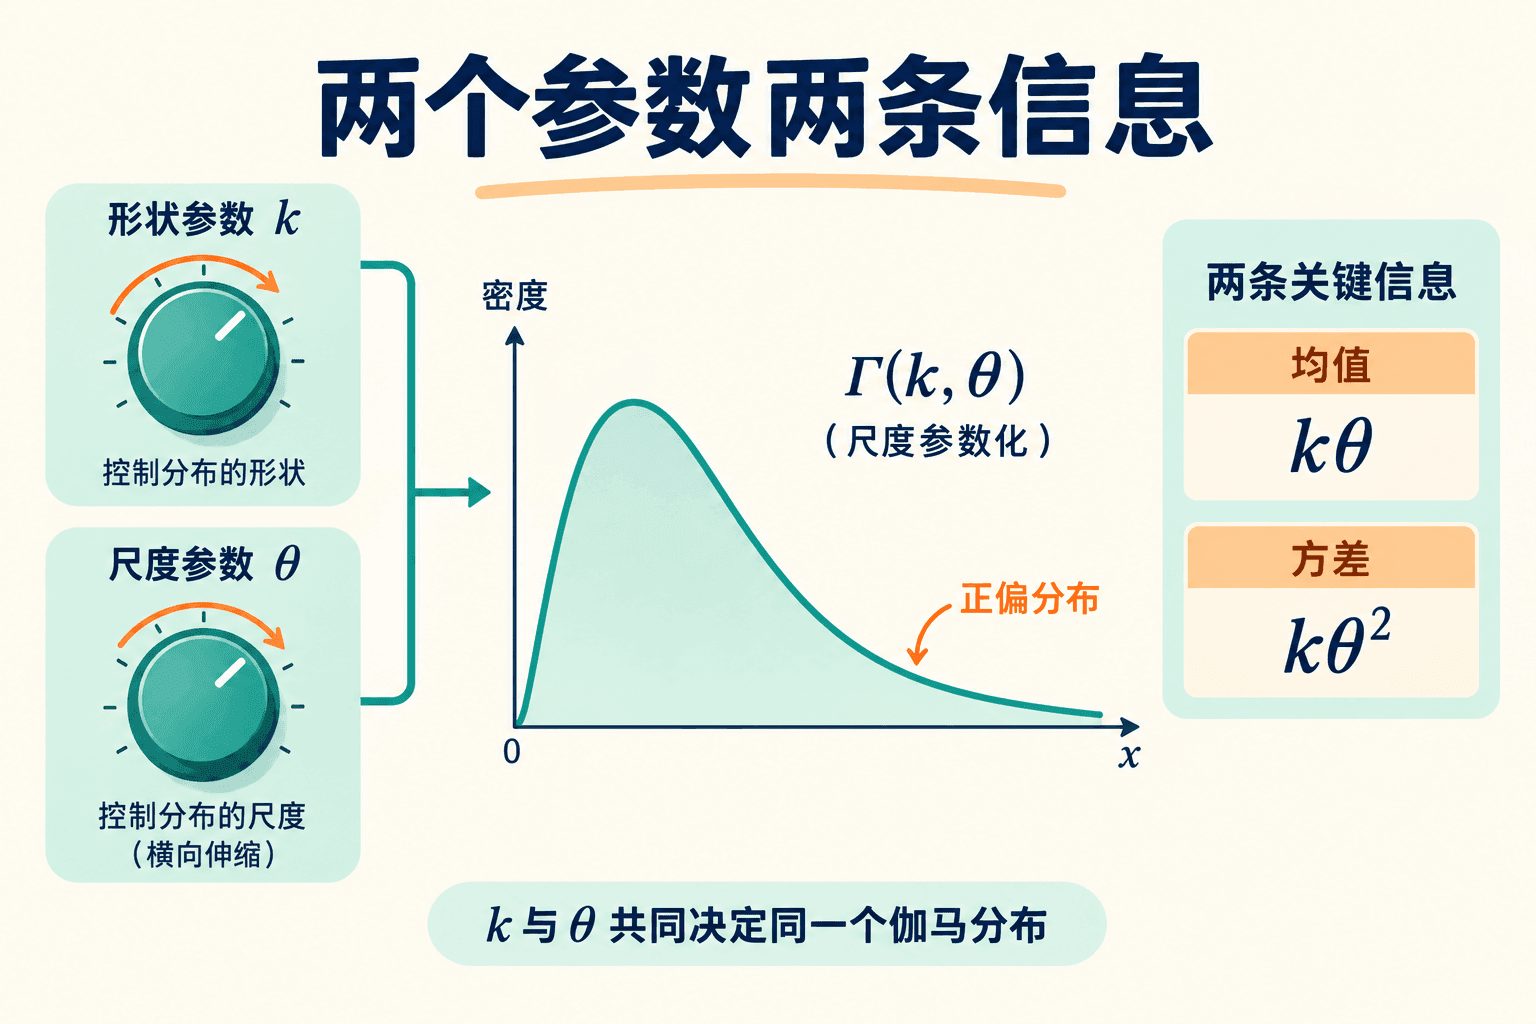 图 4-3:两个参数两条信息
继续用 2,3,5,6:样本均值为 4,平方平均为 (4+9+25+36)/4=18.5,所以 vn=18.5−16=2.5。于是 k^=6.4、ϑ^=0.625 秒。回代检查:6.4×0.625=4,6.4×0.6252=2.5,恰好匹配两条样本信息。
所有观测相同时,vn=0,矩方程没有有限的正参数解。这是方程退化,并非一个可以继续使用的正常参数值;除零结果应在这里被识别出来。
平均相同的两组等待时间
教学记录 A 为 2,3,5,6,B 为 1,1,1,13,平均都为 4 秒。匹配平均会得到相同的指数速率 0.25,B 中那次突出的长等待却没有被区分出来。Gamma 模型能够再匹配一个矩,用形状差异描述波动。
A 的中心二阶矩为 2.5。B 的平方平均是 (1+1+1+169)/4=43,减去均值平方后,中心二阶矩为 43−42=27。43 是原点矩,不能直接当作方差。
用均值方程 kϑ=4 消去一个未知量,再用方差方程确定另一个。A 得到 k=6.4,ϑ=0.625;B 得到 k=16/27,ϑ=27/4=6.75。
从参数再看回形状:Gamma 分布的变异系数是 Var(X)/E(X)=1/k。平均相同而相对波动更大,就需要更小的形状参数。尺度也得一起增大,才能让平均继续保持在 4。
两个矩匹配了,表示候选参数实现了这两个特征,还不足以证明 A 或 B 来自 Gamma 分布。B 中的单个大值已经明显影响二阶矩,需要核实它是过程本身的表现,还是记录错误。
若把秒换成毫秒,所有数据乘 1000,均值乘 1000、中心二阶矩乘一百万,因而 k=xˉ2/vn 保持不变,尺度乘 1000。形状应与计量单位无关,这个检查能发现把尺度和速率混用的错误。
实验:相同均值下的不同曲线
相同均值只固定了 Gamma 参数的乘积。第二矩是否也会相同,可以用前面的矩公式作出判断。
数据 2,3,5,6 给出一个起点。“均值不变:更分散/更集中”显示仅匹配均值时仍可改变的形状;启用两个矩同时匹配后,观察哪些变化不再允许。
形状 1、尺度 4,和形状 20、尺度 0.2,均值都为 4,第二矩却分别是 32 和 16.8。要同时匹配这批数据的两个矩,才会得到形状 6.4、尺度 0.625。
第一矩只限制 kθ=m₁,还留着调整空间。第二矩补上波动的信息,才把形状和尺度一起定下来。这里匹配方差时,用的是分母为 n 的经验中心矩。
4. 原点矩与中心矩的定义
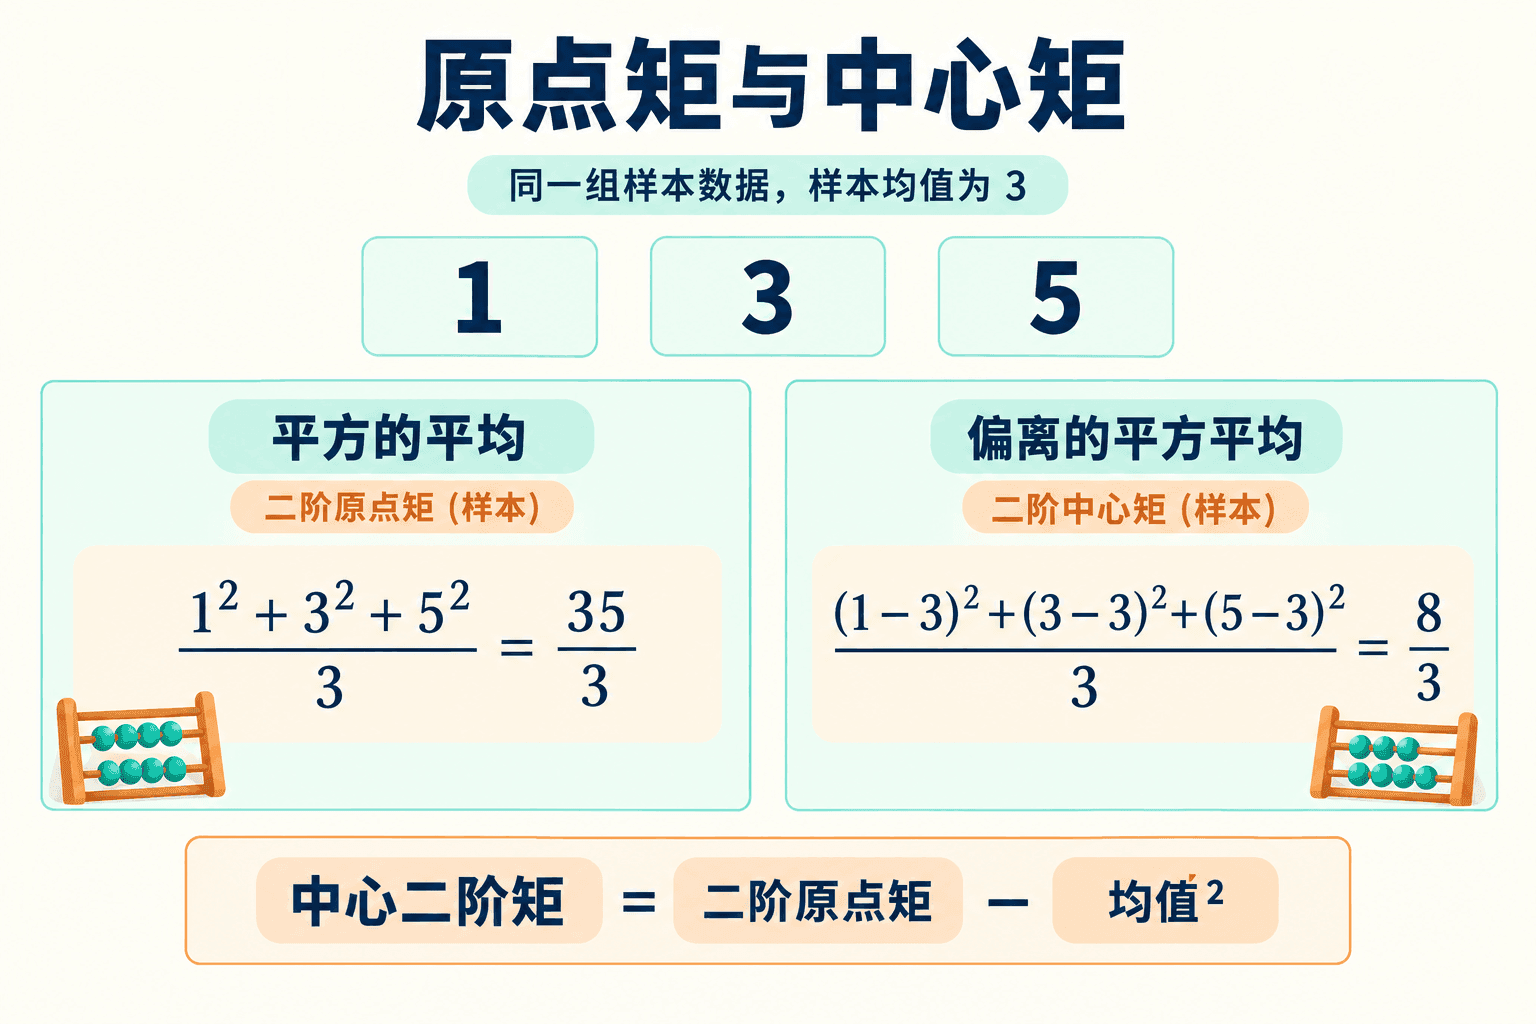 图 4-4:原点矩与中心矩
m^2 是“先平方、再平均”;vn 是“先减去样本均值、再平方平均”。二者由 vn=m^2−Xˉ2 相连,但并不相等。S2 又是第三个量:
S2=n−1nvn.
经典矩估计先匹配原点矩,所以推出来的中心矩分母自然是 n。你也可以用 S2 构造另一种估计,但要把修改说清,不能在原推导里悄悄换分母。
高阶矩会放大极端值的作用。一个观测从 5 变成 50,平方由 25 增至 2500,四次方变化更大。额外信息可能伴随不稳定的有限样本估计。使用相应矩之前,还需要确认它存在,且方程可以反解参数。
柯西分布就是一个不能照做的例子:它没有有限总体均值。手中的样本平均照样能算出来,却不能用不存在的 E(X) 写出有效的一阶矩方程。
5. 有界比例与合法的矩方程解
如果每个对象的连续比例在 0 与 1 之间,可以考虑 Beta(α,β),α,β>0,密度为 xα−1(1−x)β−1/B(α,β)。定义积分 B(a,b)=∫01xa−1(1−x)b−1dx,则
E(Xr)=B(α,β)B(α+r,β),E(X)=α+βα,E(X2)=(α+β)(α+β+1)α(α+1).
后二式用 B(a+1,b)=aB(a,b)/(a+b)。这个递推可由 B(a,b)=B(a+1,b)+B(a,b+1) 和对 xa(1−x)b 积分求导共同得到,不需把它当作一张孤立公式表。
令 m=E(X)、κ=α+β,方差简化为 v=m(1−m)/(κ+1)。所以反解为
κ^=vnXˉ(1−Xˉ)−1,α^=Xˉκ^,β^=(1−Xˉ)κ^.
合法的有限正解要求 0<Xˉ<1 且 0<vn<Xˉ(1−Xˉ)。例如四个比例 0.2,0.4,0.6,0.8,平均为 0.5,vn=0.05,得 κ^=4,α^=β^=2。回代方差是 0.25/5=0.05。
对任何位于 [0,1] 的记录,都有 Xi2≤Xi,所以 vn≤Xˉ(1−Xˉ)。等号只在全部记录取端点 0 或 1 时成立,这会给出 κ^=0,已不在正参数空间内。另一头,所有值都相同时 vn=0,同样没有有限解。程序若只报“计算失败”,你还分不清是离散程度过大,还是数据完全退化了。
精确的 0 或 1 需要结合记录方式解释。四舍五入、截断可能产生端点记录,过程本身也可能以正概率产生端点。连续 Beta 模型无法直接描述后一种机制,矩方程恰好有正解也不能替代这项检查。
6. 解出参数后,别漏掉支持范围
若 X∼Uniform(0,θ),则 E(X)=θ/2,矩估计为 θ^MM=2Xˉ。它是无偏的,且
Var(2Xˉ)=3nθ2.
但某次样本为 1,1,8 时,2xˉ=20/3<8。候选上界竟然小于一条实际观察,它不能覆盖全部样本,所给模型在该参数下的样本似然为零。
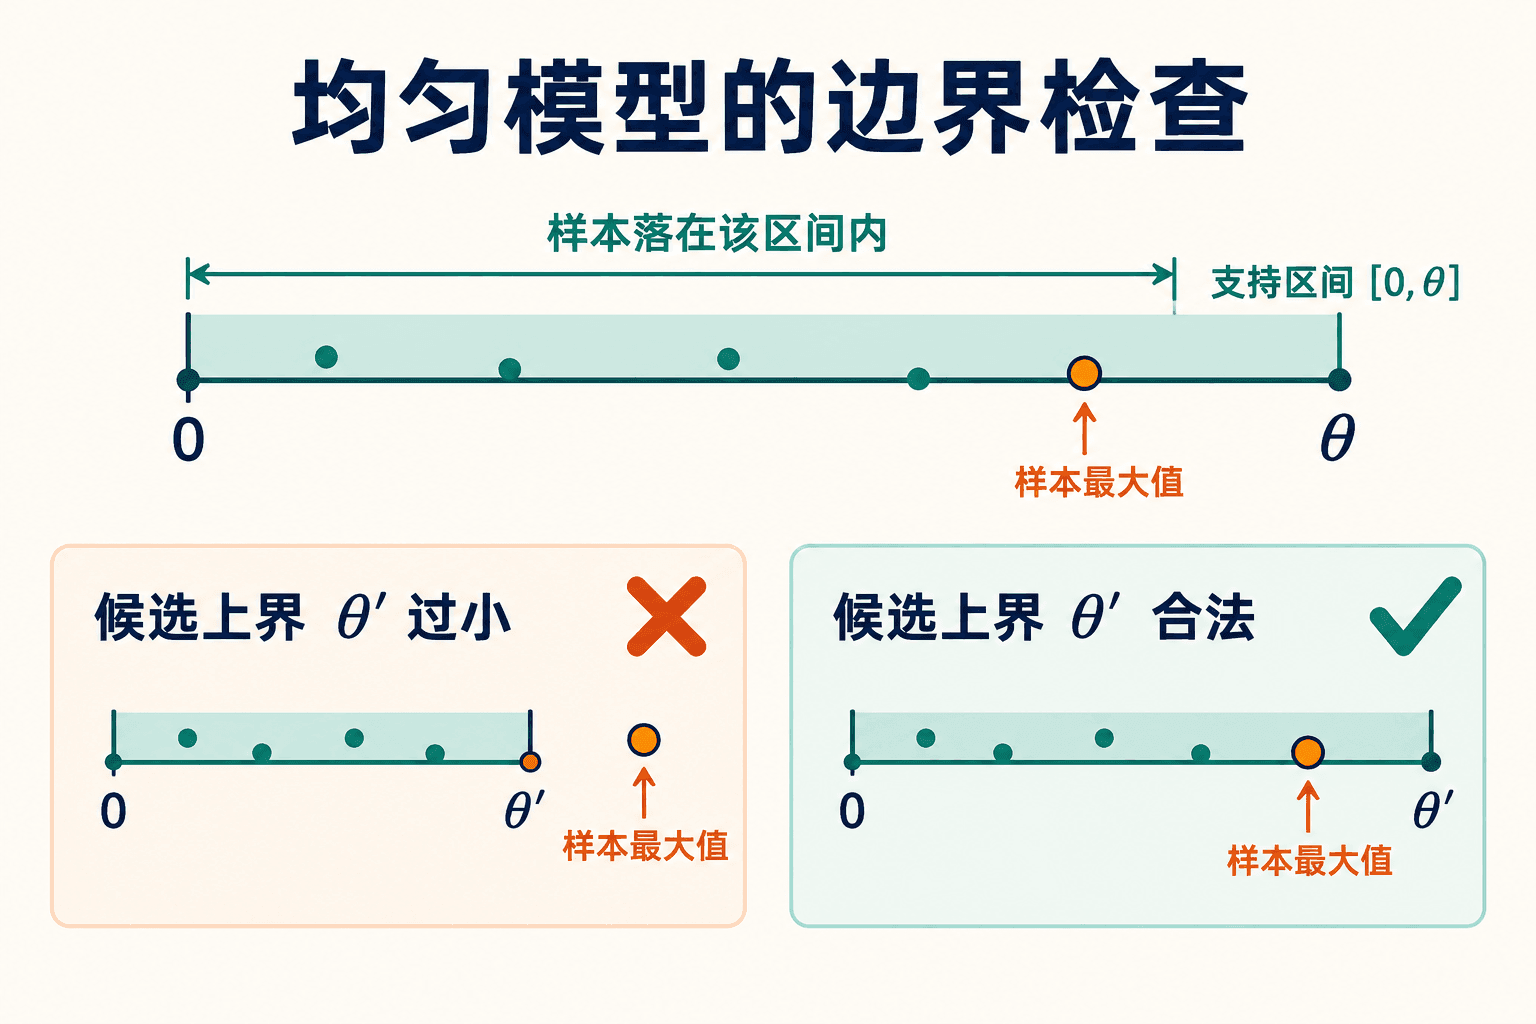 图 4-5:均匀模型的边界检查
均值方程没有要求上界覆盖最大值,因而可能出现这个结果。矩估计仍符合定义,但低阶特征匹配的局限已经显现。删掉那个 8,或不加解释地把估计改成 8,都掩盖了支持冲突。报告原结果后,可以改用考虑支持信息的方法;第 5 章的最大似然会用到样本最大值。
在同一个模型中,平均和极值都可以用来估计上界。它们的误差下降速度也不同,后面的计算会显示这一点。
两个端点都未知:匹配中心与宽度
对 Uniform[a,b],令中点 m=(a+b)/2、半宽 d=(b−a)/2>0。积分对称性给均值 m;以 y=x−m 换元,方差为 ∫−ddy2/(2d)dy=d2/3。因此
a^=Xˉ−3vn,b^=Xˉ+3vn.
这两个估计端点是否覆盖样本仍需检查。例如 0,0,0,4 给 xˉ=1,vn=3,估计区间为 [−2,4];如果改为九个 0 和一个 10,则 xˉ=1,vn=9,上端 1+27≈6.20,无法覆盖 10。匹配均值和方差没有施加极值约束,两个未知参数也不会自动解决这个问题。
矩估计失败的不同原因
所需的理论矩不存在时,矩方程缺少依据。柯西分布没有有限均值,因而不能从“一阶样本矩接近总体矩”出发。
矩存在也未必能识别参数。例如 Uniform(−θ,θ),无论 θ>0 取什么,均值总是 0;增加样本无法靠均值匹配唯一确定宽度。二阶矩 θ2/3 在正参数空间中才有唯一反解。
还应把上述失败与本次数据的支持冲突分开。2Xˉ 作为均匀上界的矩估计在理论上既无偏又一致,但有限样本可能落在 maxXi 左边。一个算法在某些数据上给出令人不满意的候选值,并不等于它完全没有渐近性质;反过来,有渐近性质也不能免除对当前数据的检查。
所需矩的存在性与参数识别,决定了反解是否有依据。对已经算出的候选值,还应核对参数空间和观测支持:合法的参数未必覆盖这次全部数据。这些检查不能互相替代。
实验:矩估计区间与观测支持
记录 1,1,20 的最大值为 20。用均值方程估计上界,判断候选区间能否覆盖它,以及第三个观测降低到哪里时两者恰好相等。
第三点可以从 20 拖至 4,滑块、数值框和键盘方向键也能修改它。临界位置可直接对照上界估计。数据 3,4,5 则提供了一组能覆盖全部观测的参照。
1,1,20 给出矩估计 44/3<20,样本似然为 0。第三点降到 4 时,矩估计和最大值都等于 4;换成 3,4,5,矩估计为 8≥5,这次能覆盖全部观测。
均值方程本身没有加入支持约束。按这里的闭区间密度约定,可行参数满足 θ≥max;似然在这个可行域内递减,所以 MLE=max。你可以对照两种规则,看看它们分别用了样本中的哪部分信息。
7. 一致性的条件与实践顺序
若所选总体矩存在,样本矩由大数定律趋近总体矩;若参数可以写成这些矩的连续函数 θ=h(m1,…,mr),则连续映射定理给出矩估计的一致性。关键是函数在真值附近连续,并且分母、根号等不会在那里退化。
Gamma 两参数模型可以把这些条件落实到完整证明。设真参数 k0,ϑ0>0,由于 E(X2)<∞,对所需样本矩分别使用弱大数定律,得到
XˉPk0ϑ0,m^2Pk0(k0+1)ϑ02.
由加减乘法的连续性,vnPk0ϑ02>0。取这一正极限的一半为阈值,vn 落到阈值以下的概率趋零,故倒数不会在高概率区域突然爆炸。再应用 h(m,v)=(m2/v,v/m) 在两个正极限附近的连续性,得到 (k^,ϑ^)P(k0,ϑ0)。
这一步只需要 E∣X2∣<∞,也就是有限二阶矩,还没用到有限四阶矩。如果想进一步用 Chebyshev 给样本二阶矩作方差界,或者求它的正态极限,才要加更强的矩条件。换了证明工具,所需条件可能不同。
还有一个概念需要拆开:分布模型可识别,不代表所选的少数矩足以识别。N(θ,1) 的不同 θ 对应不同分布,模型可识别;但只选 E(X2)=1+θ2,仍无法确定符号。选一阶矩就能修复这个信息选择错误。
 图 4-6:矩估计工作台
遇到新模型,理论矩给出特征与参数的关系,样本矩则提供方程右侧的数值。解出候选参数后,支持和单位可以帮助发现问题。偏差、方差与 MSE 属于评价规则的工作,使用第 3 章的方法计算。
矩匹配的对象
1数据均值为 4,平方平均为 18.5。直接用于匹配总体方差的经验中心二阶矩是多少?
2写出与参数个数相同的矩方程后,仍需检查是否存在唯一合法解。
3指数模型的平均等待时间估计为 8 秒,速率估计是多少每秒?填写小数。
8. 练习:矩估计的构造与检查
练习 1|反向推导矩。 对形状 k、尺度 ϑ 的 Gamma 密度,从积分求 E(X3),再求 k=2,ϑ=3 时的前三阶原点矩。
换元 u=x/ϑ 得 E(X3)=ϑ3Γ(k+3)/Γ(k)=k(k+1)(k+2)ϑ3。前三阶矩为 6、54、648。方差为 54−36=18,不能把第二阶原点矩 54 当作方差。
练习 2|倒数估计的风险。 五次指数等待,总时间为 20 秒。给出速率矩估计及无偏修正;分别算二者的偏差、方差和平方风险,以真实速率 λ 表示。
两次报告为 5/20=0.25、4/20=0.2 每秒。矩估计偏差 λ/4、方差 25λ2/48、风险 7λ2/12。修正值无偏,方差及风险均为 λ2/3。样本给出的是本次值,风险仍必须写成真实参数的函数。
练习 3|有界比例的两参数解。 比例记录的均值为 0.3,经验中心二阶矩为 0.035。求 Beta 两参数矩估计并检查合法性。若保持均值而把方差换成 0.24,又会怎样?
κ^=0.21/0.035−1=5,得 α^=1.5,β^=3.5,参数均正。0.24 超过 0.3(1−0.3)=0.21,不仅没有正 Beta 解,也不可能是位于 [0,1] 数据的分母 n 中心二阶矩;应检查数据范围、摘要定义或计算。
练习 4|支持不是回代矩。 数据为 1,2,3,8,用未知两端的均匀模型拟合。给出两个矩估计端点并检查全部观测是否落在区间内。
xˉ=3.5,m^2=19.5,vn=7.25。半宽 21.75≈4.664,端点约为 −1.164,8.164,覆盖本次全部数据。若任务本身规定端点必须非负,还应按这个额外参数约束判为不合法。覆盖观测和落在参数空间分别检查。
练习 5|模型识别与特征识别。 X∼N(θ,1)、θ∈R,只匹配二阶原点矩。讨论样本二阶矩大于、等于、小于 1 时的方程解,再给一个更合适的单矩选择。
方程是 1+θ2=m^2。样本二阶矩大于 1 时有正负两个解,等于 1 时只剩 0;小于 1 则没有实数解。分布模型仍可识别,丢掉方向的是所选的矩。改用 E(X)=θ,得到 θ^=Xˉ,符号无需事后指定。
练习 6|逐项核对一致性。 对 Uniform[−θ,θ]、θ>0,从二阶矩推导估计并证明一致。它是否无偏?提示:检查平方根的凹性。
积分给 E(X2)=θ2/3,故估计为 3m^2。有界观测保证二阶矩有限,大数定律给 m^2→θ2/3,平方根连续给一致。Jensen 给期望严格小于 3Em^2=θ,因为有限样本二阶矩非退化,所以有向下偏差。
练习 7|稳定性需要什么矩。 已知总体二阶矩有限、四阶矩无限。样本二阶矩是否仍由大数定律一致?是否可以声称它的方差有限并直接用 Chebyshev?
将 Yi=Xi2 视为新的 iid 变量,E∣Yi∣=E(Xi2)<∞ 已足以使用弱大数定律,因而仍然一致。它们的方差却涉及 E(Xi4),这里为无限,不能应用有限方差的 Chebyshev 计算。常见方差界和平方根样本量的正态近似,也没有从现有条件中获得保证。
练习 8|单位是检错工具。 Gamma 矩拟合得到形状 3、尺度 2 秒。数据全部改成分钟后,形状、尺度及采用速率参数时的值是什么?用均值和方差回代。
形状仍为 3,尺度为 1/30 分钟,速率为每分钟 30。均值 3/30=0.1 分钟等于 6 秒;方差 3/900=1/300 分钟平方等于 12 秒平方。形状无单位,尺度随时间单位换算,速率作倒数变化。