置信区间来自一个采样前的概率事件。把事件反解为参数范围,覆盖保证便随之保留;配对方式、尺度假设和近似方法都会影响这个保证。
1. 95% 描述区间方法的覆盖率
报告写着“平均值为 12,95% 区间为 9.85 到 14.15”。这个 95% 既不表示相应比例的测量值落在里面,也不是本课程频率学派框架下固定真值的后验概率。它描述反复按同一规则构造区间时,区间覆盖真值的概率。要看清这一点,需要写出采样前的随机事件。
记随机区间为 C(X)=[L(X),U(X)]。若对模型中的每个参数 θ 都满足
Pθ{θ∈C(X)}≥1−α,
就得到覆盖水平至少为 1−α 的置信区间方法。连续精确情形常等号成立;离散模型可能保守,大样本方法可能只在极限中达到所需覆盖。
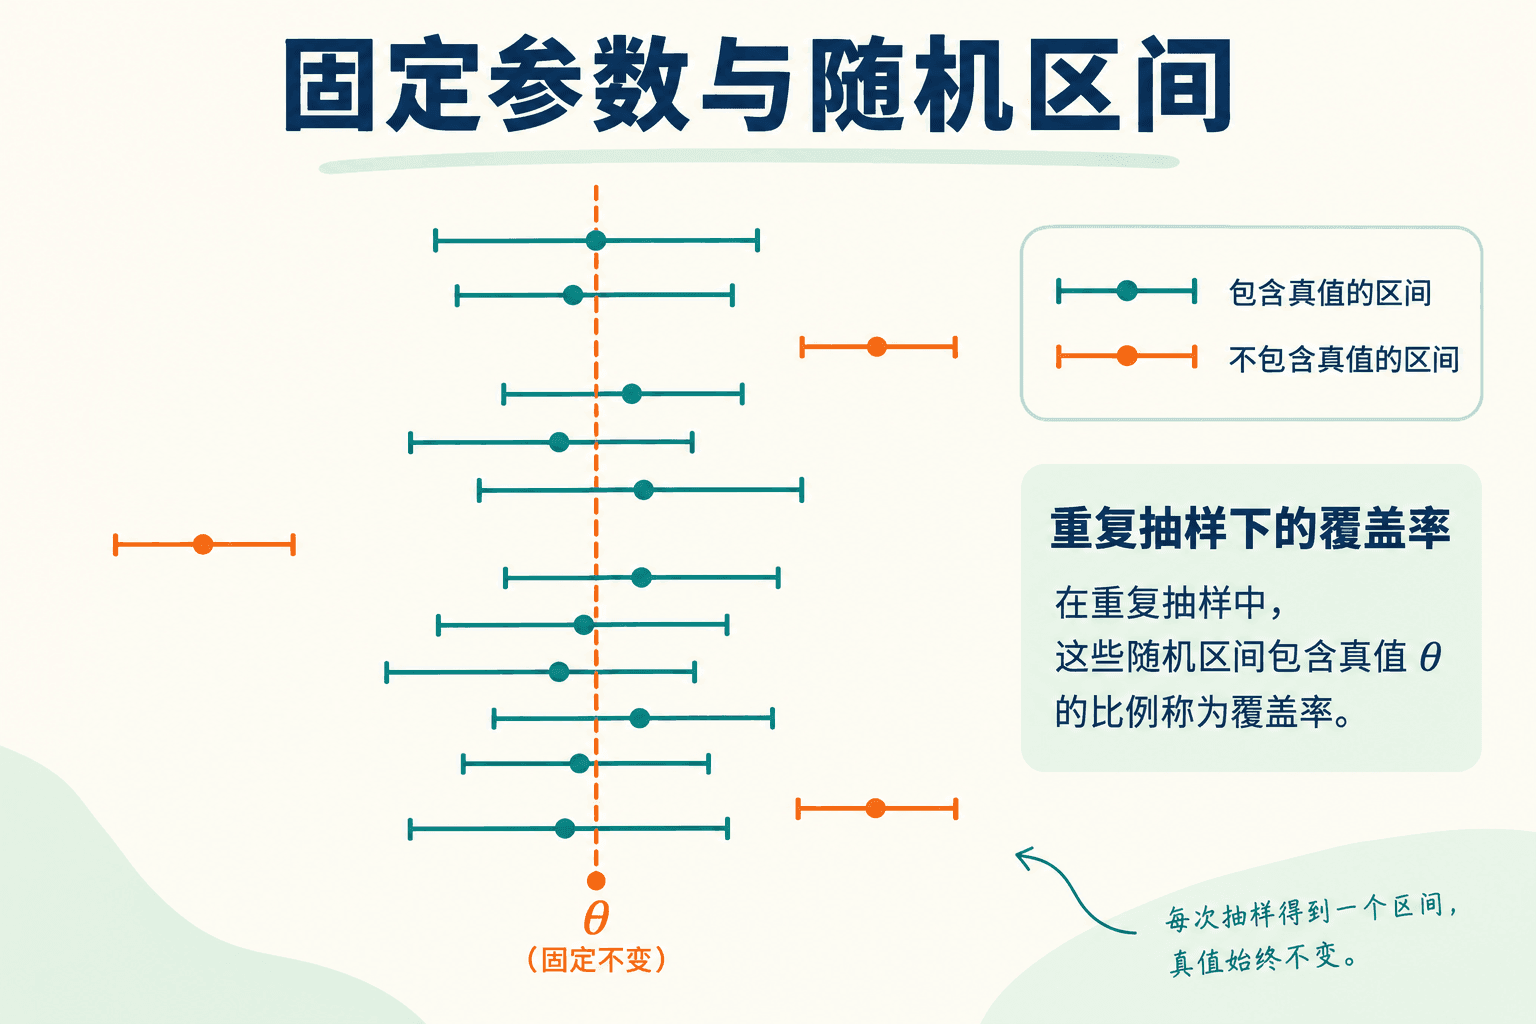 图 9-1:固定参数与随机区间
图里每换一批样本,区间就会移动,真值线始终固定。等这一次数据已经收完,算出的区间要么覆盖真值,要么没覆盖。95% 描述的是反复这样构造区间的覆盖率,既不是给固定参数分配后验概率,也不是说 95% 的个体观测会落进来。
覆盖率属于整套规则,抽样方式、按结果选模型以及反复查看后决定何时停止,都可能影响它。只保留“看起来漂亮”的区间,原来的保证便可能失效。
有限次模拟中的覆盖次数也会波动
假定每次都用精确覆盖率为 95% 的同一个方法,且重复实验独立。100 次中覆盖多少次,就服从 Bin(100,0.95),期望 95,标准差为 100×0.95×0.05≈2.18。所以偶尔不是恰好 95 条,并不能据此说方法错了。
这里有两层波动:每条区间的位置和宽度来自那一批样本,100 条中的命中比例还会因为重复次数有限而变化。多做几次模拟,会更稳地估出所模拟模型的覆盖率,但不会改善已经收集好的某一批真实样本。
已经算出的区间究竟覆盖了没有,通常仍然不知道。但不知道真值在哪,并没有把频率学派的固定参数变成具有后验概率的随机变量。
2. 枢轴量:从一个已知分布反解参数
枢轴量 Q(X,θ) 的分布不含未知参数,表达式本身却可以含参数,因而未必是统计量。它的已知概率范围可以写成不等式,由此反解未知参数。
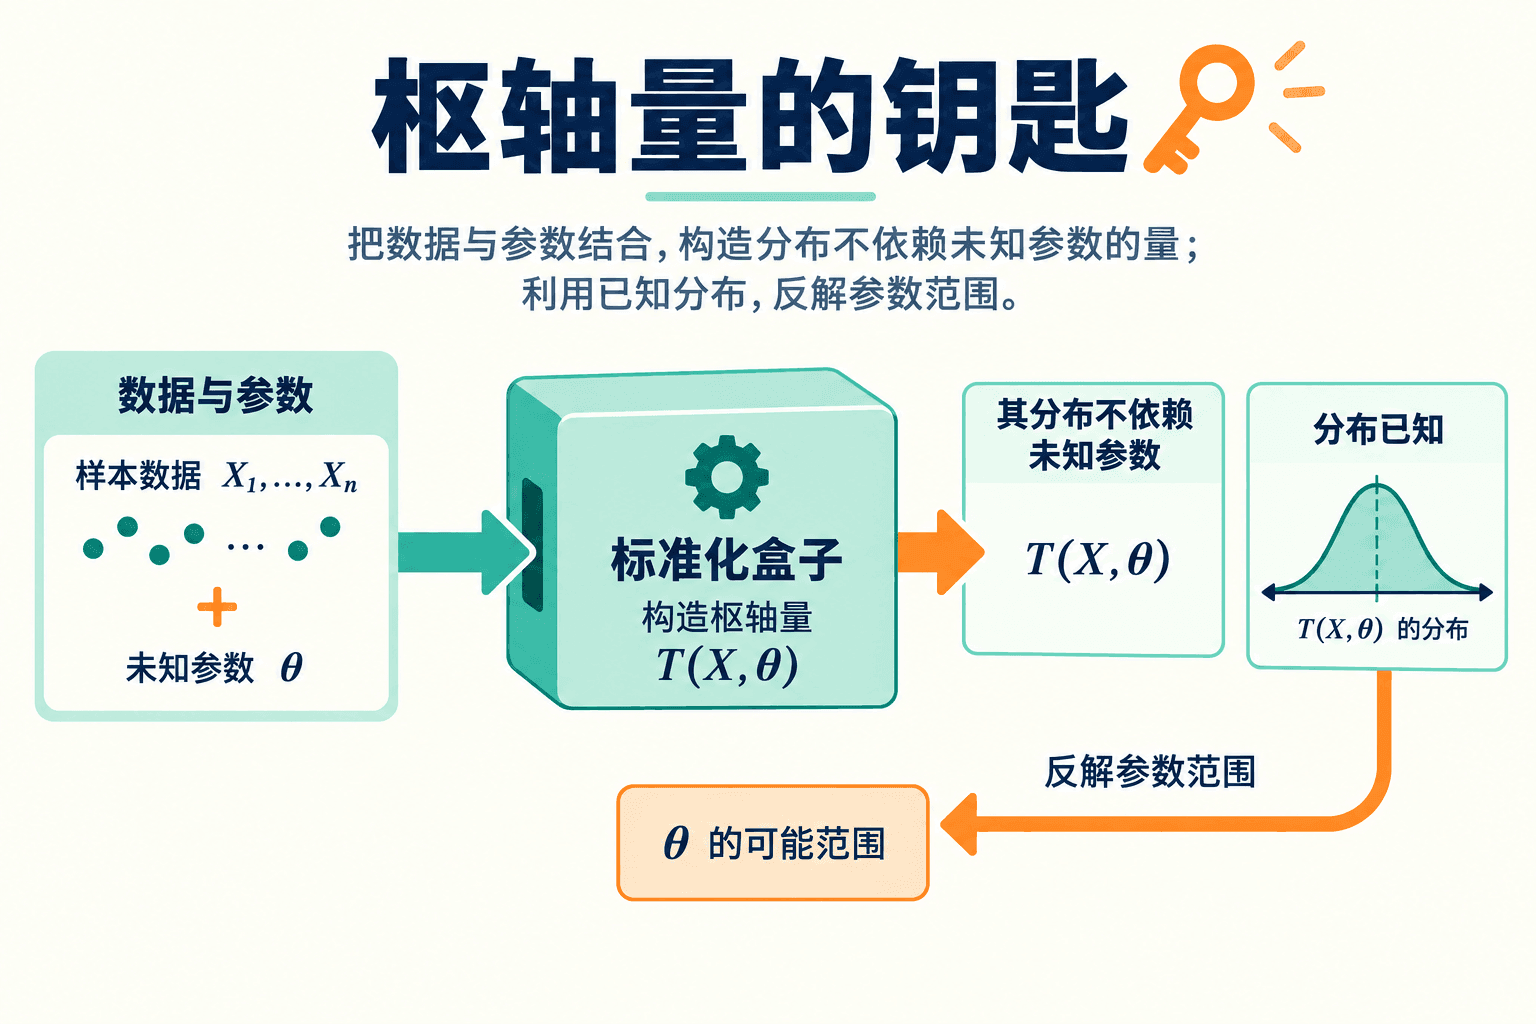 图 9-2:枢轴量的钥匙
例如独立正态样本且 σ 已知时,Z=n(Xˉ。令 表示标准正态的 分位数,有
P(−z1−α/2≤σ/n
因分母为正,整理得到
μ∈[Xˉ−z1−α/2
这样得到的范围有一个明确来处:刚才那个概率事件被改写成了参数落在区间里的事件。每个不等号都保留着同一个覆盖关系。
3. 方差未知:从 t 枢轴量得到均值区间
独立正态样本下,T=(Xˉ−μ)/(S/n。完全相同的反演得到
Xˉ±t1−α/2,n−1
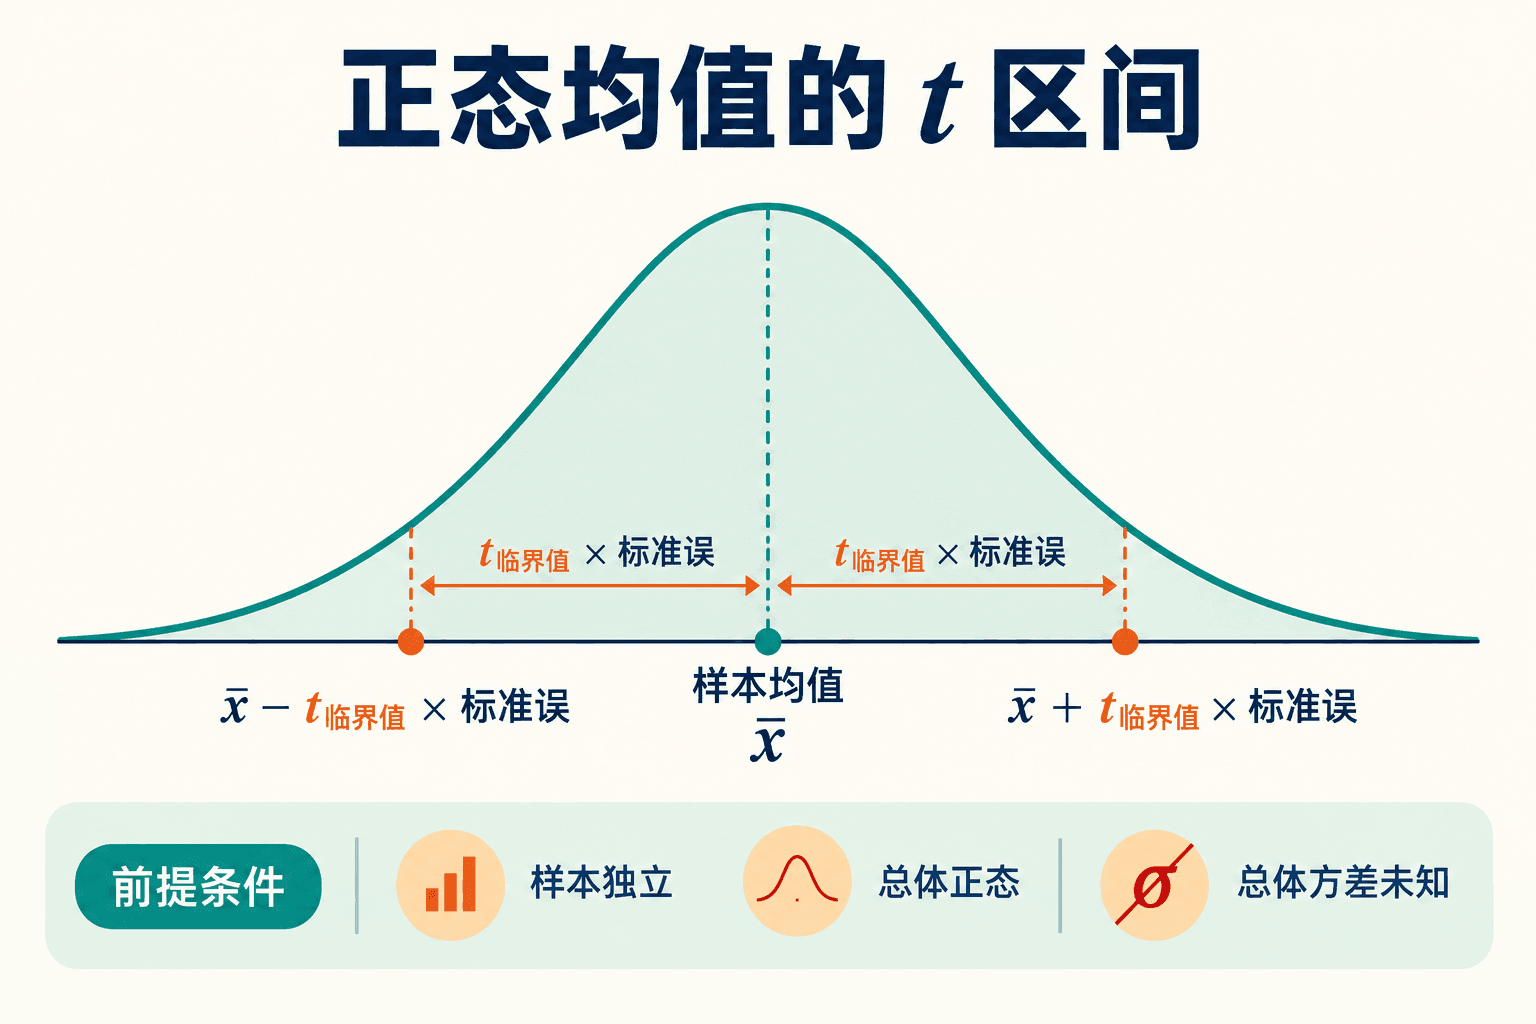 图 9-3:正态均值的 t 区间
完整例。 10 次独立正态测量的样本均值为12、样本标准差为3。95%区间采用 t0.975,9≈2.262157,标准误为 3/10,误差界约2.146071,故区间约为 。
误用 1.96 会缩窄区间,也遗漏估计尺度的不确定性。非正态总体有时可使用同样形式的大样本近似,但小样本正态模型的精确覆盖保证不能直接沿用。
跟着不等号,把均值解出来
继续使用 n=10,xˉ=12,s=3 写出完整反演。只记“均值加减临界值乘标准误”,换模型时容易漏掉不等号方向或必要条件。
采样前,独立正态样本保证 T=(Xˉ−μ)/(S/10 精确服从 ,相应的中央 95% 事件为 。
如果你想预测下一个单独观测,这个区间就不够宽了:它只算了估计均值的不确定性。第 12 章会把新观测自己的噪声加上,得到预测区间。
两个独立样本的尺度假设
目标为 δ=μ1−μ2。第 2 章已从独立卡方和推导合并方差 Sp2 及精确 t 枢轴量,所以同方差正态模型给
(Xˉ1−Xˉ
若方差不同,估计均值差方差的量是 V=S12/n1+S22。两份卡方的尺度不同,不能再把它们相加直接称为同一尺度卡方。Welch 方法用一个缩放卡方近似 ,形成近似自由度
ν^=(S
由此报告 (Xˉ1−Xˉ2)。自由度可以不是整数,因为这次是在近似分布形状,没有宣称真的留下了这么多个独立坐标。
其来源可由矩匹配理解:正态模型下 EV=v1+v2,其中 v,且 。若用 近似,均值 、方差 ,反解 ,再把未知 用样本估计代入,便得到上式。匹配两个矩没有证明两分布相等,因此这里明确是近似区间。
配对记录:应该对差值抽样
同一个对象在两种条件下各测一次,记 Di=Yi−Xi。若不同对象独立,且差值 iid 正态,则 是平均差的精确区间。对象内部的两次读数允许相关;差值的方差是 。
六个独立对象的差值 2,1,3,0,2,4 给出均值 2、离差平方和 10,以及 SD2=2。95% 区间为 ,约 。独立单位是 6 个差值,不能将 12 个原始读数拆作两组独立样本。配对关系也必须来自原设计,不能为了缩短区间事后重配。
4. 方差区间:取倒数会反转次序
对独立正态样本,Q=(n−1)S2/σ2∼χn−1。记 、,则
P(qL≤σ2(n−1)
由于各量为正,反解为
[qU(n−1)S
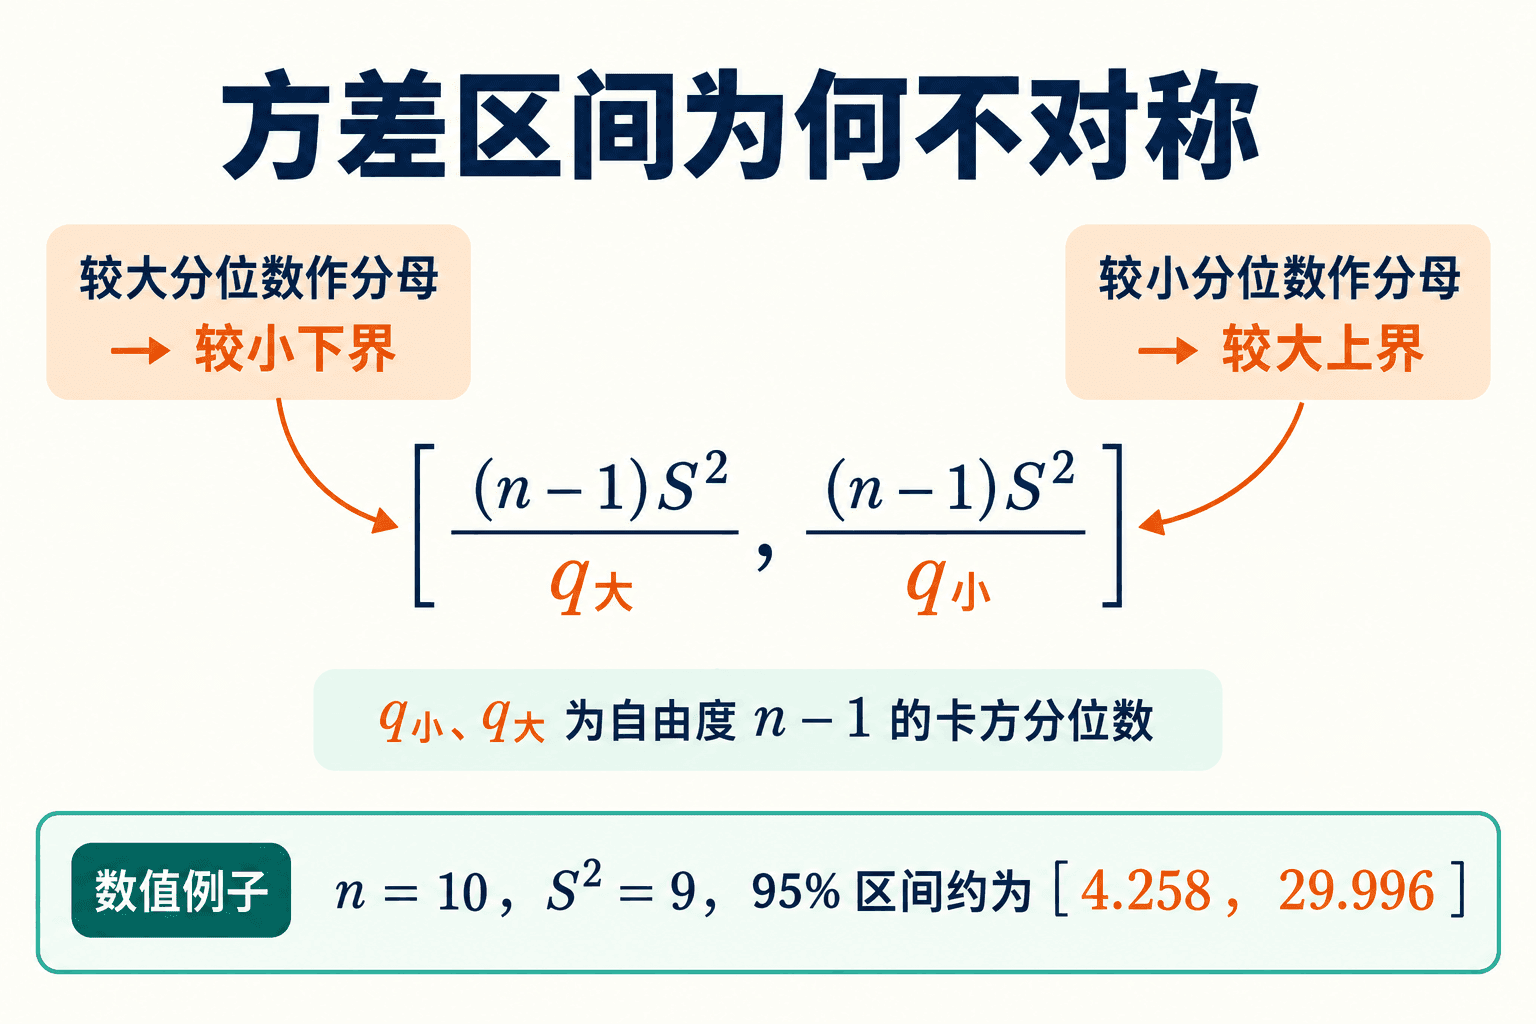 图 9-4:方差区间为什么不对称
取倒数后,大的卡方分位数跑到了下限的分母,小的跑到了上限。区间通常不围绕 S2 对称,别硬写成加减同一个误差。如果目标是标准差,对两个端点分别开平方即可;这个单调变换保留同一个覆盖事件。
继续用 n=10,S=3,95%方差区间约为 [4.258055,29.995673];这是方差单位,不能与均值区间混淆。宽度较大也反映了小样本估计尺度的不确定性。
实验:区间反解与端点次序
提高置信水平会扩大保留的中央概率区域。用前面的不等式判断均值区间与方差区间的端点怎样移动。
默认设置为 n=10、x̄=12、s=3、水平 0.95,各步展开显示反解过程。将水平改为 0.99,可比较端点变化。方差模式中的取倒数步骤尤其需要留意左右次序。
均值区间关于 x̄ 对称,方差区间通常不关于 s² 对称。方差下限的分母采用右侧 χ² 分位数,正是取倒数反序的结果。
均值那一步乘的是正数 s/√n,不等号方向不变;方差那一步取正数倒数,顺序会反转。概率来自采样前的枢轴分布,代入数据后才得到这一次的参数区间。
方差比与指数速率:同一个反演方法的两个新用法
设两个独立正态样本的真实方差比为 r=σ12/σ22,记观测方差比 R=。第 2 章给 ,其中 。记上下分位数 ,则 等价于
fUR≤r≤f
如果改研究 1/r,就对端点取倒数,并交换它们的顺序。只给原答案整体添一个倒数符号,容易写错区间。这里换的是参数尺度,覆盖事件仍要相同。
再看 iid 指数速率 λ。总等待 T 为形状 n、速率 λ 的 Gamma,第 2 章的密度缩放给 2λT∼χ2n。因此等尾区间为
[2Tχα/2,2n2,
指数速率在枢轴量的分子,反解时两分位数不颠倒;正态方差位于分母,需要反序。目标改为平均等待 1/λ 时,对端点取倒数并交换次序即可。每次保持同一概率事件,便能确定正确方向。
5. Wald 区间的局限与得分反演
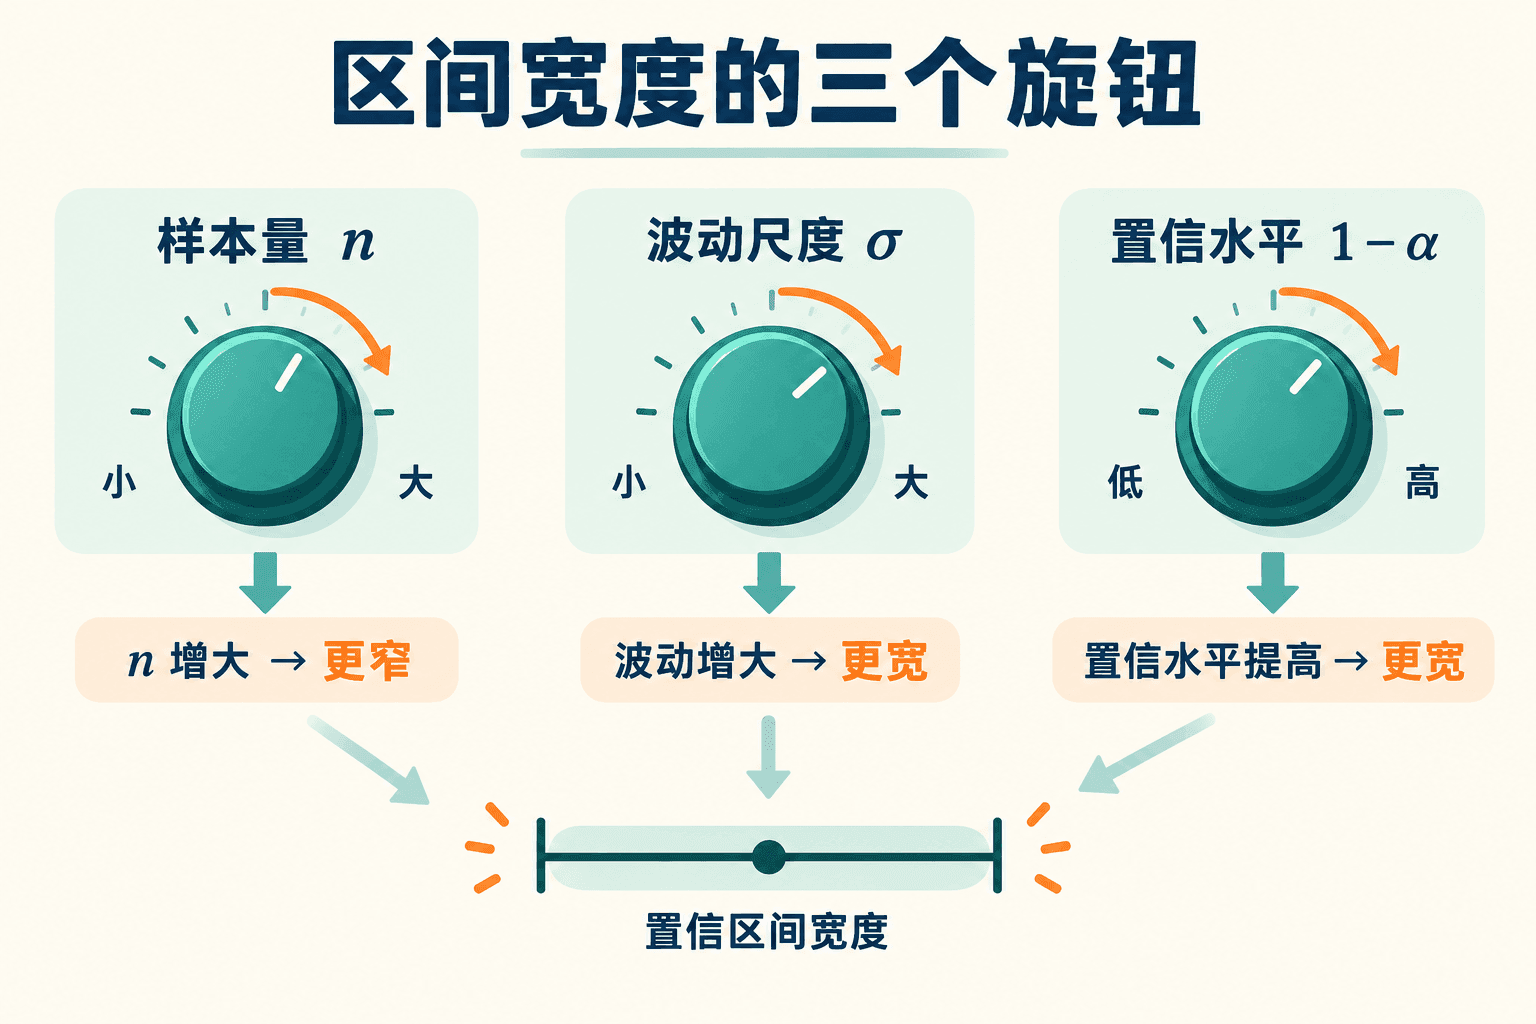 图 9-5:区间宽度的三个旋钮
若 n(Tn−θ) 且有一致的方差估计,可构造近似区间 。这依赖渐近近似,并非有限样本的普遍保证。
样本比例的最直接 Wald 区间是 p^±zp^(1−p^。小样本或接近0、1时它表现可能很差:全失败样本会给出零宽区间,却不能证明总体成功概率必为零。
一种更合适的替代是反演得分检验,得到 Wilson 区间:
1+z2/np^
Wilson 公式来自近似得分条件 n(p^−p)2≤z2p(1−p) 的反演。展开不等式,合并 的项,得到
(n+z2)p2−(2np^+
二次项系数为正,满足条件的 p 在两个实根之间,用求根公式并整理即得到上式。这里把方差保留为候选值的函数参与反演,与先代入 p^ 再计算标准误的 Wald 路线不同。
这条路线避免了端点处机械产生零宽区间,却没有保证每个参数的覆盖率都恰等于名义值。严格的有限样本保证可由精确二项检验反演获得,相应区间可能保守。宽度比较应以相同覆盖要求为前提。
其他条件固定时,增加样本量通常会缩窄区间。如果观测波动更大,或要求更高的置信水平,区间反而需要更宽。脱离这些条件,单看宽度无法评价方法。
零次成功并不意味着零不确定性
在 10 次独立伯努利试验中没有成功,Wald 区间退化为 [0,0]。但若真实 p=0.1,仍有 0.910≈0.3487 的概率出现这份数据。如此常见的一份结果,不可能据此把所有正概率都排除。
对“全失败”这一特定观测,单侧 95% 精确上界可以由 (1−pU)10=0.05 反解,得到 pU。相应双侧等尾 95% 精确区间把上侧使用的尾概率换为 0.025,得到上界约 0.3085。两者回答的尾部要求不同,不能把单侧上界与双侧区间混着比较。
同一数据的 Wilson 区间约为 [0,0.2775]。零宽退化得到避免,但它仍不保证每个 p 处精确覆盖 95%。区间宽度不同,需要结合方法承诺的覆盖性质解释。
比较谁更窄之前,要固定覆盖要求、模型、尾部方向和抽样规则。忽略尺度估计、挑样本,或看到结果才改成单侧,都会让名义覆盖失去原来的依据。
成功次数不在端点,也能精确反演
仅知道全失败的特殊公式还不够。设 S∼Bin(n,p),观察到 s。对于 0<s<n,定义下端 p 为满足
PpL(S≥s)=
的解,上端 pU 为满足 PpU(S≤s) 的解。下端排除那些“这么多成功几乎不可能”的过小参数,上端排除那些“这么少成功几乎不可能”的过大参数。 时取 , 时取 ;另一端仍用其尾方程。
尾函数的单调性保证了二分求根的依据。用独立 Ui∼Uniform[0,1] 构造 Xi(p)=,在同一组 下,成功数随 单调不减;因此 单调增加, 单调减少。内部相关尾函数还连续且严格单调,根也随之唯一。
把“覆盖至少达到要求”证明出来
固定真实 p。下端超过真值的事件 pL(S)>p,表示观察到了过大的成功数,其上尾概率小于 α/2。由于成功数有序,所有导致该事件的取值组成一个上尾;这个上尾的概率至多 α/2。同理,上端小于真值的事件概率至多 。两者是区间未覆盖的两种方式,概率相加至多为 ,所以覆盖至少 。
离散尾概率是一跳一跳变化的,两尾通常没法各自恰好用完 α/2。留下的错误预算就让区间偏保守。这里“精确”表示按有限样本真实分布给出至少名义水平的保证,并不表示每个 p 处的覆盖率都刚好等于它。
还可以不模拟而枚举检查覆盖:对给定 p,算 s=0,…,n 的全部区间,并求
C(p)=s=0∑n1{p∈
这个求和算的是整套方法在当前真参数下的覆盖率。只量一条区间有多宽,还回答不了这个问题。
6. 把不能拒绝的参数收集起来
对每个候选参数 θ0 做一个水平为 α 的检验,把不能拒绝的参数全部收集起来,即得到对应的置信集合。这是检验反演。令 A(θ0) 表示在候选值 θ 下不拒绝的样本集合,定义 。对真实 ,
{θ∈/C(X)}={X∈/A(θ)}.
右边就是在真实零假设下误拒绝的事件,概率至多 α,所以覆盖得证。即使最后的置信集合不连成一段,这条论证也成立。要得到通常的一段区间,还得有单调等额外条件。
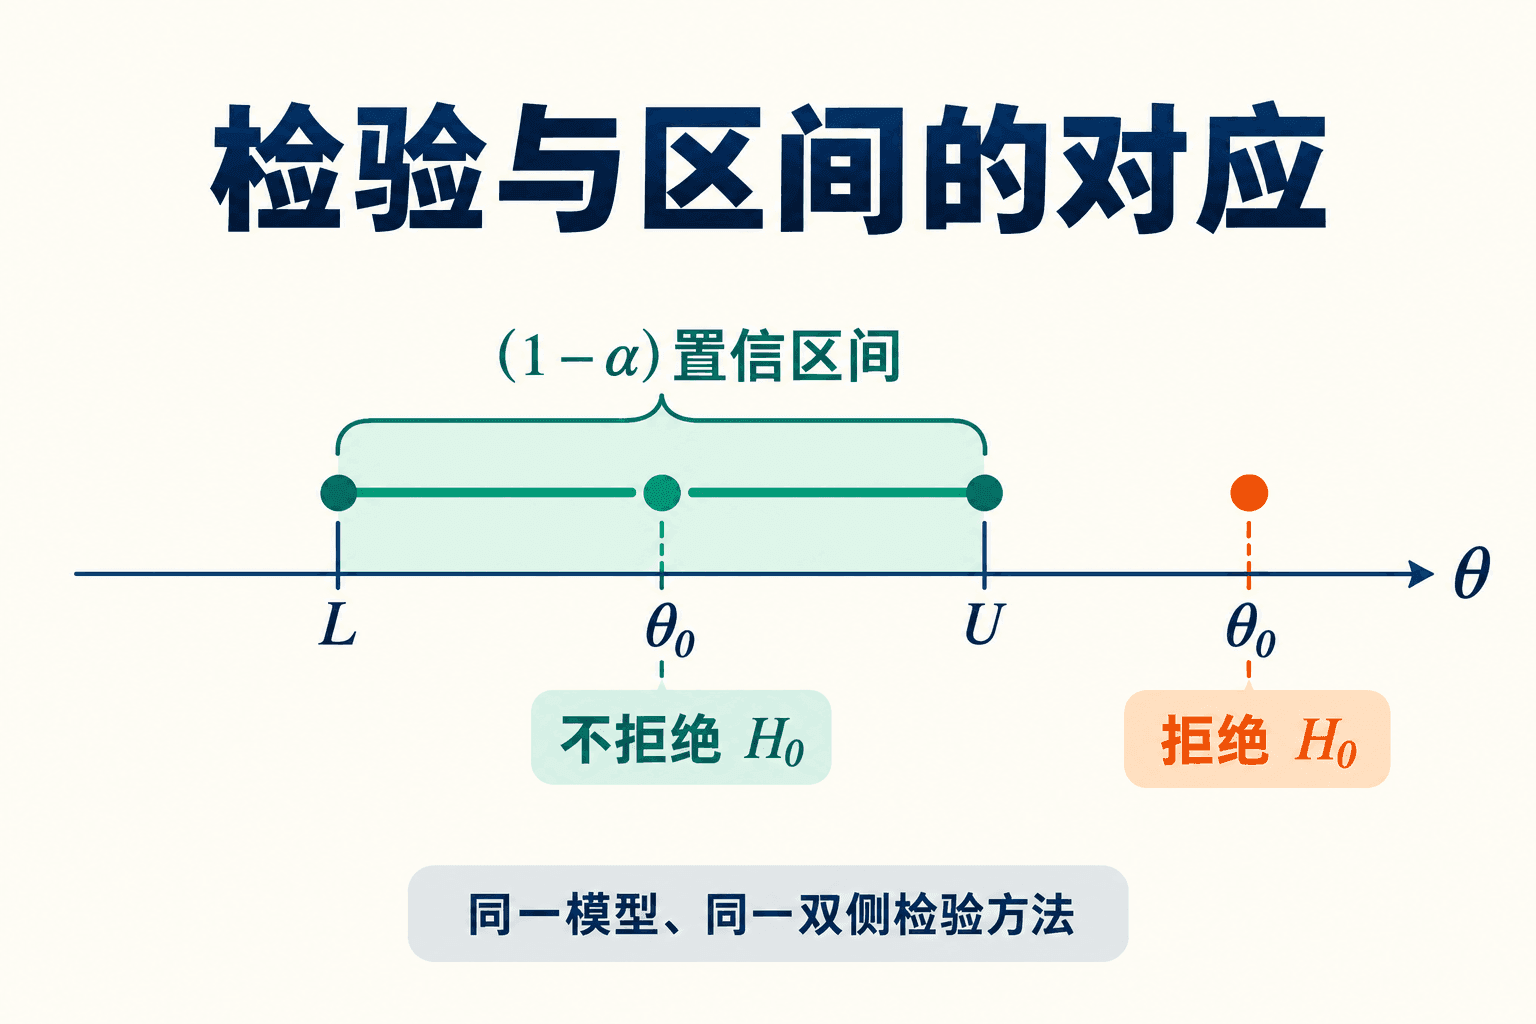 图 9-6:检验与区间的对应
例如同一正态模型下,双侧5% t检验不拒绝 μ0 当且仅当 μ0 位于相应95% t区间内。但若区间与检验使用不同近似、不同尾部或不同方差假设,就不能强行要求二者一一对应。
区间包含零,不能证明效应等于零;排除了零,也没有说明差异在实际中足够大。估计值、单位和区间需要结合任务中有意义的差异尺度解释。
实验:固定真值下反复生成区间
重复 100 次构造 95% 区间,命中次数本身仍有随机性。根据本章开头的二项分布,判断覆盖带是否必须恰好命中 95 次,同时留意固定真值线的位置。
保持 μ=12、σ=3、n=10,在 100 与 500 组之间切换。种子与置信水平可以分别调整;点击覆盖带,或使用“第几次抽样”滑块,可以查看某一条区间。
真实 μ 的竖线固定,区间位置和长度随样本变化。命中标 ○,未命中标 × 和虚线。模拟比例不必恰好等于名义比例,刚才的覆盖次数分布已经解释了这点。
种子、μ、σ、n 和重复数固定时,调整置信水平会复用同一批样本,便于比较。一条已经算出的区间,要么命中 μ,要么没命中;95% 说的是长期按规则构造时的覆盖率。
读懂区间承诺
2每模拟 100 次,具有 95% 覆盖率的区间方法都必须恰好命中 95 次。
3方差区间中,若卡方分位数满足 qL < qU,下限的分母应该用哪个?填写 qL 或 qU。
7. 练习:从概率事件得到区间
练习 1|配对目标。 六个独立对象的差值为 1,2,1,3,2,3。在差值正态模型下,计算平均差的 95% 区间;可用 t0.975,5=2.57058。
平均为 2,离差平方和为 4,SD2=4/5,标准误 2/15。区间为 ,约 。自由度来自 6 个独立差值;原始成对观测的相关性已通过差值处理。
练习 2|Welch 的近似来自哪里。 两组独立正态样本 n1=6,n2=10、样本方差 9,4,均值差为 3。求均值差标准误和近似自由度,写出 95% 区间公式,并解释为什么不是精确 。
V=9/6+4/10=1.9,标准误 1.9;自由度为 。区间为 。两组方差未假定相等,残差平方和不能抽出同一真实尺度相加成精确卡方。
练习 3|方差比的方向。 两独立正态样本的自由度为 4、8,观察方差比为 2。用 F4,8 的下侧分位数 f0.025,f0.975 写真实方差比及其倒数的 95% 区间。
方差比区间为 [2/f0.975,2/f0.025],倒数比区间为 [f。第一次是反解枢轴中的分母参数,第二次是对参数作单调递减变换,均要检查端点次序。
练习 4|等待时间的精确区间。 四次 iid 指数等待总和为 12 秒。已知 χ0.025,82≈2.17973、χ0.975,82≈,构造速率和平均等待的双侧 95% 区间。
速率区间为 [2.17973/24,17.53455/24]≈[0.09082,0.73061] 每秒。平均等待取倒数反序,约为 [1.3687,11.0105] 秒。两个区间描述同一个覆盖事件的不同参数化,不能互相混用单位。
练习 5|端点仍有不确定性。 15 次伯努利试验全部成功。推导单侧 95% 精确下界,以及双侧等尾 95% 下端;哪个更低,为什么?
观察全部成功的概率为 p15。单侧下界解 pL15=0.05,得 0.05;双侧下端解 ,约为 0.7820,上端为 1。双侧给每端更少错误预算,排除小参数的要求更严格,因此下端更低。
练习 6|一般二项反演。 12 次试验成功 3 次。写出等尾 95% 精确区间的两条尾方程;说明求下端时把成功数尾部写成 S≤3 会造成什么方向错误。
下端解 PpL(S≥3)=0.025,上端解 P。低参数受到挑战是因为观察的成功太多,应检查上尾;写成下尾会把排除方向倒转。可在 依据单调性二分求根,并回代核对尾概率。
练习 7|证明检验与集合对应。 每个点零假设都用水平至多 0.1 的检验,定义不拒绝的参数集合。证明其覆盖至少 90%;为什么集合不一定是一段连续区间?
真参数不在集合,当且仅当针对它的检验拒绝。概率至多 0.1,覆盖便至少是 0.9。但这段证明没有要求接受集合随参数单调。遇到多峰似然或多对一参数映射,保留值可能分成几段,要另外检查形状。
练习 8|把精度目标写成设计。 独立正态读数标准差已知为 3 秒,要求 99% 双侧均值区间半宽至多 0.4 秒。用 z0.995=2.57583 求充分的最小整数样本量,并说明不能用重复模拟次数代替它。
n≥(2.57583⋅3/0.4)2≈373.21,故取 374。这里 n 是每批真实独立观测数;模拟批次数只是使覆盖率的估计更稳定,不会减小一批区间的标准误。