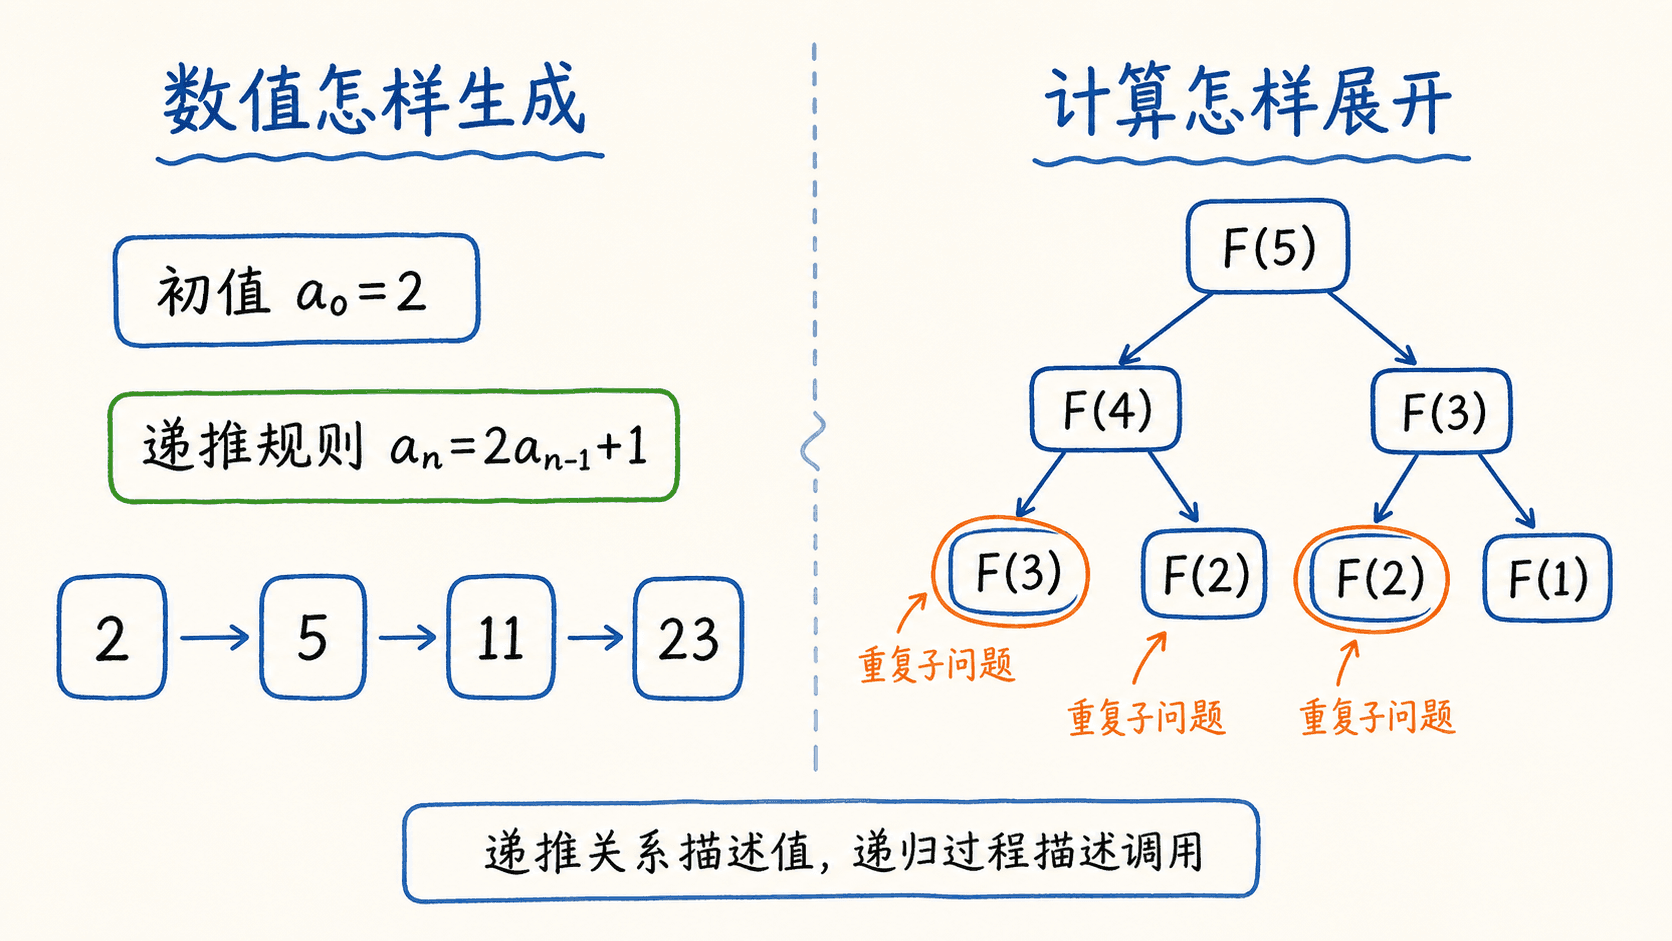
递推关系与递归过程
上一章用递归定义描述了对象怎样从基础情形一步步长出来。这一章把同一个想法往前推一步:如果我们关心的是“第 n n n n n n 递推关系 。
递推关系把一个大下标的值交给较小下标的值。它只说局部规则,却能确定整条序列。递归过程也会把大问题交给较小的问题,但它描述的是计算时发生了哪些调用。两者长得很像,回答的问题却不同:一个描述值,一个描述过程。
本章会从“递推式为什么必须配初值”开始,练习展开、猜测和归纳验证,再处理一阶与二阶线性递推。最后把递推关系放回递归算法,借调用树看清重复计算和增长速度。到章末,递推式还会自然地变成下一章计数问题的建模工具。
左边追踪数值怎样由前一项生成,右边追踪一次计算怎样拆成多个调用。公式相似,不代表过程相同。 一条递推定义怎样站稳
先看一个很短的定义:
a 0 = 2 , a n = 2 a n − 1 + 1 ( n ≥ 1 ) a_0=2,\qquad a_n=2a_{n-1}+1\quad(n\ge 1) a 0 = 2 , a n = 2 a n − 1 + 1 ( n ≥ 1 ) 从 a 0 a_0 a 0
a 1 = 5 , a 2 = 11 , a 3 = 23 , a 4 = 47 a_1=5,\quad a_2=11,\quad a_3=23,\quad a_4=47 a 1 = 5 , a 2 = 11 , a 3 这里有三个缺一不可的部分。
a n a_n a n n n n 初始条件告诉我们从哪里开始,例如 a 0 = 2 a_0=2 a 0 = 2
递推规则和适用范围告诉我们怎样继续,例如规则从 n = 1 n=1 n =
很多初学者只盯着中间那条公式,觉得 a n = 2 a n − 1 + 1 a_n=2a_{n-1}+1 a n = 2 a n − 1 + 1 a 0 a_0 a 0
下标范围是定义的一部分。若写 a n = 2 a n − 1 + 1 a_n=2a_{n-1}+1 a n = 2 a n − 1 + 1 n = 0 n=0
阶数决定需要多少初值
递推式的阶数 看的是它要回看多远。
a n = 3 a n − 1 − 2 a_n=3a_{n-1}-2 a n = 3 a n − 1 − 2 只回看一项,是一阶递推,通常给一个初值就够。
b n = b n − 1 + b n − 2 b_n=b_{n-1}+b_{n-2} b n = b n − 1 + b n − 2 要回看两项,是二阶递推,通常要给两个相邻初值。若只知道 b 0 b_0 b 0 b 2 b_2 b 2 b 1 b_1 b 1
“阶”与幂次没有关系。c n = ( c n − 1 ) 3 + 1 c_n=(c_{n-1})^3+1 c n = ( c n − 1 ) 3 + 1
基础情形为什么有时不符合第一眼直觉
定义长度为 n n n s n s_n s n n − 1 n-1 n − 1 0 0 0 1 1 1
s n = 2 s n − 1 ( n ≥ 1 ) s_n=2s_{n-1}\quad(n\ge 1) s n = 2 s n − 1 ( n ≥ 1 ) 这时最合适的初值不是 s 1 = 2 s_1=2 s 1 = 2
s 0 = 1 s_0=1 s 0 = 1 长度为 0 0 0 s n = 2 n s_n=2^n s n = 2 n
不合格的递归定义会发生什么
考虑
f ( n ) = 2 + f ( n − 1 ) f(n)=2+f(n-1) f ( n ) = 2 + f ( n − 1 ) 它没有基础情形,因此不能唯一确定 f f f 10 10 10
再看
g ( 0 ) = 0 , g ( n ) = g ( n + 1 ) ( n ≥ 1 ) g(0)=0,\qquad g(n)=g(n+1)\quad(n\ge 1) g ( 0 ) = 0 , g ( n ) = g ( n + 1 ) ( n ≥ 1 ) 它虽然写了基础情形,但递归调用朝着更大的下标走。为了求 g ( 1 ) g(1) g ( 1 ) g ( 2 ) g(2) g ( 2 ) g ( 2 ) g(2) g ( 2 ) g ( 3 ) g(3) g ( 3 ) g ( 0 ) g(0) g ( 0 )
“公式里出现自己”并不自动构成递归定义。还要检查:基础情形是否覆盖边界;每次依赖是否朝基础情形靠近;不同分支是否给出冲突的值。
先亲手生成几项
下面的工具处理一阶递推 a n = r a n − 1 + b a_n=ra_{n-1}+b a n = r a n − 1 + b
列出前几项不是证明,却是很好的体检。下标错一位、初值抄错、加号写成减号,通常会立刻暴露出来。它还能给闭式提供线索,但有限个已知项永远不能单独证明后面所有项的规律。
从递推式往回展开
现在考虑
a 0 = 1 , a n = 3 a n − 1 + 2 ( n ≥ 1 ) a_0=1,\qquad a_n=3a_{n-1}+2\quad(n\ge 1) a 0 = 1 , a n = 3 a n − 1 我们已经知道怎样向前算 a 1 , a 2 , a 3 a_1,a_2,a_3 a 1 , a 2 , a 3 n n n a n a_n
a n = 3 a n − 1 + 2 = 3 ( 3 a n − 2 + 2 ) + 2 = 3 2 a n − 2 + 2 ( 3 + 1 ) = 3 3 a n − 3 + 2 ( 3 2 + 3 + 1 ) \begin{aligned}
a_n
&=3a_{n-1}+2\\
&=3(3a_{n-2}+2)+2\\
&=3^2a_{n-2}+2(3+1)\\
&=3^3a_{n-3}+2(3^2+3+1)
\end{aligned} a n 先别急着把数字全算完。保留 3 2 , 3 3 3^2,3^3 3 2 , 3 3 k k k
a n = 3 k a n − k + 2 ( 1 + 3 + ⋯ + 3 k − 1 ) a_n=3^k a_{n-k}+2(1+3+\cdots+3^{k-1}) a n = 3 k a n − k + 2 ( 1 当 k = n k=n k = n 0 0 0
a n = 3 n a 0 + 2 ( 1 + 3 + ⋯ + 3 n − 1 ) a_n=3^n a_0+2(1+3+\cdots+3^{n-1}) a n = 3 n a 0 + 2 ( 1 + 3 利用等比和并代入 a 0 = 1 a_0=1 a 0 = 1
a n = 3 n + 2 3 n − 1 3 − 1 = 2 ⋅ 3 n − 1 a_n=3^n+2\frac{3^n-1}{3-1}=2\cdot3^n-1 a n = 3 n + 2 3 − 1 3 这就是从递推定义得到的闭式。闭式不再引用前面的项,可以直接计算第 n n n
展开法其实藏着一次归纳
上面写出“展开 k k k
a n = 3 k a n − k + 2 ( 1 + 3 + ⋯ + 3 k − 1 ) a_n=3^k a_{n-k}+2(1+3+\cdots+3^{k-1}) a n = 3 k a n − k + 2 ( 1 那么再展开一层,a n − k = 3 a n − k − 1 + 2 a_{n-k}=3a_{n-k-1}+2 a n − k = 3 a n − k − 1 + 2
a n = 3 k ( 3 a n − k − 1 + 2 ) + 2 ( 1 + 3 + ⋯ + 3 k − 1 ) = 3 k + 1 a n − ( k + 1 ) + 2 ( 1 + 3 + ⋯ + 3 k ) \begin{aligned}
a_n
&=3^k(3a_{n-k-1}+2)+2(1+3+\cdots+3^{k-1})\\
&=3^{k+1}a_{n-(k+1)}+2(1+3+\cdots+3^k)
\end{aligned} a n 形式完全相同,只是 k k k k + 1 k+1 k + 1 k = 1 k=1 k = 1
一个可复用的展开流程
设
x 0 = 4 , x n = 5 x n − 1 − 8 ( n ≥ 1 ) x_0=4,\qquad x_n=5x_{n-1}-8\quad(n\ge1) x 0 = 4 , x n = 5 x n − 1 我们完整走一次。
先只展开两三层,不急着化成最终数字:
x n = 5 2 x n − 2 − 8 ( 5 + 1 ) x_n=5^2x_{n-2}-8(5+1) x n = 5 2 x n 展开时最有用的习惯是“适度整理”:把同类项收在一起,让幂次、下标和累加范围显出来;不要太早把结构算成一串数字。
猜到闭式以后怎样证明
观察与展开负责找到候选公式,归纳法负责确认它对所有下标成立。两者分工不同。只写“前五项符合,所以公式成立”不是证明;只写一段归纳推导却不解释公式从哪来,也会让读者不知道该怎样独立解题。
对递推定义验证闭式,一般检查两件事:
候选闭式给出的初始值是否正确。
假设较早项符合闭式,代入原递推式后,新项是否也符合闭式。
例题:验证一个一阶闭式
已知
a 0 = 2 , a n = 2 a n − 1 + 1 ( n ≥ 1 ) a_0=2,\qquad a_n=2a_{n-1}+1\quad(n\ge1) a 0 = 2 , a n = 2 a n − 1 由前几项和展开可以猜出
a n = 3 ⋅ 2 n − 1 a_n=3\cdot2^n-1 a n = 3 ⋅ 2 n − 1 现在证明它。
检查基础情形。当 n = 0 n=0 n = 0
3 ⋅ 2 0 − 1 = 2 = a 0 3\cdot2^0-1=2=a_0 3 ⋅ 2 0 − 1 = 2 这个证明有一个很实用的阅读方法:盯住等号链的第一行。它必须来自原递推式。若证明直接从 3 ⋅ 2 k + 1 − 1 3\cdot2^{k+1}-1 3 ⋅ 2 k + 1 − 1 a k + 1 = 2 a k + 1 a_{k+1}=2a_k+1 a k + 1 = 2 a
二阶闭式要验证两个基础情形
若递推式依赖前两项,归纳步骤会同时使用两个较早下标。对应地,闭式验证通常要先检查两个基础情形,再用强归纳,或使用“同时假设 P ( k ) P(k) P ( k ) P ( k − 1 ) P(k-1) P ( k − 1 )
验证二阶递推时只检查 n = 0 n=0 n = 0 n = 2 n=2 n = 2 a 1 a_1 a 1 a 0 a_0
一阶线性递推:旧量乘一下再加一点
最常见的一阶线性递推是
a n = r a n − 1 + b ( n ≥ 1 ) a_n=ra_{n-1}+b\quad(n\ge1) a n = r a n − 1 + b ( n ≥ 1 ) 它描述的过程很直白:旧量先乘以 r r r b b b
连续展开会得到
a n = r n a 0 + b ( 1 + r + r 2 + ⋯ + r n − 1 ) a_n=r^n a_0+b(1+r+r^2+\cdots+r^{n-1}) a n = r n a 0 + b ( 1 + 当 r ≠ 1 r\ne1 r = 1
a n = r n a 0 + b r n − 1 r − 1 a_n=r^n a_0+b\frac{r^n-1}{r-1} a n = r n a 0 + b r 当 r = 1 r=1 r = 1 b b b
a n = a 0 + n b a_n=a_0+nb a n = a 0 + nb 这个分情况不能省。把 r = 1 r=1 r = 1 r − 1 r-1 r − 1 0 / 0 0/0 0/0
固定点视角:为什么有些序列会稳定下来
设存在一个值 L L L
L = r L + b L=rL+b L = r L + b 当 r ≠ 1 r\ne1 r = 1
L = b 1 − r L=\frac{b}{1-r} L = 1 − r b 把递推式两边都减去 L L L
a n − L = r ( a n − 1 − L ) a_n-L=r(a_{n-1}-L) a n − L = r ( a n − 1 − L ) 这句话比原式更能说明长期行为:序列与固定点的距离,每一步都乘以 r r r
a n − L = r n ( a 0 − L ) a_n-L=r^n(a_0-L) a n − L = r n ( a 0 − L )
若 ∣ r ∣ < 1 |r|\lt1 ∣ r ∣ < 1 L L L
若 ∣ r ∣ > 1 |r|\gt1 ∣ r ∣ > 1 L L L
若 r < 0 r\lt0 r <
所以闭式不只是为了算第 n n n
用交互对照递推计算与闭式计算
调整参数后,下面的工具会同时用逐项递推和闭式计算。两列结果应该一致。尤其可以试试 r = 1 r=1 r = 1 r = 0 r=0 r = 0 r r r
用变量平移处理常数项
对于
a n = 3 a n − 1 + 2 a_n=3a_{n-1}+2 a n = 3 a n − 1 + 2 固定点满足 L = 3 L + 2 L=3L+2 L = 3 L + 2 L = − 1 L=-1 L = − 1
u n = a n − ( − 1 ) = a n + 1 u_n=a_n-(-1)=a_n+1 u n = a n − ( − 1 ) = a n 则
u n = 3 u n − 1 u_n=3u_{n-1} u n = 3 u n − 1 常数项消失了,问题变成等比递推。若 a 0 = 1 a_0=1 a 0 = 1 u 0 = 2 u_0=2 u 0 = 2
u n = 2 ⋅ 3 n , a n = 2 ⋅ 3 n − 1 u_n=2\cdot3^n,\qquad a_n=2\cdot3^n-1 u n = 2 ⋅ 3 n , a n = 2 ⋅ 展开法是在追踪每一步加入的常数;平移法是在寻找一个不会移动的中心。两种方法得到同一个闭式,却展示了不同的结构。
二阶常系数递推:为什么会出现特征根
二阶齐次常系数递推的一般形式是
a n = p a n − 1 + q a n − 2 ( n ≥ 2 ) , q ≠ 0 a_n=pa_{n-1}+qa_{n-2}\quad(n\ge2),\qquad q\ne0 a n = p a n − 1 + q a n “二阶”表示要记住前两项,所以最高滞后项 a n − 2 a_{n-2} a n − 2 q q q q = 0 q=0 q = 0 p , q p,q p , q n n
直接展开二阶递推,分支会越来越多。更整齐的想法是先问:有没有一种序列,向后移动一位时只差一个固定倍数?指数序列 a n = λ n a_n=\lambda^n a n = λ n
把它代入递推式:
λ n = p λ n − 1 + q λ n − 2 \lambda^n=p\lambda^{n-1}+q\lambda^{n-2} λ n = p λ n − 1 + q λ n − 2 除以 λ n − 2 \lambda^{n-2} λ n − 2
λ 2 − p λ − q = 0 \lambda^2-p\lambda-q=0 λ 2 − p λ − q = 0 这叫特征方程。它把“下标移动”的问题变成了一个代数方程。
两个不同特征根
若特征方程有两个不同根 λ 1 , λ 2 \lambda_1,\lambda_2 λ 1 , λ 2
a n = A λ 1 n + B λ 2 n a_n=A\lambda_1^n+B\lambda_2^n a n = A λ 1 n + B λ 2 n 会满足递推式。两个初始条件用来确定 A , B A,B A , B
看一个算得干净的例子:
a 0 = 2 , a 1 = 3 , a n = 3 a n − 1 − 2 a n − 2 ( n ≥ 2 ) a_0=2,\qquad a_1=3,\qquad a_n=3a_{n-1}-2a_{n-2}\quad(n\ge2) a 0 = 2 , a 1 = 3 , a 特征方程为
λ 2 − 3 λ + 2 = 0 \lambda^2-3\lambda+2=0 λ 2 − 3 λ + 2 = 0 两个根是 1 1 1 2 2 2
a n = A + B 2 n a_n=A+B2^n a n = A + B 2 n 再代入两个初值:
A + B = 2 , A + 2 B = 3 A+B=2,\qquad A+2B=3 A + B = 2 , A + 2 B = 3 解得 A = B = 1 A=B=1 A = B = 1
a n = 1 + 2 n a_n=1+2^n a n = 1 + 2 n 它生成 2 , 3 , 5 , 9 , 17 , … 2,3,5,9,17,\ldots 2 , 3 , 5 , 9 , 17 , …
重根为什么多出一个 n n n
若特征方程只有一个二重根 λ \lambda λ A λ n + B λ n A\lambda^n+B\lambda^n A λ n + B λ n n λ n n\lambda^n n λ n
a n = ( A + B n ) λ n a_n=(A+Bn)\lambda^n a n = ( A + B n ) λ n 在本课程里,先理解“二阶需要两种独立形状”就够了。以后处理更高阶递推时,同样会看到:不同根贡献不同指数项;根若重复,就会额外乘上 n , n 2 n,n^2 n , n 2
斐波那契递推揭示了什么
斐波那契数列定义为
F 0 = 0 , F 1 = 1 , F n = F n − 1 + F n − 2 ( n ≥ 2 ) F_0=0,\qquad F_1=1,\qquad F_n=F_{n-1}+F_{n-2}\quad(n\ge2) F 0 = 0 , F 1 = 1 , F 它的特征方程是
λ 2 − λ − 1 = 0 \lambda^2-\lambda-1=0 λ 2 − λ − 1 = 0 两个根为
λ 1 = 1 + 5 2 , λ 2 = 1 − 5 2 \lambda_1=\frac{1+\sqrt5}{2},\qquad
\lambda_2=\frac{1-\sqrt5}{2} λ 1 = 2 1 + 5 因此 F n F_n F n 1 1 1 1 1 1
特征根法求的是满足递推式的函数形状,初值负责从这些形状中选出唯一一条序列。先求根、后代初值,这个顺序不要颠倒。
递推关系和递归过程不是一回事
斐波那契递推式定义的是一列数:
F n = F n − 1 + F n − 2 F_n=F_{n-1}+F_{n-2} F n = F n − 1 + F n − 2 它没有规定计算机必须怎样求 F n F_n F n
直接递归
最直译的过程是:求 F ( n ) F(n) F ( n ) F ( n − 1 ) F(n-1) F ( n − 1 ) F ( n − 2 ) F(n-2) F ( n − 2 ) n = 0 n=0 n = 0
求 F ( 5 ) F(5) F ( 5 ) F ( 4 ) F(4) F ( 4 ) F ( 3 ) F(3) F ( 3 ) F ( 4 ) F(4) F ( 4 ) F ( 3 ) F(3) F ( 3 )
下面的调用树可以切换 n n n F ( k ) F(k) F ( k )
记忆化递归
记忆化仍从 F ( n ) F(n) F ( n ) F ( k ) F(k) F ( k ) k k k
对于 F ( n ) F(n) F ( n )
F ( 0 ) , F ( 1 ) , … , F ( n ) F(0),F(1),\ldots,F(n) F ( 0 ) , F ( 1 ) , … , F ( n ) 共 n + 1 n+1 n + 1
自底向上
也可以完全不展开调用树。从 F 0 , F 1 F_0,F_1 F 0 , F 1 F 2 , F 3 , … , F n F_2,F_3,\ldots,F_n F 2 , F
递归定义不等于低效程序,递归程序也不必低效。判断效率时要看实际调用有没有重复、子问题规模是否变小、结果是否被复用,而不是只看代码里有没有“调用自己”。
调用树的节点数也是一条递推
设直接递归计算 F ( n ) F(n) F ( n ) C n C_n C n F ( 0 ) , F ( 1 ) F(0),F(1) F ( 0 ) , F ( 1 )
C 0 = C 1 = 1 C_0=C_1=1 C 0 = C 1 = 1 当 n ≥ 2 n\ge2 n ≥ 2
C n = C n − 1 + C n − 2 + 1 C_n=C_{n-1}+C_{n-2}+1 C n = C n − 1 + C n − 2 这条递推和斐波那契递推几乎一样,因此 C n C_n C n
C n = 2 F n + 1 − 1 C_n=2F_{n+1}-1 C n = 2 F n + 1 − 1 而记忆化或自底向上只处理 n + 1 n+1 n + 1 n n n
用递推式分析递归过程的工作量
若算法处理规模 n n n n − 1 n-1 n − 1 n n n
T ( n ) = T ( n − 1 ) + n ( n ≥ 1 ) , T ( 0 ) = c T(n)=T(n-1)+n\quad(n\ge1),\qquad T(0)=c T ( n ) = T ( n − 1 ) + n ( n ≥ 1 ) , T ( 0 ) = c 其中 c c c
展开得到
T ( n ) = T ( 0 ) + 1 + 2 + ⋯ + n T(n)=T(0)+1+2+\cdots+n T ( n ) = T ( 0 ) + 1 + 2 + ⋯ + n 而
1 + 2 + ⋯ + n = n ( n + 1 ) 2 1+2+\cdots+n=\frac{n(n+1)}{2} 1 + 2 + ⋯ + n = 2 n ( n + 1 ) 所以工作量按 n 2 n^2 n 2
汉诺塔:递归结构怎样变成精确递推
有三根柱子和 n n n H n H_n H n
为了移动最大的圆盘,必须先把上面的 n − 1 n-1 n − 1 n − 1 n-1 n − 1
H n ≤ H n − 1 + 1 + H n − 1 H_n\le H_{n-1}+1+H_{n-1} H n ≤ H n − 1 + 1 + H n 另一方面,任何合法过程在移动最大圆盘前,都必须挪开全部 n − 1 n-1 n − 1 H n − 1 H_{n-1} H n − 1
H n ≥ 2 H n − 1 + 1 H_n\ge2H_{n-1}+1 H n ≥ 2 H n − 1 + 1 上下界相遇,得到精确递推:
H 0 = 0 , H n = 2 H n − 1 + 1 ( n ≥ 1 ) H_0=0,\qquad H_n=2H_{n-1}+1\quad(n\ge1) H 0 = 0 , H n = 2 H n 展开:
H n = 2 n H 0 + ( 1 + 2 + ⋯ + 2 n − 1 ) = 2 n − 1 H_n=2^nH_0+(1+2+\cdots+2^{n-1})=2^n-1 H n = 2 n H 0 + ( 1 + 这段推理比单纯算出公式更重要。写算法只给了“至多需要多少步”;再证明任何算法都不可能更少,才得到“最少步数”的等号。
分成两个一半:为什么会出现 n log n n\log n n log n
设一个过程把规模 n n n n / 2 n/2 n /2 n n n
T ( n ) = 2 T ( n / 2 ) + n ( n ≥ 2 ) , T ( 1 ) = c T(n)=2T(n/2)+n\quad(n\ge2),\qquad T(1)=c T ( n ) = 2 T ( n /2 ) + n ( n ≥ 2 ) , T ( 1 ) = c 其中 n n n 2 2 2 c c c
调用树第 0 0 0 n n n n n n 1 1 1 n / 2 n/2 n /2
2 ⋅ n 2 = n 2\cdot\frac n2=n 2 ⋅ 2 n = n 第 2 2 2 n / 4 n/4 n /4 n n n n n n 2 2 2 log 2 n \log_2 n log 2 n
T ( n ) = Θ ( n log n ) T(n)=\Theta(n\log n) T ( n ) = Θ ( n log n ) 这里比较的是渐近增长量级:忽略固定倍数和较低阶项后,3 n 2 + 100 n + 7 3n^2+100n+7 3 n 2 + 100 n + 7 n 2 n^2 n 2 Θ ( n 2 ) \Theta(n^2) Θ ( n
读递归树时检查四件事
每个节点代表什么?它可能代表一次函数调用,也可能代表一个尚待解决的子问题。先把含义说清,才不会把节点值与节点成本混在一起。
一个节点会生出几个孩子,每个孩子的规模是多少?这决定递推式里有几个 T ( ⋅ ) T(\cdot) T ( ⋅ )
除了子调用,当前节点还做多少工作?比较、复制、合并或一次移动,都要单独写进递推式。
递推式也能从计数问题里长出来
下一章要系统学习加法原理、乘法原理、排列与组合。这里先看一个过渡问题:每次可以走 1 1 1 2 2 2 n n n
设答案为 w n w_n w n 最后一步 分类。
最后走 1 1 1 n − 1 n-1 n − 1 w n − 1 w_{n-1} w n − 1
最后走 2 2 2 n − 2 n-2 n −
两类互不重叠,所以
w n = w n − 1 + w n − 2 ( n ≥ 2 ) w_n=w_{n-1}+w_{n-2}\quad(n\ge2) w n = w n − 1 + w n − 2 边界也要仔细定。走完 0 0 0
w 0 = 1 , w 1 = 1 w_0=1,\qquad w_1=1 w 0 = 1 , w 1 = 1 于是
1 , 1 , 2 , 3 , 5 , 8 , … 1,1,2,3,5,8,\ldots 1 , 1 , 2 , 3 , 5 , 8 , … 又出现了斐波那契型递推。它不是因为台阶长得像兔子,而是因为“最后一步”恰好把所有结果分成两个互斥类别,并分别与更小问题一一对应。
建立计数递推时,最关键的不是先猜公式,而是找到一个不会重复也不会遗漏的分类标准。按第一步、最后一步、是否包含某个指定元素分类,都是常见入口。
从模型到解答的完整检查
明确定义 a n a_n a n a n a_n a n n n n
章末练习
基础题
已知 a 0 = 3 a_0=3 a 0 = 3 a n = 2 a n − 1 − 1 ( n ≥ 1 ) a_n=2a_{n-1}-1\ (n\ge1) a n = 2 a n
查看参考解 前五项是 3 , 5 , 9 , 17 , 33 3,5,9,17,33 3 , 5 , 9 , 17 , 33 a n − 1 a_n-1 a n − 1 2 , 4 , 8 , 16 , 32 2,4,8,16,32 2 , 4 , 8 ,
递推式 b n = 4 b n − 1 + 3 ( n ≥ 1 ) b_n=4b_{n-1}+3\ (n\ge1) b n = 4 b n − 1 + 3 ( n ≥ 1 ) b 0 = 2 b_0=2
查看参考解 没有初值时不能唯一确定,因为任取 b 0 b_0 b 0 b 0 = 2 b_0=2 b 0 = 2 b n = 4 n b 0 + 3 ( 1 + 4 + ⋯ + 4 n − 1 ) = 2 ⋅ 4 n + ( 4 n − 1 ) = 3 ⋅
设 c 0 = 7 c_0=7 c 0 = 7 c n = 0.6 c n − 1 + 8 ( n ≥ 1 ) c_n=0.6c_{n-1}+8\ (n\ge1) c n = 0.6 c
查看参考解 固定点满足 L = 0.6 L + 8 L=0.6L+8 L = 0.6 L + 8 L = 20 L=20 L = 20 c n − 20 = 0.6 ( c n − 1 − 20 ) c_n-20=0.6(c_{n-1}-20) c n − 20
方法题
已知
d 0 = 1 , d 1 = 4 , d n = 5 d n − 1 − 6 d n − 2 ( n ≥ 2 ) d_0=1,\qquad d_1=4,\qquad d_n=5d_{n-1}-6d_{n-2}\quad(n\ge2) d 0 = 1 , d 1 = 4 , d 用特征根法求闭式。
查看参考解 特征方程是 λ 2 − 5 λ + 6 = 0 \lambda^2-5\lambda+6=0 λ 2 − 5 λ + 6 = 0 2 , 3 2,3 2 , 3 d n = A 2 n + B 3 n d_n=A2^n+B3^n d
汉诺塔递推 H 0 = 0 H_0=0 H 0 = 0 H n = 2 H n − 1 + 1 H_n=2H_{n-1}+1 H n = 2 H n
查看参考解 递归过程只证明存在一个使用 2 H n − 1 + 1 2H_{n-1}+1 2 H n − 1 + 1 n − 1 n-1 n − 1 2 H n − 1 + 1 2H_{n-1}+1 2 H
直接递归计算斐波那契数的调用次数满足 C 0 = C 1 = 1 C_0=C_1=1 C 0 = C 1 = 1 C n = C n − 1 + C n − 2 + 1 C_n=C_{n-1}+C_{n-2}+1 C
查看参考解 C 2 = 3 C_2=3 C 2 = 3 C 3 = 5 C_3=5 C 3 = 5 C 4 = 9 C_4=9 C
建模题
长度为 n n n 1 1 1 s n s_n s n
查看参考解 按最后一位分类。若最后一位是 0 0 0 n − 1 n-1 n − 1 s n − 1 s_{n-1} s n − 1 1 1 1 0 0 0
一个过程满足 T ( 1 ) = 1 T(1)=1 T ( 1 ) = 1 T ( n ) = 2 T ( n / 2 ) + n T(n)=2T(n/2)+n T ( n ) = 2 T ( n /2 ) + n n n n 2 2 2
查看参考解 第 i i i 2 i 2^i 2 i n / 2 i n/2^i n / 2 i 2 i ⋅ ( n / 2 i ) = n 2^i\cdot(n/2^i)=n 2 i
本章把上一章的递归定义变成了可以计算、可以求闭式、也可以分析工作量的语言。看到递推式时,先问起点和依赖是否完整;想求第 n n n