生成函数与离散概率前奏
前面几章一直在追问同一件事:一个集合里到底有多少个对象。加法原理负责分情况,乘法原理负责分步骤,排列组合、容斥和鸽巢原理则处理更具体的结构。到了这一章,我们不再满足于只算出某一个数字,而是想把一整列答案一起保存下来。
比如,规模为 0 的对象有 a0 个,规模为 1 的有 a1 个,规模为 2 的有 a2 个。你当然可以把它们写成表格,但表格本身不太会“计算”。生成函数做的事,是把这列数装进一个幂级数,让代数运算替我们完成组合、分类和递推。
本章后半段再把计数接到离散概率。这个衔接其实很自然:如果有限样本空间中的结果等可能,那么事件概率就是“事件里的结果数”除以“全部结果数”。前半章学会数,后半章学会把数出来的结果解释成概率。
先说清楚:把序列装进幂级数
设我们有一个序列
a0,a1,a2,a3,
它的普通生成函数定义为
A(x)=a0+a1x+a
第一次看到这个定义时,很容易把注意力放在 x 上:要给 x 代什么数?这个函数的图像长什么样?先别急。这一章里,x 的主要工作不是取值,而是给序列的位置贴标签。
- x0 的系数记录第 0 项 a0。
- x1 的系数记录第 项 。
所以,“把序列装进幂级数”并没有丢掉任何信息。原序列可以从生成函数逐项读回来,生成函数也可以由原序列唯一写出。我们只是把一张纵向的计数表,换成了一个适合做代数运算的横向表达式。
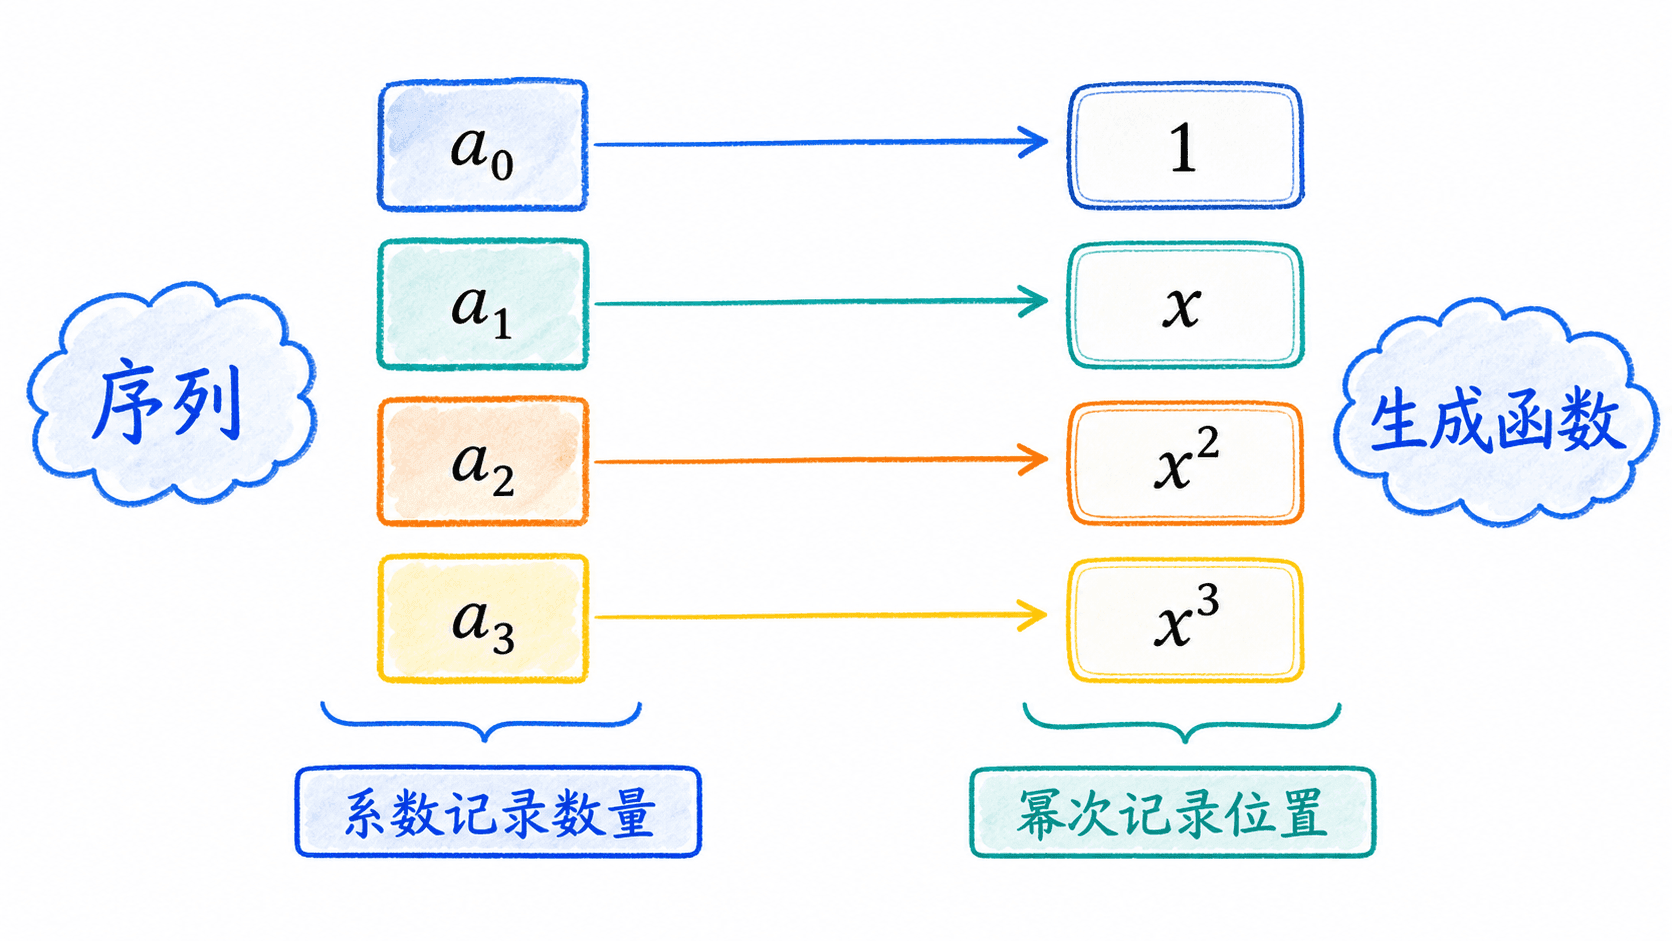 幂次是位置标签,系数才是这一位置保存的数。
从具体序列开始读
长度为 n 的二进制字符串有 2n 个,因此计数序列是
1,2,4,8,16,…
对应的生成函数是
B(x)=1+2x+4x2+8x3+16x
x3 前面的系数是 8,它说的是“长度为 3 的二进制字符串有 8 个”。指数 3 是规模,系数 8 是数量。生成函数题里最常见的第一类错误,就是把这两个角色看反。
同一个代数式可以保存不同含义
生成函数只负责保存序列,至于序列数的是什么,要由题目说明。例如
1+x+x2+x3+⋯
既可以表示“某种硬币可取 0,1,2,3,… 枚,每个数量各有一种取法”,也可以表示“每个规模恰好有一个对象”。代数式相同,不代表被计数的对象相同。
这点很像一个没有列名的表格:数据还在,但语义来自上下文。写生成函数时,最好先用一句话说清楚“幂次记录什么,系数记录什么”,后面的式子才不会漂在空中。
本章只讲普通生成函数。以后还会遇到指数生成函数等其他工具,它们给系数加了不同的权重,适合处理不同类型的组合对象。这里出现“生成函数”时,都指普通生成函数。
系数提取与基本操作
为了准确表达“取出 xn 前面的系数”,我们使用记号
[xn]A(x)
读作“A(x) 中 xn 的系数”。按照定义,若
A(x)=n≥0∑anxn,
那么
[xn]A(x)=an.
例如
C(x)=4−2x+7x3,
则
[x0]C(x)=4,[x1]C(x
没有出现的 x2 项,不是“没有答案”,而是系数为 0。为了让式子简洁,我们通常省略零系数项。
加法:同一规模直接合并
若
A(x)=n≥0∑anx
那么
[xn](A(x)+B(x))=an+b
计数上,这对应加法原理。若规模为 n 的对象分成互不重叠的两类,第一类有 an 个,第二类有 bn 个,总数就是 a。
常数倍:每个对象带上固定数量的选择
对常数 c,有
[xn](cA(x))=c[xn]A(x)=ca
如果每个原对象都能再染成 c 种颜色,这个常数倍就有直接的计数含义。
乘上 xk:把序列向后移动
把 A(x) 乘上 x:
xA(x)=a0x+a1x2+
原来 xn 位置的系数被移到了 xn+1。更一般地,
[xn]xkA(x)={
这个“平移”动作正是生成函数能处理递推的原因。递推式里的 an−1、an−2,会在生成函数里变成 xA(x)、。
几何级数:最常用的零件
令
G(x)=1+x+x2+x3+⋯
把它乘以 x 再相减:
G(x)−xG(x)=1.
因此
(1−x)G(x)=1,
也就得到
G(x)=1−x1.
这里的关键不是把某个数代入 x,而是验证两边逐项相乘后,常数项为 1,其余每个系数都为 0。形式幂级数的严格边界会在后面说明。
乘法为什么等于卷积
生成函数真正开始发挥作用,是在两个系列相乘的时候。设
A(x)=a0+a1x+a2
和
B(x)=b0+b1x+b
想知道乘积中 xn 的系数,就要找出所有指数和为 n 的乘积项。第一项可以取 a0x0,第二项就必须取 b;第一项也可以取 ,第二项取 。一直列到 与 ,得到
[xn]A(x)B(x)=i=0∑na
也就是
[xn]A(x)B(x)=a0bn
这串和叫作两个系数序列的卷积。名字听起来新,背后的动作其实就是乘法原理加分类讨论。
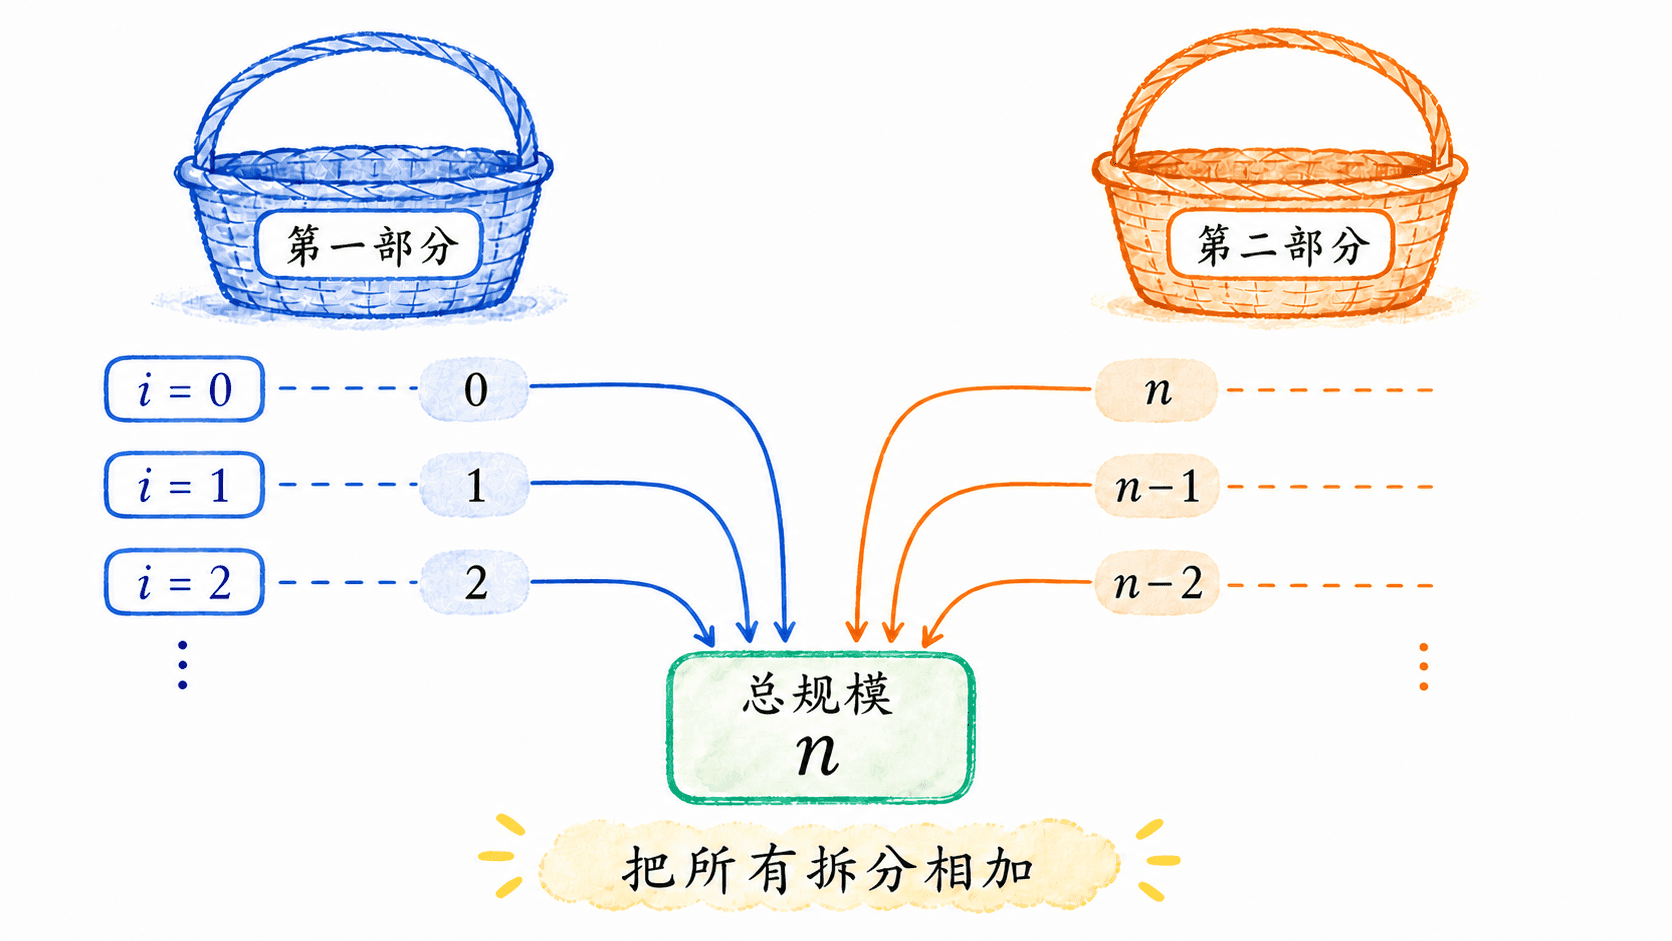 固定总规模 n 后,把所有 i+(n−i)=n 的拆分都加起来。
为什么计数上必须把所有拆分相加
假设第一类对象中,规模为 i 的有 ai 个;第二类对象中,规模为 j 的有 bj 个。要组成总规模为 n 的一对对象,规模可能拆成
0+n, 1+(n−1), 2+(n−2), …, n+
当拆分固定为 i+(n−i) 时,乘法原理告诉我们有
aibn−i
种配对。不同的 i 给出互不重叠的情况,再用加法原理相加,正好得到卷积公式。
一个小例子:两类物品共选 3 个
假设红色物品可选 0,1,2 个,每种数量各有一种取法,对应
R(x)=1+x+x2.
蓝色物品可选 0,1,2,3 个,每种数量各有一种取法,对应
B(x)=1+x+x2+x3.
总共选 3 个的方式数是
[x3]R(x)B(x).
规模 3 可以拆成
0+3,1+2,2+1.
每种拆分各有一种,所以答案是 3。注意没有 3+0,因为红色物品最多只能选 2 个;代数上,R(x) 中 x3 的系数就是 。
看到生成函数乘法时,可以在脑中翻译成一句话:从每个因子里挑一项,指数相加记录总规模,同次幂的项合并记录所有达到这个总规模的方式。
把选择限制翻译成因子
实际题目通常不会只说“随便选”。它会附带偶数、倍数、上限、至多一个之类的限制。生成函数的好处是,每个限制都能先写成一个小因子,再把因子相乘。
设某类物品每种允许数量只有一种取法,常见翻译如下:
这里常数项 1 很重要。它通常表示“这一类一个也不选”有一种方式。忘掉常数项,就等于偷偷把“必须选至少一个”加进了题目。
例子:四种限制同时出现
假设一袋水果满足:苹果只能取偶数个,香蕉只能取 5 的倍数个,橘子至多取 4 个,梨至多取 1 个。若幂次记录水果总数,那么四个因子分别是
A(x)=1+x2+x4+x6+
B(x)=1+x5+x10+x15
O(x)=1+x+x2+x3+x
P(x)=1+x.
总生成函数是
F(x)=A(x)B(x)O(x)P(x).
装入恰好 n 个水果的方案数就是
[xn]F(x).
这一步最容易被误解成“写出乘积就做完了”。其实写出乘积只是建模完成;题目若要具体数字,还要继续提取目标系数。对小的 n,可以截断后展开;对一般的 n,则可能要化简、递推或使用其他代数方法。
为什么可以安全截断
若只想求 [x10]F(x),每个因子中次数高于 10 的项都不可能参与 x10 的形成。所有指数都非负时,可以把每个无限级数截到 x:
1+x2+x4+⋯
可暂时改写成
1+x2+x4+x6+x
这不是近似。对于目标系数 [x10] 来说,被删掉的高次项贡献严格为零。
硬币问题:系数就是答案
硬币问题特别适合练习“限制变因子”。假设有不限数量的 1 元、2 元和 5 元硬币,问凑出 n 元有多少种组合。这里不区分摆放顺序,所以 1+1+5 和 5+ 是同一种组合。
1 元硬币可取 0,1,2,… 枚,对应
1+x+x2+x3+⋯.
2 元硬币对总金额的贡献只能是 0,2,4,…,对应
1+x2+x4+x6+⋯.
5 元硬币对应
1+x5+x10+x15+⋯.
因此总生成函数是
C(x)=(1+x+x2+⋯)(1
凑出 n 元的组合数是
[xn]C(x).
也可以用几何级数把它写成更紧凑的形式:
C(x)=(1−x)(1−x2)(1−x5
例题:凑出 7 元
我们不急着机械展开,先让思路露出来。5 元硬币最多用一枚,所以可以按 5 元硬币的数量分类。
不用 5 元硬币时,要解 a+2b=7,其中 a,b 分别是 1 元和 元硬币的枚数。 可以取 ,每个 都唯一决定 ,所以有 种。
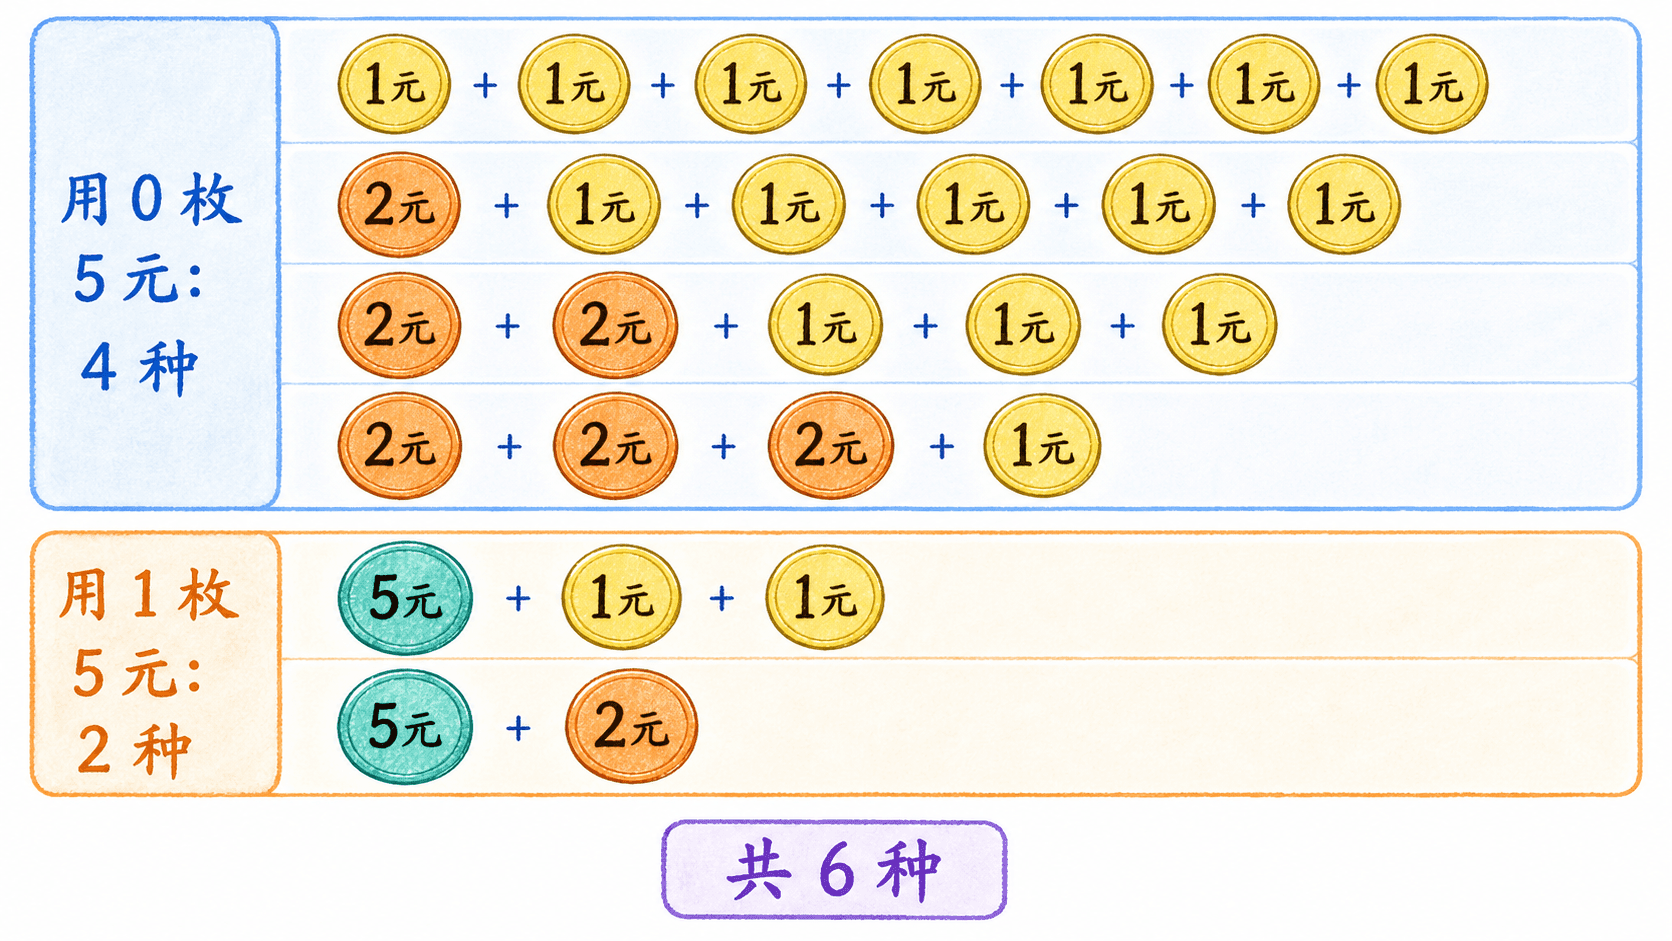 按 5 元硬币的枚数分类,可以直接看见 4+2=6 种组合。
这个生成函数数的是无序组合。若题目把投币顺序看成不同过程,例如先投 2 元再投 5 元与先投 5 元再投 2 元算两个结果,就需要建立另一个模型,不能直接沿用这里的三个独立因子。
有标签选择:子集与骰子
前面的硬币彼此同类,只关心每种面值用了几枚。现在看两种“位置或步骤可以区分”的问题,生成函数仍然适用,只是因子的含义变了。
从 m 个不同元素中选子集
对每一个元素,都有“不选”和“选”两种决定。若用 x 的指数记录选中了几个元素,那么一个元素对应因子
1+x.
m 个不同元素分别作决定,总生成函数就是
(1+x)m.
从 m 个元素中选出恰好 k 个的方案数,因此是
[xk](1+x)m=(km).
这里每个因子都代表一个有身份的元素。即使因子长得相同,它们仍对应不同位置,所以展开时自动保留了“选的是哪几个元素”的区别。
两枚骰子的点数和
一枚普通骰子的点数生成函数是
D(x)=x+x2+x3+x4
掷两枚可以区分的骰子时,第一枚和第二枚各贡献一个点数,所以总点数的生成函数是
D(x)2.
[x7]D(x)2 数的是有序结果
(1,6),(2,5),(3,4),(4,3),(5,2),(6,1),
因此
[x7]D(x)2=6.
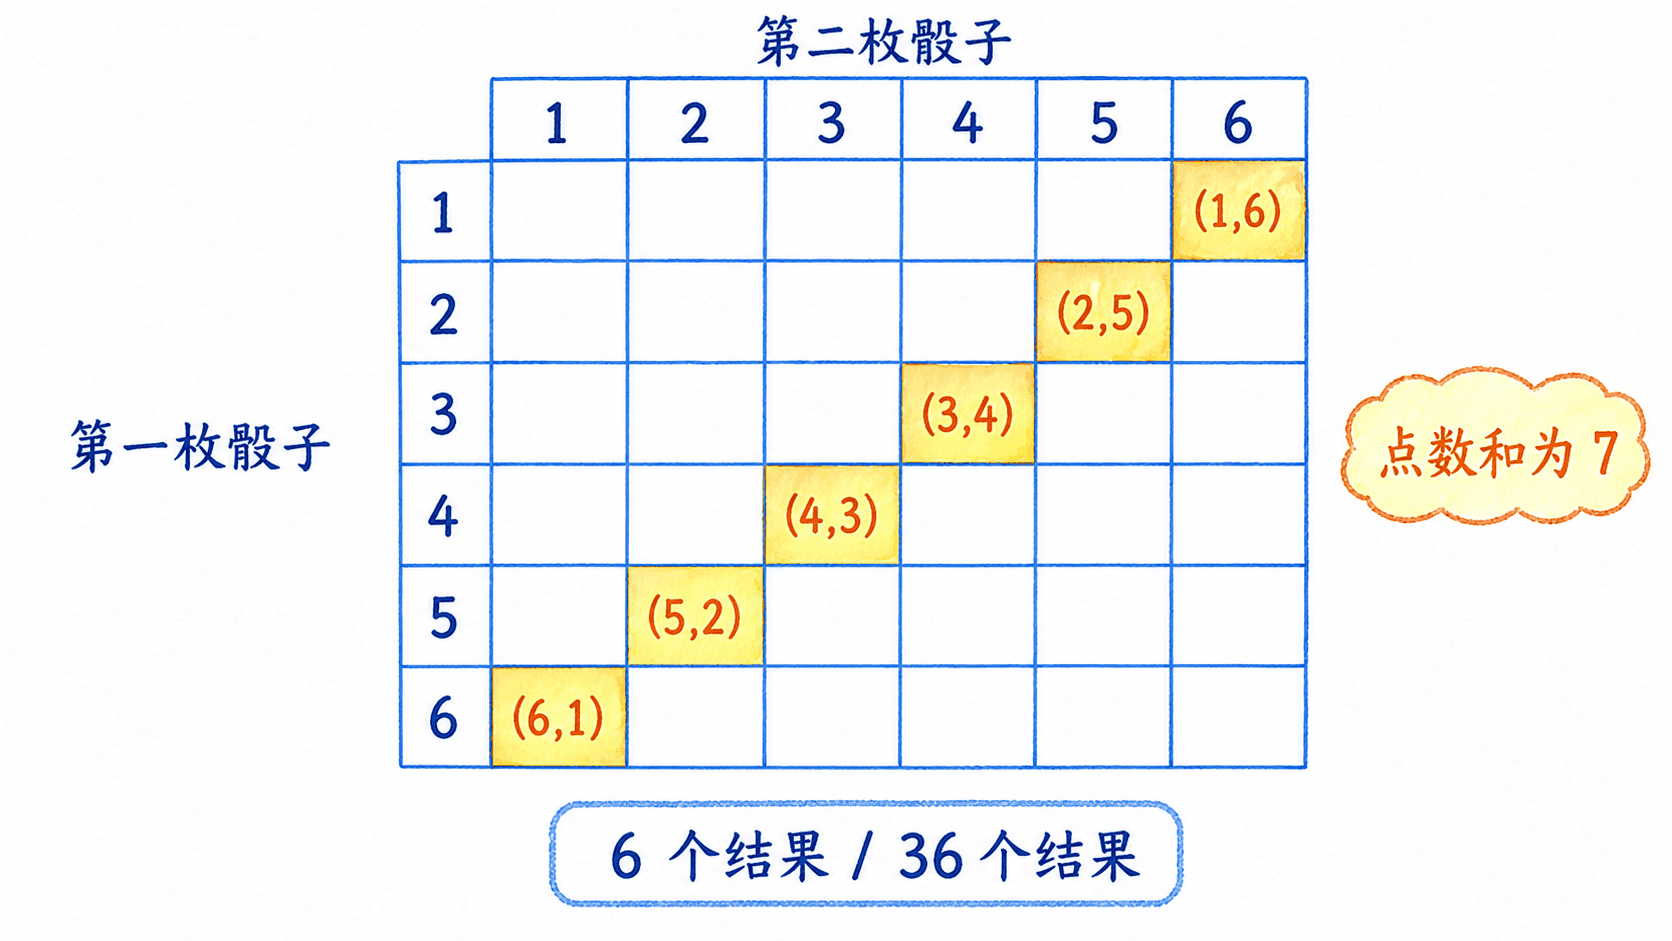 生成函数数出和为 7 的结果有 6 个;要变成概率,还要确认全部 36 个结果等可能。
这个例子正好是生成函数与概率的交界处。生成函数只告诉我们目标事件里有多少个结果。概率是多少,还取决于随机试验怎样产生这些结果。
生成函数怎样接住线性递推
生成函数不只会处理“选东西”。只要序列由线性递推定义,移位操作就常常能把整条递推压成一个代数方程。
我们用熟悉的斐波那契序列说明方法。设
f0=0,f1=1,
并且对 n≥2,
fn=fn−1+fn−2.
定义生成函数
F(x)=f0+f1x+f
先把三个级数对齐
原级数是
F(x)=f0+f1x+f
乘以 x 后,
xF(x)=f0x+f1x2
再乘一个 x,
x2F(x)=f0x2+f
现在计算
F(x)−xF(x)−x2F(x).
常数项是 f0=0,一次项是 f1−f0。对所有 , 的系数是
fn−fn−1−fn−2
所以整个级数只剩下 x:
F(x)−xF(x)−x2F(x)=x.
整理得到
F(x)=1−x−x2x.
这一步很能说明生成函数的作用。递推式本来分别约束每一个 n,生成函数把无穷多个约束一起变成了一个代数方程。若继续对右边做部分分式分解,就能得到 fn 的闭式;本章更关心前半程——递推为什么会变成这个有理式。
初值为什么不能漏
推导中唯一没有被递推式消掉的,就是低次项。它们由 f0,f1 决定。若初值换了,即使递推关系不变,最后分母通常相同,分子也会变化。
处理递推时,不能只写“把递推两边求和”然后直接跳到答案。要先说明递推从哪个 n 开始,再检查常数项和前几个低次项。多数错式都不是错在递推本身,而是错在起始下标和初值。
更一般地,若序列满足
an=c1an−1+
把各个移位项写成 xA(x),x2A(x),…,xdA(x),再处理低次项与 h 的生成函数,常常可以解出 。至于能否从 提取出漂亮的闭式,要看分母能否分解以及非齐次项 的结构。
形式幂级数的边界
现在该回答那个一直被搁置的问题:无限级数真的可以像多项式一样随便算吗?答案是可以进行一套明确的形式运算,但“可以”不等于没有边界。
形式幂级数先是一列系数
把
A(x)=a0+a1x+a2
理解成无限序列
(a0,a1,a2,…).
两个形式幂级数相等,意思是每个位置的系数都相等。加法按位置进行:
(a0,a1,…)+(b
乘法用卷积定义:乘积的第 n 个系数是
cn=i=0∑naib
这里有一个关键安全点:虽然两个序列都是无限的,但固定 cn 时只会用到 n+1 个乘积项。这是有限和,所以每个系数都被清楚定义。
为什么暂时不用讨论收敛
数值分析关心把某个实数或复数代入 x 后,级数是否收敛。形式幂级数关心的是系数序列和代数规则。两者是不同问题。
例如
1−x1=1+x+x2+x
作为数值等式,只在相应的收敛范围内成立;作为形式幂级数等式,它表示右边与 1−x 卷积相乘后得到系数序列 (1,0,0,…)。这个系数事实不需要先给 x 选一个数值。
哪些除法是允许的
在实数或复数系数的形式幂级数中,一个级数
A(x)=a0+a1x+a2
存在乘法逆元,当且仅当常数项 a0=0。原因可以从卷积的第 0 项看出来:若 A(x)B(x)=1,必须有
a0b0=1.
常数项为 0 时做不到;常数项非零时,可以先定 b0=1/a0,再逐项解出后面的系数。
所以 1/(1−x) 合法,因为 1−x 的常数项是 1。但不能看到任何级数都直接写倒数。
本章允许与不允许的动作
在本章范围内,我们可以:
- 逐项相加、乘常数。
- 乘以 xk 做移位。
- 用卷积定义两个级数的乘积。
- 在分母常数项非零时使用形式逆元。
- 为提取 [xn] 而安全删去高于 n 次的项。
但我们不能把形式恒等式自动当成任意数值 x 下的等式,也不能忽略起始下标、负幂或未定义的除法。本章只处理非负整数次幂;带负幂的级数需要另一套约定,不在这里展开。
一个实用检查方法是:不要问“这个无限式看起来能不能算”,而要问“目标系数由哪些有限项决定”。只要每一步都能落回明确的系数运算,形式推导就有依据。
从计数过渡到概率
到这里,生成函数已经能回答“满足条件的对象有多少个”。概率再往前走一步:当一个结果是随机产生的,这些对象出现的机会怎样分配?
最简单的情形是有限且等可能。比如从所有长度为 5 的二进制字符串中等可能地选一个。全部字符串有
25=32
个。恰好含三个 1 的字符串有
(35)=10
个,也可以写成
[x3](1+x)5=10.
于是所求概率是
3210=165.
这个过程里,生成函数只负责得到分子 10。分母 32 来自样本空间,分数能被解释成概率,还依赖“每个长度为 5 的字符串被选中的机会相同”这个假设。
“有利结果数除以全部结果数”不是概率的无条件定义。它只适用于有限等可能模型。若结果不等可能,就必须给每个结果分配自己的概率,再把事件内的概率相加。
样本空间和事件
一次随机试验所有可能结果组成的集合叫样本空间,通常记作 S。样本空间中的单个元素叫结果。事件是样本空间的子集。
这三个词最好放在同一幅图里理解:
结果 ω∈事件 E⊆样本空间 S.
两枚骰子的样本空间
掷两枚骰子时,一个合适的样本空间是
S={(i,j):1≤i≤6, 1≤j≤6}.
这里 (i,j) 表示第一枚骰子得到 i,第二枚得到 j。因为两枚骰子有身份,(2,5) 与 (5,2) 是两个不同结果。样本空间大小为
∣S∣=6⋅6=36.
事件“点数和为 7”是子集
E={(1,6),(2,5),(3,4),(4,3),(5,2),(
因此
∣E∣=6.
为什么不能把可能的和当成等可能结果
若只写
{2,3,4,…,12},
虽然列出了所有可能的点数和,却把信息压得太粗。和为 2 只有结果 (1,1),和为 7 却有六个结果。若直接把这 11 个和看成等可能,就会错误地得到“和为 7 的概率是 1/11”。
样本空间没有唯一写法,但选完之后必须能正确分配概率。把结果设计成等可能的细粒度结果,通常最方便计数。
事件可以继续做集合运算
因为事件就是集合,所以前面学过的集合运算可以直接搬过来。若 A 表示“点数和为偶数”,B 表示“第一枚骰子大于第二枚”,那么:
- A∩B 表示两个条件同时满足。
- A∪B 表示至少一个条件满足。
- Ac=S∖A 表示 没有发生。
这不是换一套新语言,而是把集合论放进随机试验的语境里。
等可能模型与计数概率
若有限样本空间 S 中每个结果的概率相同,那么每个结果的概率必为
∣S∣1.
对任意事件 E⊆S,事件概率就是
P(E)=∣S∣∣E∣.
分母数全部结果,分子数满足事件条件的结果。这条公式把前面所有计数方法都接进了概率:乘法原理可数分母,组合数可数分子,容斥可处理重叠条件,生成函数可提取满足总和限制的结果数。
例题:两枚公平骰子的和为 7
两枚骰子公平且相互独立地掷出时,36 个有序结果等可能。事件 E 有 6 个结果,所以
P(E)=366=61.
前面已经用生成函数算出
[x7](x+x2+⋯+x6)
因此同一个答案可以分成两层理解:系数提取给出事件大小,等可能模型再把事件大小除以样本空间大小。
例题:五张牌中恰有三个同点数、另两张同点数
从一副标准 52 张扑克牌中等可能抽取 5 张,不考虑顺序。全部手牌数是
∣S∣=(552).
要得到“三张同点数加一对”的牌型:先从 13 种点数中选三张牌的点数,再从该点数的 4 个花色里选 3 个;然后从剩余 12 种点数中选对子点数,再从 4 个花色里选 2 个。因此
∣E∣=13(34)⋅12(24).
概率为
P(E)=(552)13(
这个例子提醒我们,概率计算的难点常常不在最后的除法,而在分子、分母是否数的是同一种粒度的等可能结果。
一个稳妥的四步流程
概率直觉很容易在结果粒度、等可能性或隐藏规则上出错。面对有限离散模型,可以固定走四步。
确定样本空间
列出随机过程可能产生的全部结果,并决定每个结果要记录哪些信息。若试验分多步,可以用有序组或树状路径记录。
定义目标事件
把题目中的“发生某事”翻译成样本空间的一个子集。定义要能判断每个结果到底属于还是不属于事件。
确定结果概率
这一步来自模型假设,而不是凭空由数学推出。公平骰子、等可能抽样、带偏硬币会给出不同的结果概率。若试验分多步,树上每条根到叶的路径概率来自沿途分支概率的乘积;完整理由留到后面的条件概率与独立性部分。
把事件中的概率相加
一般的离散模型中,事件概率是事件内所有结果概率的和:
P(E)=ω∈E∑P({ω}).
只有当这些单个结果等可能时,才可化成
P(E)=∣S∣∣E∣.
一个反例:带偏硬币
设一枚硬币出现正面的概率是 0.7,反面的概率是 0.3。样本空间
S={正面,反面}
有两个结果,事件“出现正面”只有一个结果。若机械套用计数比例,会得到 1/2,但正确答案是 0.7。
问题不在样本空间少列了什么,而在两个结果并不等可能。此时必须按结果概率求和。
做完一道有限概率题后,可以反问四句:全部结果列全了吗?事件定义准确吗?结果真的等可能吗?分子和分母用的是同一种结果单位吗?这四句能拦住大部分入门错误。
补集技巧与生日碰撞
有些事件直接数很麻烦,反面却很好数。若 Ec 是 E 的补集,那么
P(E)=1−P(Ec).
生日碰撞就是典型例子。假设一年有 d 天,n 个人的生日相互独立,并且每一天等可能。我们要算“至少两个人生日相同”的概率。
直接分类会碰到一对相同、两对相同、三人同日等大量重叠情况。换成补集“所有人的生日都不同”,计数就整齐多了。
全部生日序列有
dn
种。若 n≤d,生日全不相同的序列数是
d(d−1)(d−2)⋯(d−n+1).
因此
P(所有生日都不同)=dnd(d−1)(d−2)⋯(
于是
P(至少一对生日相同)=1−dnd(d−1)(d−
当 d=365,n=23 时,这个概率约为
0.5073.
人数远小于 365,碰撞概率却已经超过一半。原因是比较的不是“人数与天数”,而是人与人之间的配对数量;23 个人已经产生
(223)=253
对比较机会。
这里的数值建立在两个明确假设上:每天等可能,且不同人的生日相互独立。现实出生日期并不完全满足这两个条件,所以这个模型是对现实的简化。模型假设变了,答案也会变。
离散概率的最小公理框架
为了把前面的例子统一起来,可以给有限或可数样本空间中的每个结果 ω 分配一个非负数
P({ω})≥0,
并要求全部结果的概率和为 1:
ω∈S∑P({ω})=1.
事件 E 的概率定义为其中所有结果概率之和:
P(E)=ω∈E∑P({ω}).
从这个定义可以推出几条熟悉的规则。若 A 与 B 互不相交,则
P(A∪B)=P(A)+P(B).
一般情况下,交集被重复计算了一次,所以
P(A∪B)=P(A)+P(B)−P(A∩B).
补集满足
P(Ac)=1−P(A).
若 A⊆B,则
P(A)≤P(B).
你会发现,这些公式与有限集合的基数公式几乎平行。区别在于,基数给每个元素权重 1,概率给每个结果一个总和为 1 的非负权重。
本章刻意停在哪里
本章只建立离散概率的入口,不讨论以下内容:
- 已知一个事件发生后怎样更新概率。
- 两个事件何时独立。
- 随机变量、期望与方差。
- 连续样本空间中的密度与积分。
这些内容需要在当前框架上继续增加定义。现在最重要的是把样本空间、事件、结果权重和等可能条件分清楚。
章末练习
系数读取与移位
设
A(x)=3−2x+5x4.
求 [x0]A(x)、[x2]A(x)、[x。
[x0]A(x)=3,因为常数项是 3;[x2]A(x)=,因为没有 项;乘以 后,原来的 变成 ,所以 。
卷积
设
A(x)=1+2x+x2,
B(x)=1+x+x2+x3.
不用完整展开,求 [x3]A(x)B(x)。
只收集指数和为 3 的项:a0b3=1⋅1,a,。因此
有限制的选择
某袋糖果中,柠檬糖只能取偶数颗,薄荷糖至多取两颗。写出记录糖果总数的生成函数,并说明恰好取 6 颗的方案数。
柠檬糖对应 1+x2+x4+x6+⋯,薄荷糖对应 ,所以生成函数是
线性递推入口
设 a0=2,并且对 n≥1 有
an=3an−1.
令 A(x)=∑n≥0anxn,求 。
对 n≥1 的系数,A(x)−a0 与 3xA(x) 相同,因此
等可能概率
从所有长度为 6 的二进制字符串中等可能地选一个,求恰好含两个 1 的概率。
样本空间大小为 26=64。事件大小为
[x2](1+x)6非等可能提醒
一个转盘有三个区域 A,B,C,它们的面积分别占总面积的 1/2,1/3,1/6,指针均匀落在转盘面积上。事件“落在 A”包含三个命名结果中的一个,为什么概率不是 1/3?
三个命名区域并不等可能。指针落入区域的概率与面积占比相同,所以 P(A)=1/2。只有样本空间中的单个结果等可能时,才能使用事件结果数除以样本空间结果数。
从计数走向图论
这一章把前面的计数方法做了两次转换。第一次把一整列计数装进系数,让代数乘法替我们枚举规模拆分;第二次把计数结果放进样本空间,让“有多少个”在等可能条件下变成“有多大概率”。
接下来进入图论时,关注点会从“对象有多少”转向“对象之间怎样连接”。但这里练过的习惯仍然有用:先选对表示方式,再确定什么信息被保留下来。生成函数用幂次和系数保存规模,概率空间用结果和事件保存随机现象,图则会用顶点和边保存关系。