熵
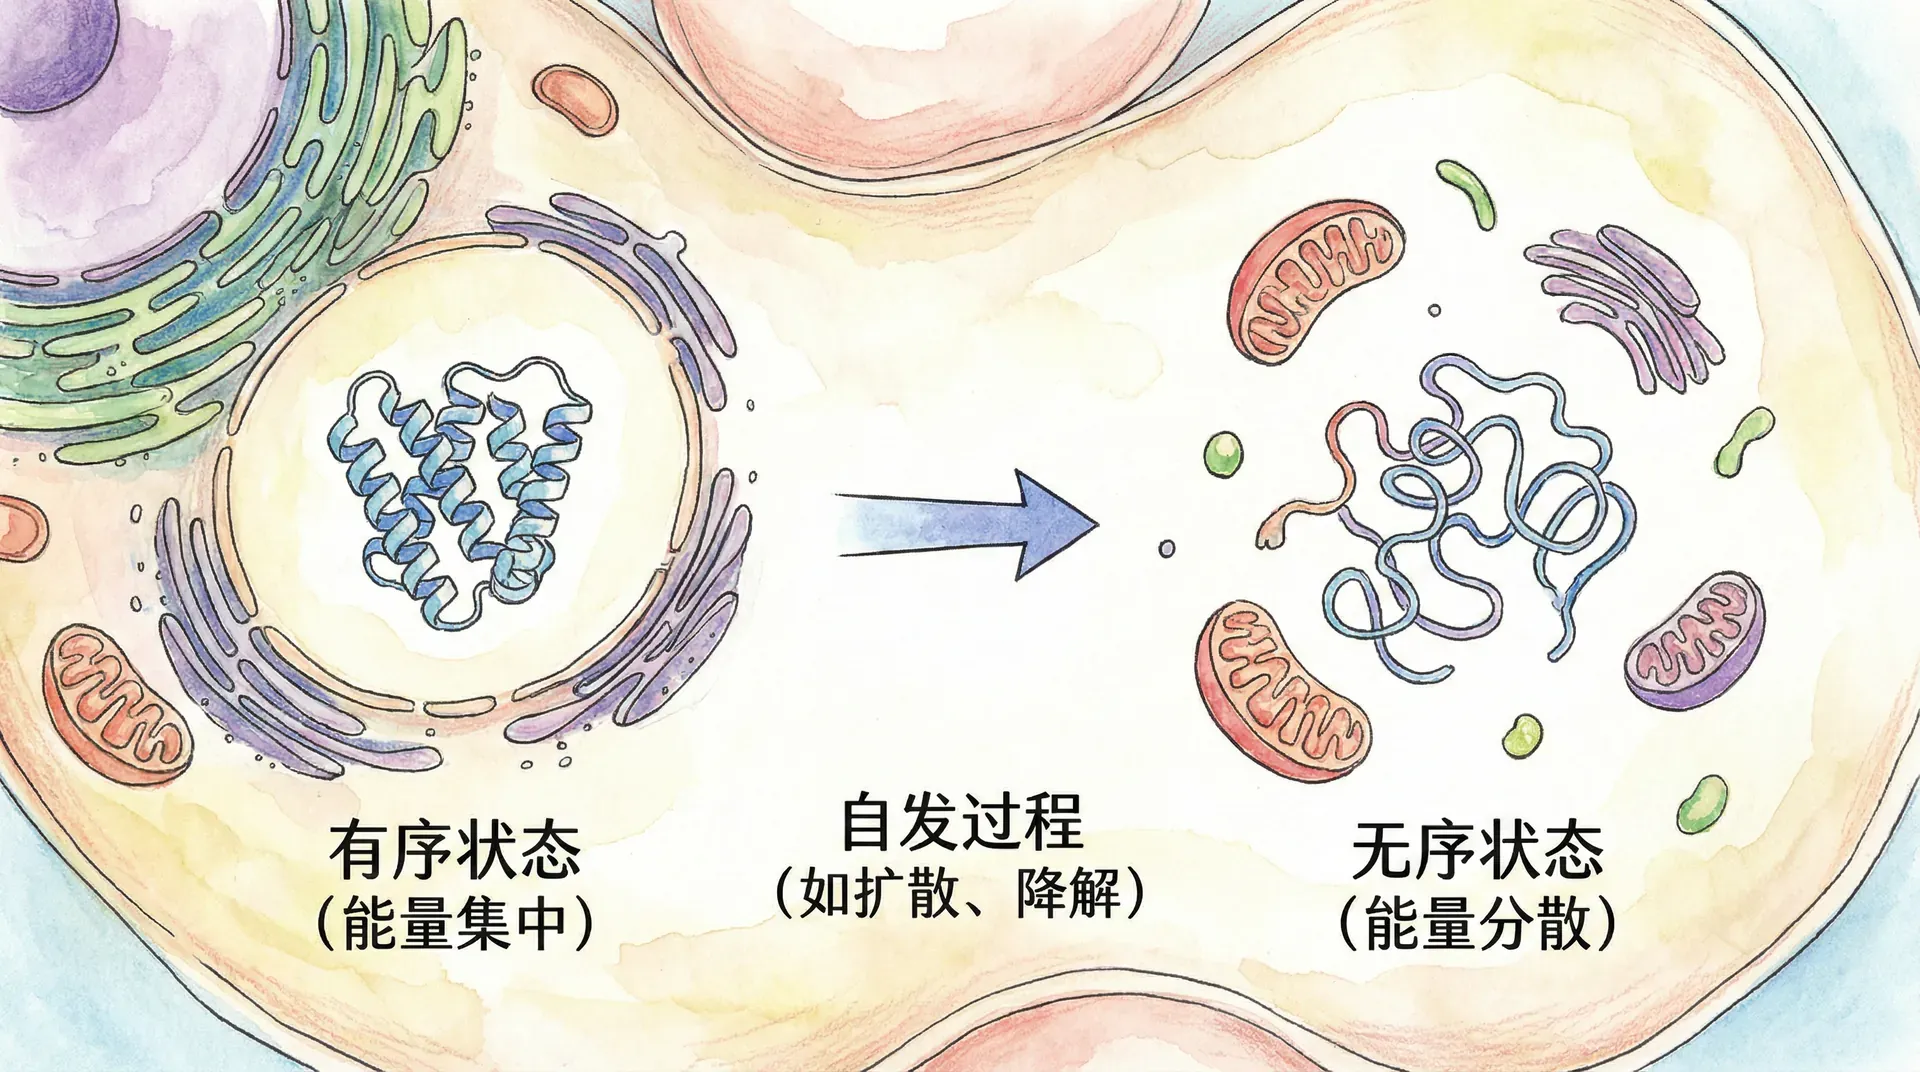
熵常被粗略比作“混乱”,但这个比喻很容易失真。热力学熵是状态函数,统计力学则把它与给定宏观条件下可实现的微观状态分布联系起来。墨水在水中扩散是合适的直觉例子,因为均匀分散对应的可实现微观排列远多于墨水集中在一角;房间是否整洁则涉及人的分类标准,不是直接的热力学测量。
生化过程是否自发要看系统与环境的总熵变化,或在恒温恒压条件下看吉布斯自由能。生命体是开放系统,持续交换物质和能量,因此细胞内部形成有序结构并不违反第二定律。能量输入很重要,但更准确的说法是反应通过耦合和耗散维持远离平衡的状态。
从掷硬币看多重度
理解多重度的基本概念
多重度表示同一个宏观描述对应多少个微观状态。若这些微观状态等概率,宏观态的概率与成正比;若能量不同或概率不等,还需要用相应统计权重,不能把多重度直接等同于一般意义的自由度或无序程度。
最简单的例子莫过于掷硬币实验:如果我们一次掷10枚硬币,每一枚落下正面(H)或反面(T)的概率是相等且独立的。所有10枚都正面、所有都反面、本数正反各占一半,各种情况出现的多重度是完全不同的。有些结果的组合方式很多,有些则极其有限。
以4枚彼此独立且正反面等概率的硬币为例,全部具体序列共有种。若宏观态只记录正面数量,就可以把这些序列按0到4个正面分组:
出现2个正面有6种具体序列,所以在这个理想模型中概率最高;全正或全反各只有一种。这里的结论依赖“独立、等概率”和“只统计正面数量”三个条件。
未折叠多肽通常能访问较多主链构象,折叠后链构象熵往往降低。但蛋白质折叠的方向由肽链、溶剂和其他组分的总自由能决定,疏水水合、非共价接触和温度都参与补偿,不能说蛋白质折叠会“释放熵”。
书架类比容易把主观的“整齐”混入物理定义。更可靠的做法是先规定微观状态、宏观约束和概率,再计算多重度。例如气体分子被限制在半个容器时,可用位置状态计数说明解除隔板后为何几乎总会扩散到整个容器。
二项分布的数学表达
更一般地讲,n枚硬币中正面出现k次的多重度,可以用二项式系数(数学上称为组合数)来计算:
该式适用于次独立、每次只有两种结果的模型。若正面概率不是,概率还要乘;DNA不同位点的突变率与相互依赖通常并不相等,因此二项分布只能作为明确假设下的近似。
把模型扩展到10枚独立且公平的硬币,各正面数量对应的多重度如下:
说明:
- “正面个数”为,对应出现枚正面,时反面为;
- “多重度(种数)”为每种情况在总样本中的出现方式数;
5个正面的多重度最大,是因为有最多具体序列归入这一组。随着系统增大,最可能宏观态附近会集中绝大多数微观状态。这个组合事实可以帮助理解热力学极限,却不能推出“熵是生物演化的内在驱动力”;演化还依赖遗传、变异、选择和漂变。
信息论的香农熵与统计熵都使用概率分布和对数,因此数学形式相关。但信息熵的单位和解释取决于编码与随机变量,热力学熵则与物理状态和温度等量相联系。只有明确映射时,二者才能定量对应。
斯特林近似的价值
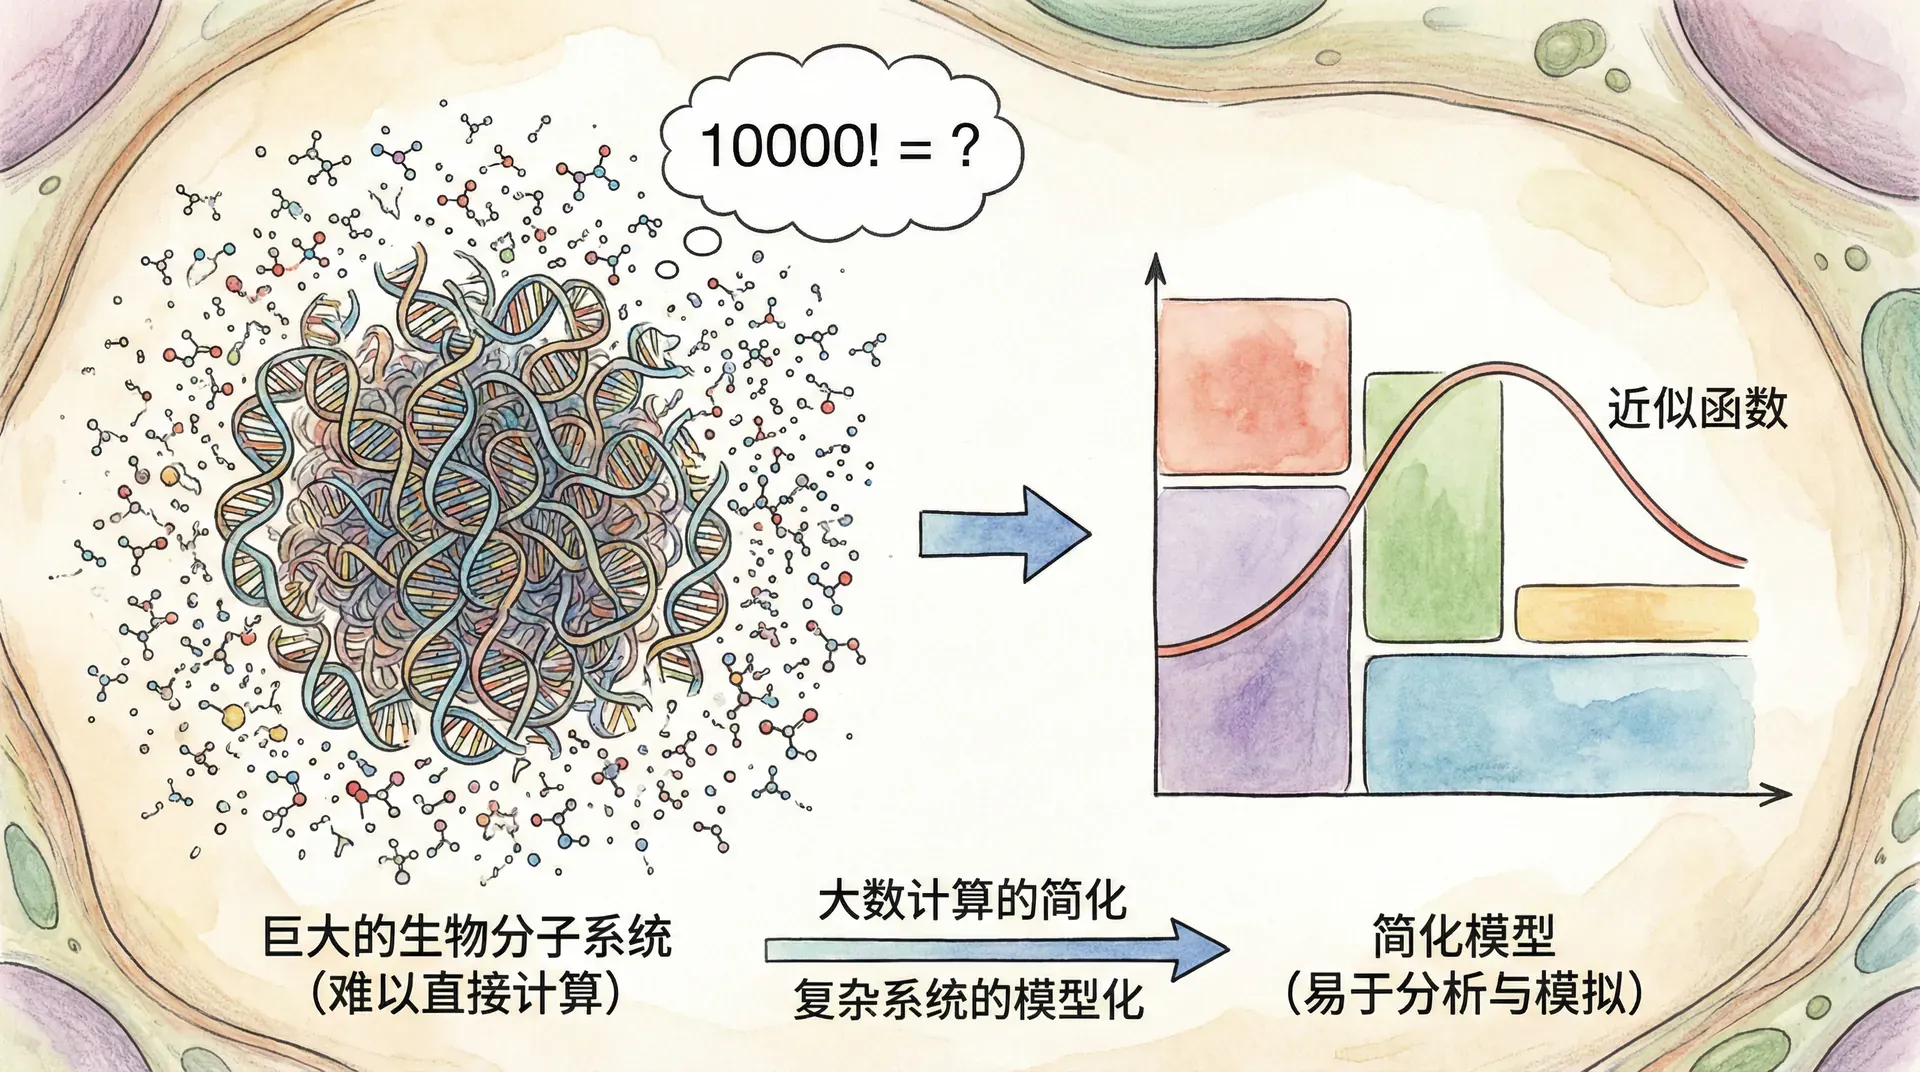
大数系统的计算
阶乘随迅速增长,直接写出大数往往没有解释价值。统计物理通常计算或概率比值,这既避免数值溢出,也能把乘法转换为加法。斯特林近似正适合处理这类大极限。
这时,斯特林近似为我们提供了极大的便利。它指出,对于足够大的N,可以用如下近似关系代替N!:
但在实际应用中,例如计算熵或对数多重度,我们关心的往往是阶乘的对数形式。斯特林近似的对数表达式更加简洁:
其中,最后一项在N很大的时候影响很小,常常可以忽略。于是实际计算中进一步简化为:
近似的价值不仅在于计算更快,还在于揭示哪些项随系统大小线性增长、哪些只是较小修正。使用前应检查是否足够大,以及忽略会不会影响所需精度。
生物系统中的应用
生命科学中真正适合斯特林近似的问题,通常具有明确的组合计数结构,例如大量粒子在若干状态间分配、长序列中某类位点的计数,或大样本二项系数的对数。
-
粒子分配: 若个可区分粒子被分到若干状态,组合数中的阶乘可用斯特林公式近似。真实细胞中的蛋白有种类、位置和相互作用限制,不能直接把数百万蛋白写成。
-
构象计数: 若理想模型假定100个残基各有3种独立状态,则总数为,其对数直接是,并不需要斯特林近似。真实残基并不独立,这个模型只提供数量级直觉。
-
分子生物学中的遗传多样性分析
计算例如一段DNA序列中k个位点发生突变时的组合数,常需用到二项式系数。在n很大的情况下,斯特林近似同样可以帮我们近似算出组合数的数量级,从而推断可能的遗传变异类型的多样性。
组合空间很大只说明候选很多,不能由此预测药物配伍或生物效应。药物组合还涉及剂量、代谢、相互作用和临床结局,需要机制与实验数据评价;斯特林近似只能估算数量,不能推断疗效叠加。
数学与直觉结合
斯特林近似把难以处理的阶乘转化为对数中的主导项,使大系统的概率集中和广延性更容易看清。它适用于模型中定义清楚的计数,并不会自动让复杂生物系统变得可预测;相关性、依赖关系和动力学仍需单独建模。
高斯分布
从二项分布到高斯分布
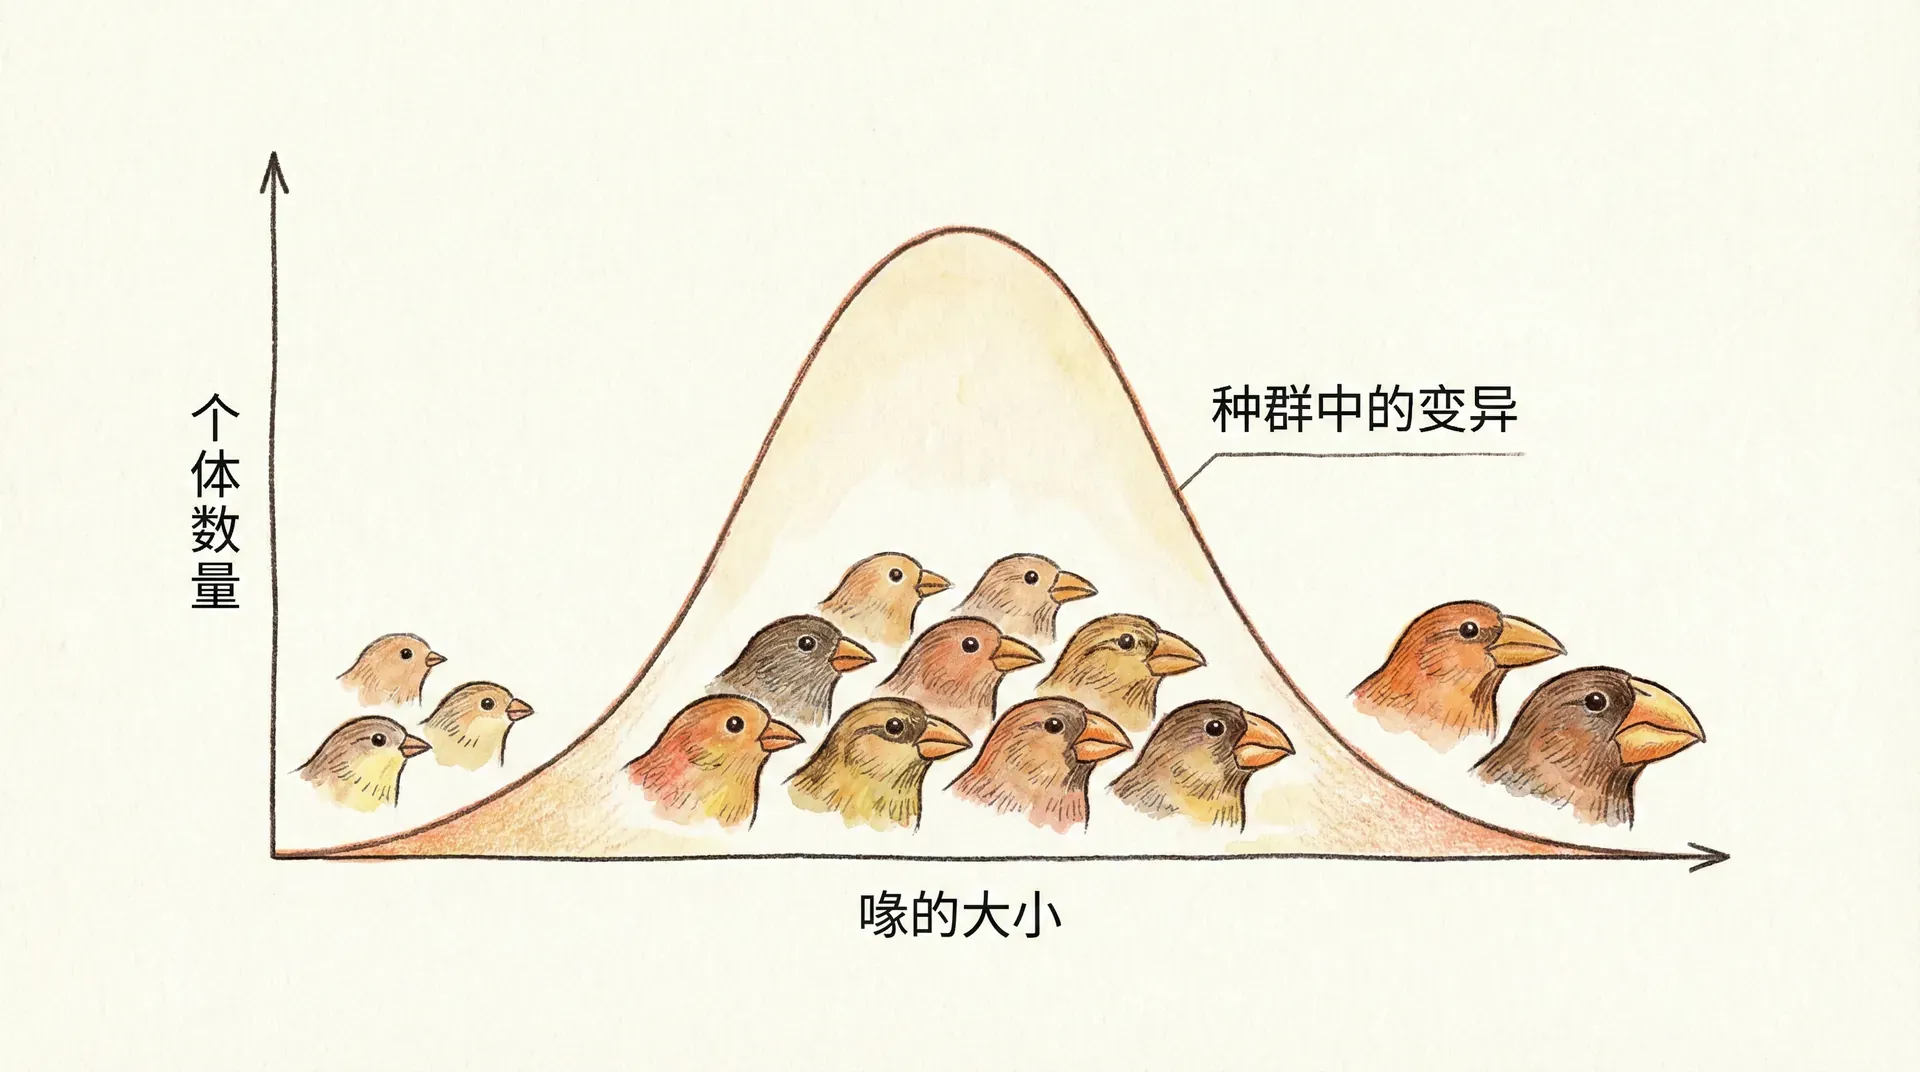
当很大且成功概率不太接近0或1时,二项分布在适当中心化和缩放后可由高斯分布近似。更一般的中心极限定理描述许多独立或弱相关随机变量之和在一定条件下趋近正态,并不意味着自然界的所有测量最终都会是钟形。
高斯分布的数学表达式为:
其中(mu)为平均值,为标准差,决定了分布的中心和宽度。高斯分布有几个核心特征:
生物系统中的高斯分布实例
高斯分布适合一些由许多小效应相加产生的连续性状或测量误差,但生命科学还常见二项、泊松、对数正态、负二项和多峰分布。应先查看数据与生成机制,再选择分布。
-
身高等数量性状: 在限定年龄、性别和人群后常近似钟形,但均值与标准差随样本而变,不能用单一数值代表全部成年男性。
- 约68%的成年男性身高在163-175厘米之间(μ±σ)
- 约95%在157-181厘米之间(μ±2σ)
- 约99.7%在151-187厘米之间(μ±3σ)
这些区间正好对应高斯分布下的“1σ、2σ、3σ”法则,反映大多数生理参数的稳健性与极端情况的少见。
-
近似谐振动: 原子在单一势阱底部的小幅坐标涨落可近似高斯,但蛋白质构象转换常表现为非高斯或多峰分布。晶体学B因子也同时包含热运动、静态无序和模型误差。
-
数量性状: 多基因与环境效应相加时,表型可能近似正态;自然选择、边界和亚群混合会造成偏态或多峰,分布形状本身不等于“适应性”。
-
细胞数据: 体积、寿命和荧光强度常呈偏态或包含多个细胞亚群。用高斯模型强行剔除“异常值”可能删除真实生物差异,应通过残差、分布图和独立验证判断。
高斯分布与生物测量的不确定性
多次测量值只有在许多独立小误差相加且没有系统偏差时才近似高斯。标准差描述样本离散程度,置信区间还取决于样本量和模型;系统误差、批次效应和仪器漂移不会因增加重复次数自动消失。
概率分布是对数据生成过程的假设。蛋白质热运动、基因频率和反应速率由不同机制产生,不能因为都存在波动就统一套用高斯分布。合适的分析应说明随机变量、尺度、边界和独立性。
熵与多重度的深刻联系
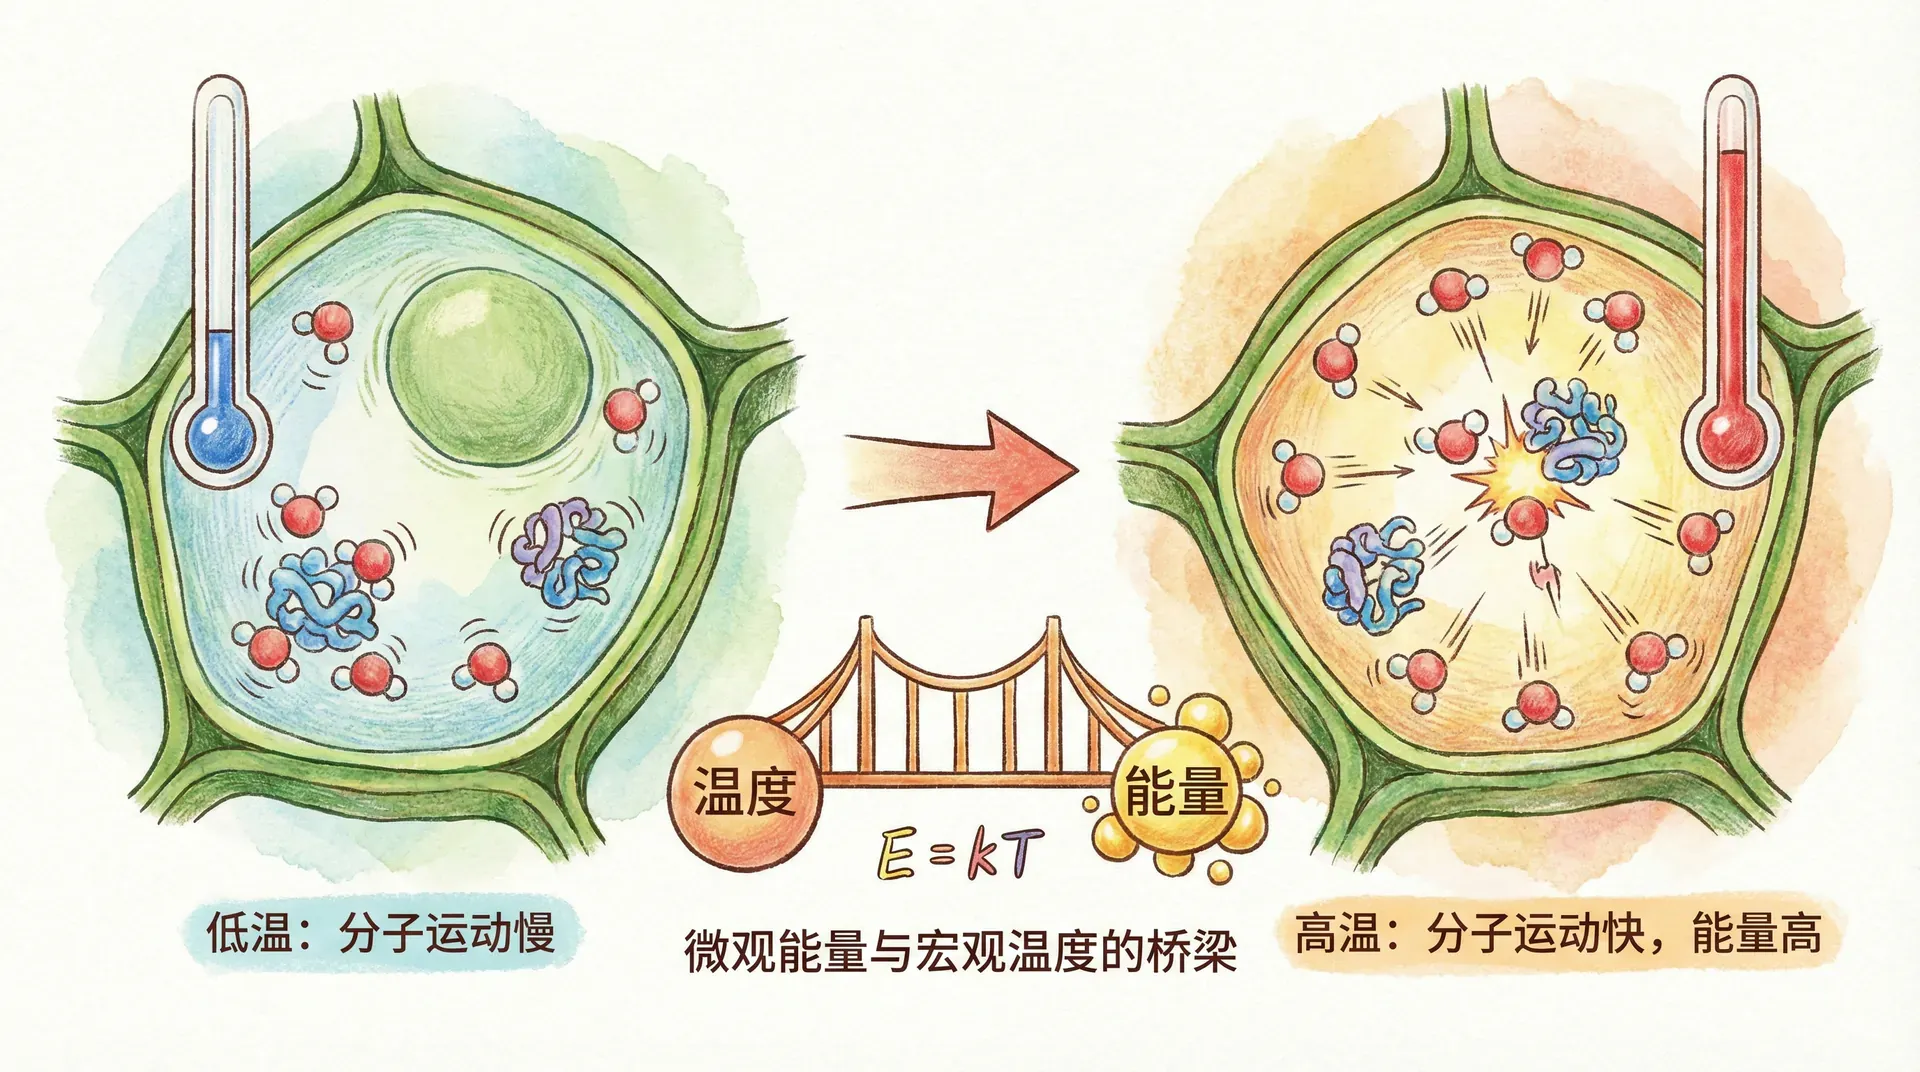
玻尔兹曼常数的引入
奥地利物理学家路德维希·玻尔兹曼提出了熵与多重度之间的定量关系,被称为玻尔兹曼熵公式:
适用于给定宏观条件下等概率的可访问微观状态。更一般的统计熵写作。熵与“无序”有时方向一致,却更可靠地描述为概率如何分散在可访问状态上。
微观状态数会随系统大小迅速增长,所以使用对数后,彼此独立子系统的熵可以相加。必须由明确的相空间划分和约束定义,随手给出“50个分子超过个状态”并没有统一物理意义。
理解熵的物理意义
熵不能简单等同于看起来是否杂乱,也不能不加条件地解释为“缺失的信息量”。在热力学中,它与热量、温度和状态方程相联系;在统计描述中,它由微观状态概率计算。对生物过程,应明确讨论的是链构象熵、混合熵、溶剂熵还是总熵。
蛋白质折叠: 肽链折叠后构象熵通常下降,溶剂水和离子则会重新组织,形成或失去分子接触也改变焓。只有为负时,给定条件下的折叠才在热力学上有利。
膜的流动性:
生物膜由大量脂质分子组成。在低温下,脂质链紧密有序排列,熵较低;温度升高后,分子热运动增强,结构更加杂乱,对应的多重度和熵都显著增加。这一现象不仅影响生物膜的流动性和功能,还决定了膜相变的温度。
代谢稳态: 细胞浓度在相对稳定范围内并不等于热力学平衡。代谢物持续输入、转化和输出,稳态通量耗散自由能;若切断能量和物质供给,系统会转向不同状态。
熵在生化反应中的作用
以ATP的水解反应为例,深入理解熵在生化过程中的驱动作用:
ATP水解在细胞条件下通常具有负自由能变化,原因包括产物的共振与水合、静电排斥缓解以及实际ATP、ADP和磷酸浓度。反应物和产物分子数并不能单独决定熵,更不能把“多一个分子”当作普遍驱动力。
每个反应的自发方向都由反应商和标准自由能共同决定。细胞常把热力学有利的ATP水解或离子顺梯度过程,与不利的合成和运输耦合;耦合后的总自由能为负,才使整体过程得以推进。
热力学第二定律

熵增原理的表述及意义
热力学第二定律可表述为:孤立系统的总熵在自发过程中不会降低,平衡时达到约束条件下的最大值。对有限微观系统,短时涨落可以出现;宏观不可逆性来自偏离最可能状态的概率极低。
扩散和热传导常使浓度或温度梯度减小,这可以用熵产生描述,但“更无序”不是普遍判据。某些自发过程会形成看起来更规则的晶体,同时把更多热量排给环境,仍满足总熵不减。
在宏观世界(如气体扩散、冷热传递等)中,熵增表现得非常直观。但在微观世界(例如生物分子的涨落)中,熵的涨落也符合统计规律。即使偶尔出现局部降熵,这种现象在大尺度/长时间下总体仍必然是全局熵增。
细胞和生物体不断与环境交换物质与能量。局部结构形成时,相关反应、热释放和废物排出会影响环境熵;检验第二定律时必须把系统和环境一起计入,而不是笼统讨论“整个宇宙”或只看细胞内部。
生物系统中的熵增实例
我们可以用数据可视化的方式来更直观地理解不同生物过程中熵的变化:
蛋白质变性: 展开通常增加多肽链可访问构象,但水合和聚集可能抵消一部分熵变化。图示若显示上升,应理解为特定模型中的趋势,而不是所有蛋白在所有条件下的定量曲线。
DNA双链解离: 两条链分开后平移和构象自由度增加,但碱基堆积、水合和离子也改变。复制与转录中的局部解链由酶和能量耦合驱动,不能直接等同于热熔解。
膜融合: 脂质混合可能带来有利熵变,但弯曲膜、脱水接触面和打开融合孔需要跨越能垒。细胞通常使用融合蛋白提供定向力并控制时空位置。
合成多肽或核酸等聚合物需要活化单体和能量耦合。热力学账目应包含ATP或GTP水解、焦磷酸水解、热与产物,而不是简单把过程称为“降序”并假定旁边必有某个抽象的“升熵过程”。
熵增与生命活动的动态平衡
生命系统远离平衡,但并不是在有意识地“抵抗熵增”。代谢网络利用环境中的自由能维持浓度梯度、更新大分子并修复损伤,同时产生热和废物。若自由能供应停止,这些非平衡结构会逐渐失去维持。
蛋白质合成把氨基酸按mRNA模板连接成特定序列,同时消耗ATP和GTP。产物也不是唯一僵硬构象,而是会折叠成动态结构;整个过程的方向来自多步化学反应耦合与细胞浓度条件。
热力学平衡与生理稳态不是同一概念。平衡时宏观净通量为零,稳态细胞却可在浓度近似不变时保持持续通量。能量与物质交换正是维持这种状态的条件。
不要把热力学熵直接套用进化
生物进化由可遗传变异、自然选择、遗传漂变、迁移和重组等过程塑造。突变会改变序列概率,选择会改变繁殖成功率;这些概念可以使用信息论工具分析,却不能说物种复杂化是热力学熵增直接推动的结果。
一个生态群落的物种数和均匀度可用香农指数等“多样性指数”描述,这与热力学熵共享数学形式。多样性有时能提高某些生态功能的稳定性,有时也不一定;指数高低不能自动推出系统更健康或更抗干扰。
此外,生物多样性的维持,也和信息熵相关。一个丰富多样的生态系统,其状态空间更大,不同物种、基因型、表型的并存,让整体生态系统熵值增加,这反而提升了系统的鲁棒性和抗风险能力。
总结
多重度、概率分布和熵提供了从微观状态到宏观规律的数学语言。二项分布依赖独立等概率假设,高斯近似有适用条件,则要求明确宏观约束和等概率状态。
第二定律约束孤立系统的总熵变化,开放的生命系统通过自由能通量维持非平衡稳态。蛋白质折叠、ATP水解和膜融合都必须分别计算体系与环境的焓、熵和浓度条件,不能仅靠“有序—无序”判断方向。
这些概念为玻尔兹曼分布和自由能分析打下基础。后续遇到任何统计热力学结论,都可先检查状态怎样定义、概率怎样归一、系统是否平衡,以及被忽略的环境是否会改变答案。