大分子识别的特异性
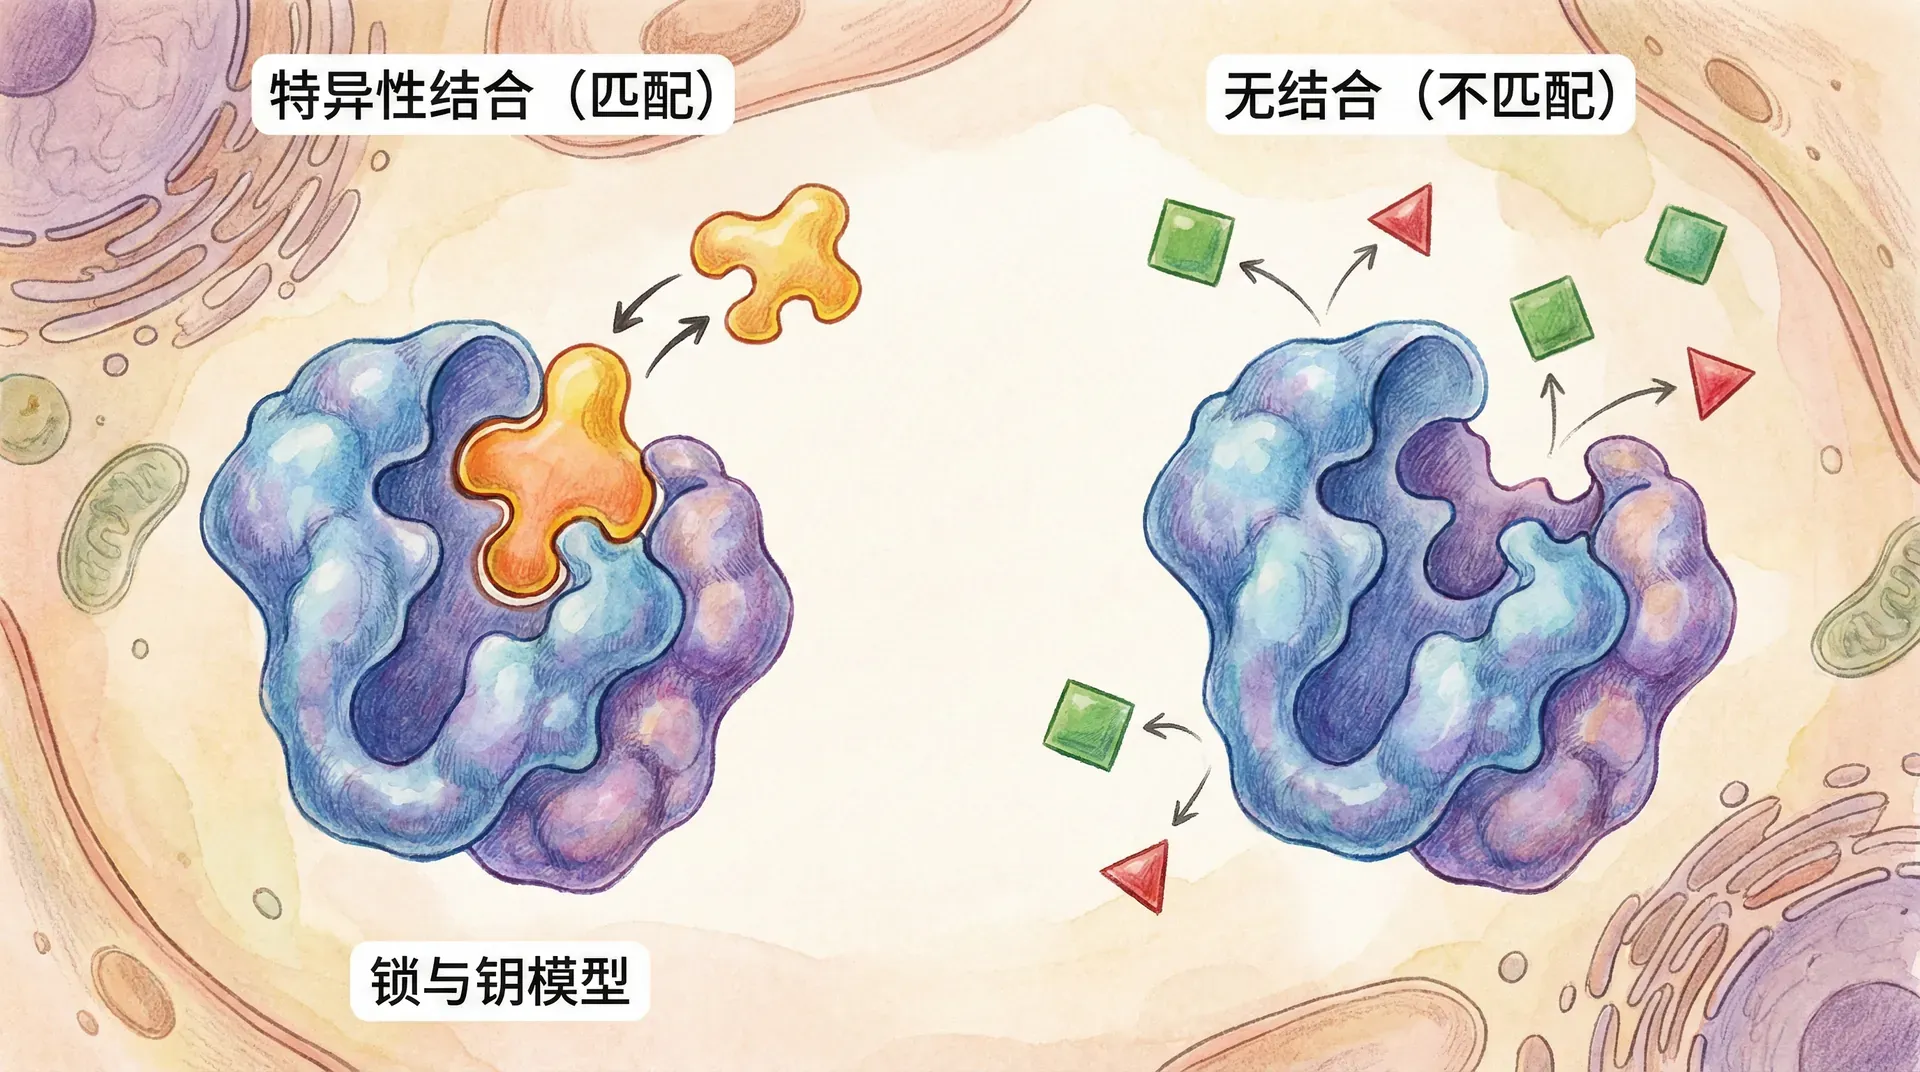
细胞内分子数量众多,蛋白质、核酸和小分子必须在竞争环境中形成有用的结合。识别并非每次都只对应唯一伙伴:有些受体能接受一组相似配体,有些调控蛋白会在不同环境中更换伙伴。所谓特异性,更准确地说是对目标相对于备选对象的选择偏好。
亲和力描述一对分子在给定条件下结合有多有利,常用等参数表示;特异性或选择性必须比较目标与一个或多个竞争对象。高亲和力可以伴随低选择性,较弱的结合也可能在合适浓度与空间位置上产生专一功能。
抗体区分抗原、转录因子读取DNA、激素受体结合配体,都依赖形状、电荷、氢键、疏水接触、构象和局部浓度。理解识别需要从一对分子的结构扩展到有竞争者、有浓度限制和有时间变化的细胞环境。一次短暂误配未必产生输出,长寿命复合物也未必位于正确区室,因此“结合”与“功能识别”需要分层讨论。
特异性与亲和力的区别
亲和力针对一对结合伙伴,平衡时可用描述;越小通常表示复合物相对更稳定。选择性则是相对概念,必须说明拿目标和哪些替代配体、序列或蛋白比较,以及温度、盐和pH等实验条件。
对一个目标T和一个竞争对象C,可用解离常数或结合自由能之差表达一项具体选择比:
这个比值只回答指定两者之间的比较,不能作为普遍“特异性分数”。实际体系还要考虑各自浓度、可接近性、动力学寿命和多价效应。
配体浓度对特异性表现的影响
配体浓度通过占据率改变选择性的实际表现。若目标亲和力更高,它可在较低浓度时先被占据;浓度继续升高后,较弱位点也会逐渐占据。竞争对象本身的浓度同样重要,因此低浓度不会自动保证选择正确。
若目标、竞争对象,在两者浓度和可接近性相近的简化条件下,目标会在更低浓度区间显著占据。若竞争对象浓度高出很多,或存在多价结合,实际选择优势可能缩小。
图中可比较不同配体浓度下目标位点与较弱位点的占据变化:
浓度变化通常产生以下趋势:
-
在目标附近而远低于竞争对象时,目标位点更容易被占据,选择窗口较明显;
-
浓度远高于两类后,两者都接近饱和,单靠亲和力差异带来的占据选择性减弱。
细胞会通过合成、降解、区室化和支架蛋白调节局部浓度,但信号系统并不都工作在低浓度。判断选择性应计算所有主要配体和位点的占据,并结合信号阈值与动力学。
蛋白质识别结构域的组合策略

SH2结构域的特异性机制
SH2结构域识别磷酸化酪氨酸以及周围肽段,是磷酸化信号网络中的常见模块。保守口袋抓住磷酸酪氨酸,邻近残基则与另一个表面区域接触;不同SH2家族成员偏好的位置和序列并不完全相同。
SH2结构域的高特异性并非来自单一结构,而是多种分子机制协同贡献的结果。其主要特异性机制包括:
SH2结合能提高磷酸化依赖性和伙伴选择,但不能保证信号绝不串扰或只能单向传递。多个蛋白可能竞争同一位点,同一SH2也可能结合一组相似序列,细胞还依靠时间、位置和去磷酸化控制输出。
多模块组合增强特异性
许多信号蛋白含SH2、SH3、PH、PDZ或WW等多个结构域。一个模块识别化学修饰,另一个模块识别短肽或膜脂,连接区又规定几何关系。只有多个接触在同一时间和空间都可满足时,复合物才会获得更高的总体稳定性。模块也会提高局部有效浓度,使一个接触短暂解离后仍有机会迅速重新结合,这就是多价体系常表现出较慢总体解离的原因。
多模块结合可产生亲合力增强和选择性提高,但提升幅度不等于各模块选择比的简单相乘。连接臂长度、方向、局部有效浓度、协同性和竞争结合都会改变结果,必须用具体模型或实验测量。
例如,哺乳动物Grb2蛋白拥有两个SH3和一个SH2结构域,能够桥接多种信号组分,仅在特定时空条件下形成信号复合物,保证细胞响应的精确性和有限性。
蛋白质结合界面的热点残基
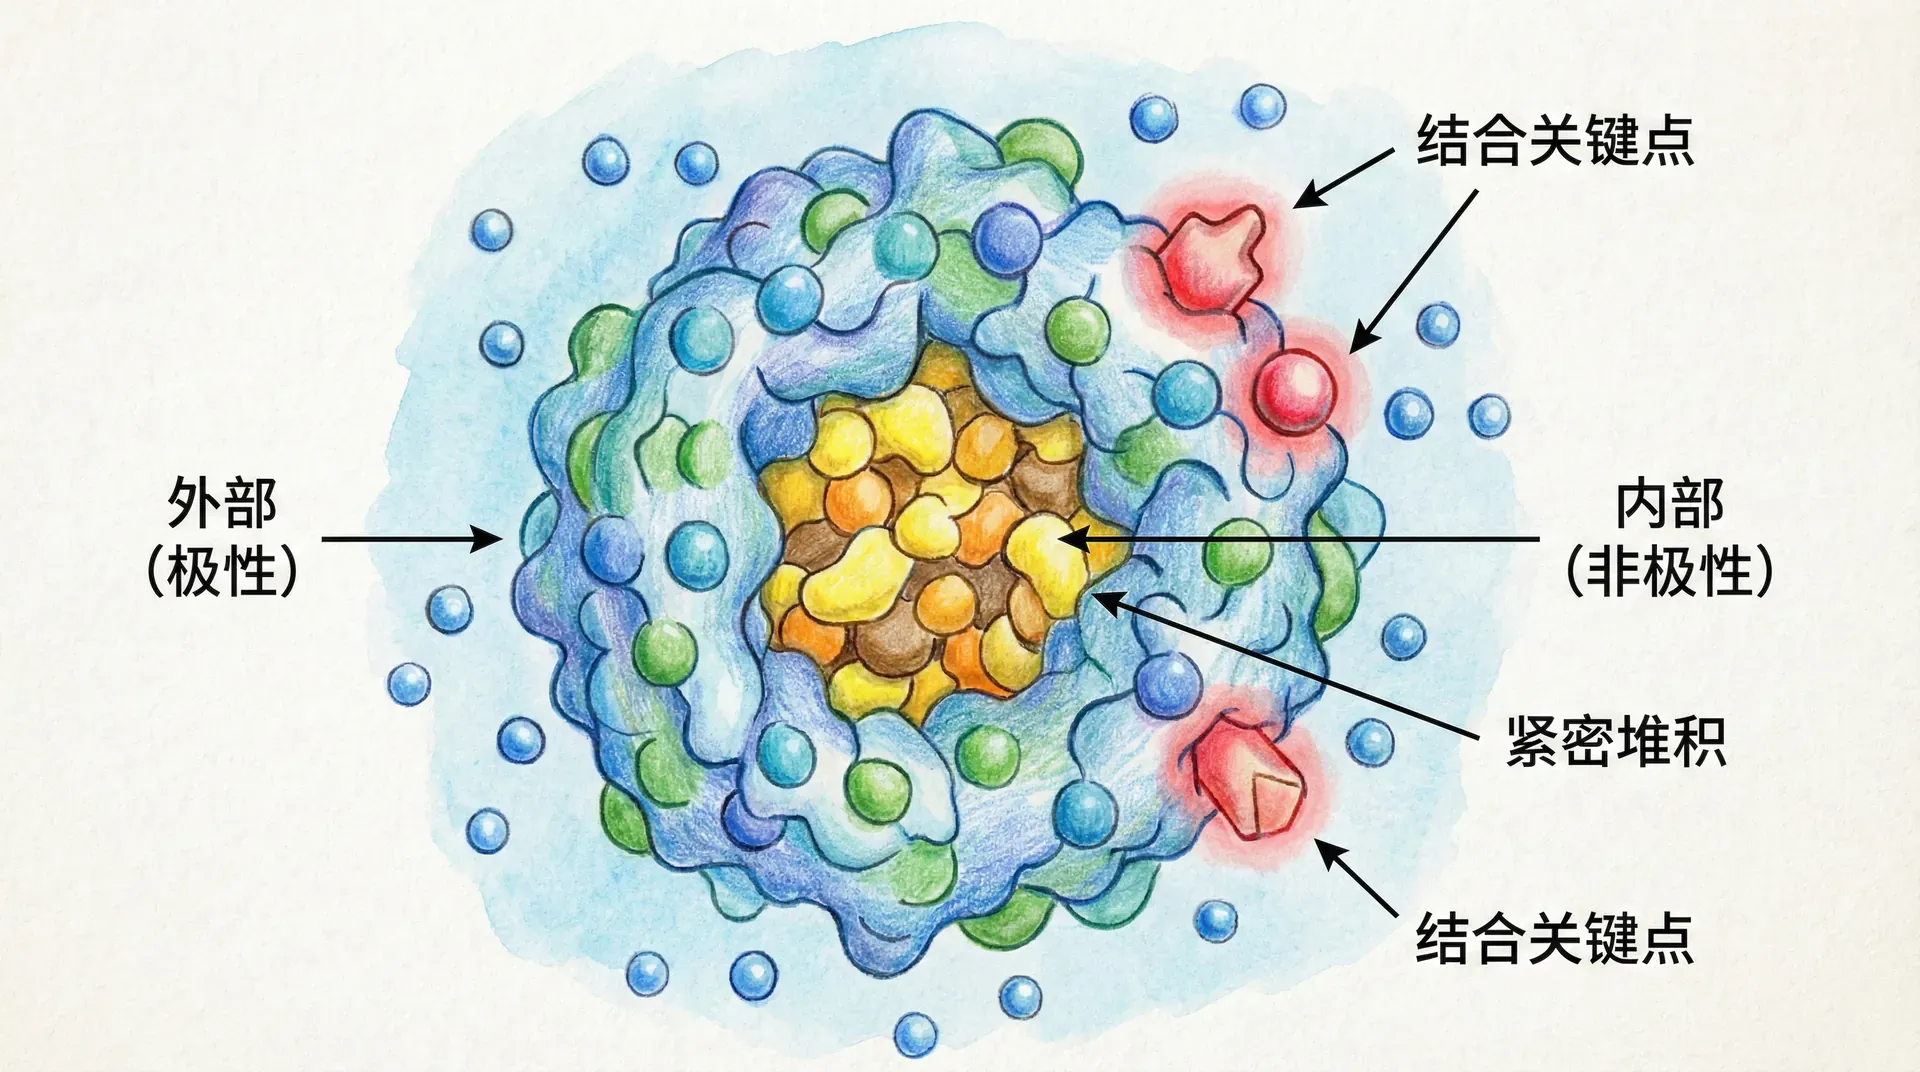
结合能在界面上的分布
蛋白质结合界面可能包含许多接触,但不同残基对结合自由能的贡献并不均匀。把某残基替换为丙氨酸后若亲和力显著降低,常把它称为热点。热点描述的是特定复合物和实验条件中的能量贡献,不等于该残基独自决定全部特异性。
热点残基的关键特征和作用:
- 结构位置: 热点常位于较好包埋的界面区域,并与邻近残基和水共同形成接触网络。
- 实验判定: 丙氨酸扫描测量突变前后的结合自由能差,阈值是研究约定而非自然界统一界线。
- 保守性: 重要热点有时较保守,但功能可由不同残基组合实现,保守性不能替代实验。
- 分布: 结合能通常不均匀,却没有适用于所有界面的“50%—75%”固定比例。
下方是热点残基在能量贡献上的“不均匀性”图表:
图中若以柱高表示残基贡献,应理解为某个假设或测量示例。蓝、红分类依赖所选阈值,数值也会随突变方法、温度和模型改变,不能推广为所有蛋白界面的通用分布。
热点残基在疾病和药物设计中的意义
- 疾病关联: 界面突变可能改变DNA或蛋白结合,也可能先破坏整体折叠。p53常见热点突变包含直接影响DNA接触和破坏结构稳定两类,需要分别解释。
- 药物设计: 小分子或肽可占据界面上的可成药口袋,但大而平的界面仍具挑战。
- 蛋白工程: 结构预测可提出候选热点,最终仍需突变与结合实验验证。
热点分析把复杂界面缩小为可实验检验的残基集合,但它只说明哪些替换显著改变结合。若要解释选择性,还需比较同一突变对目标与非目标复合物的影响,并排除突变造成蛋白整体失稳。
DNA序列识别的分子机制
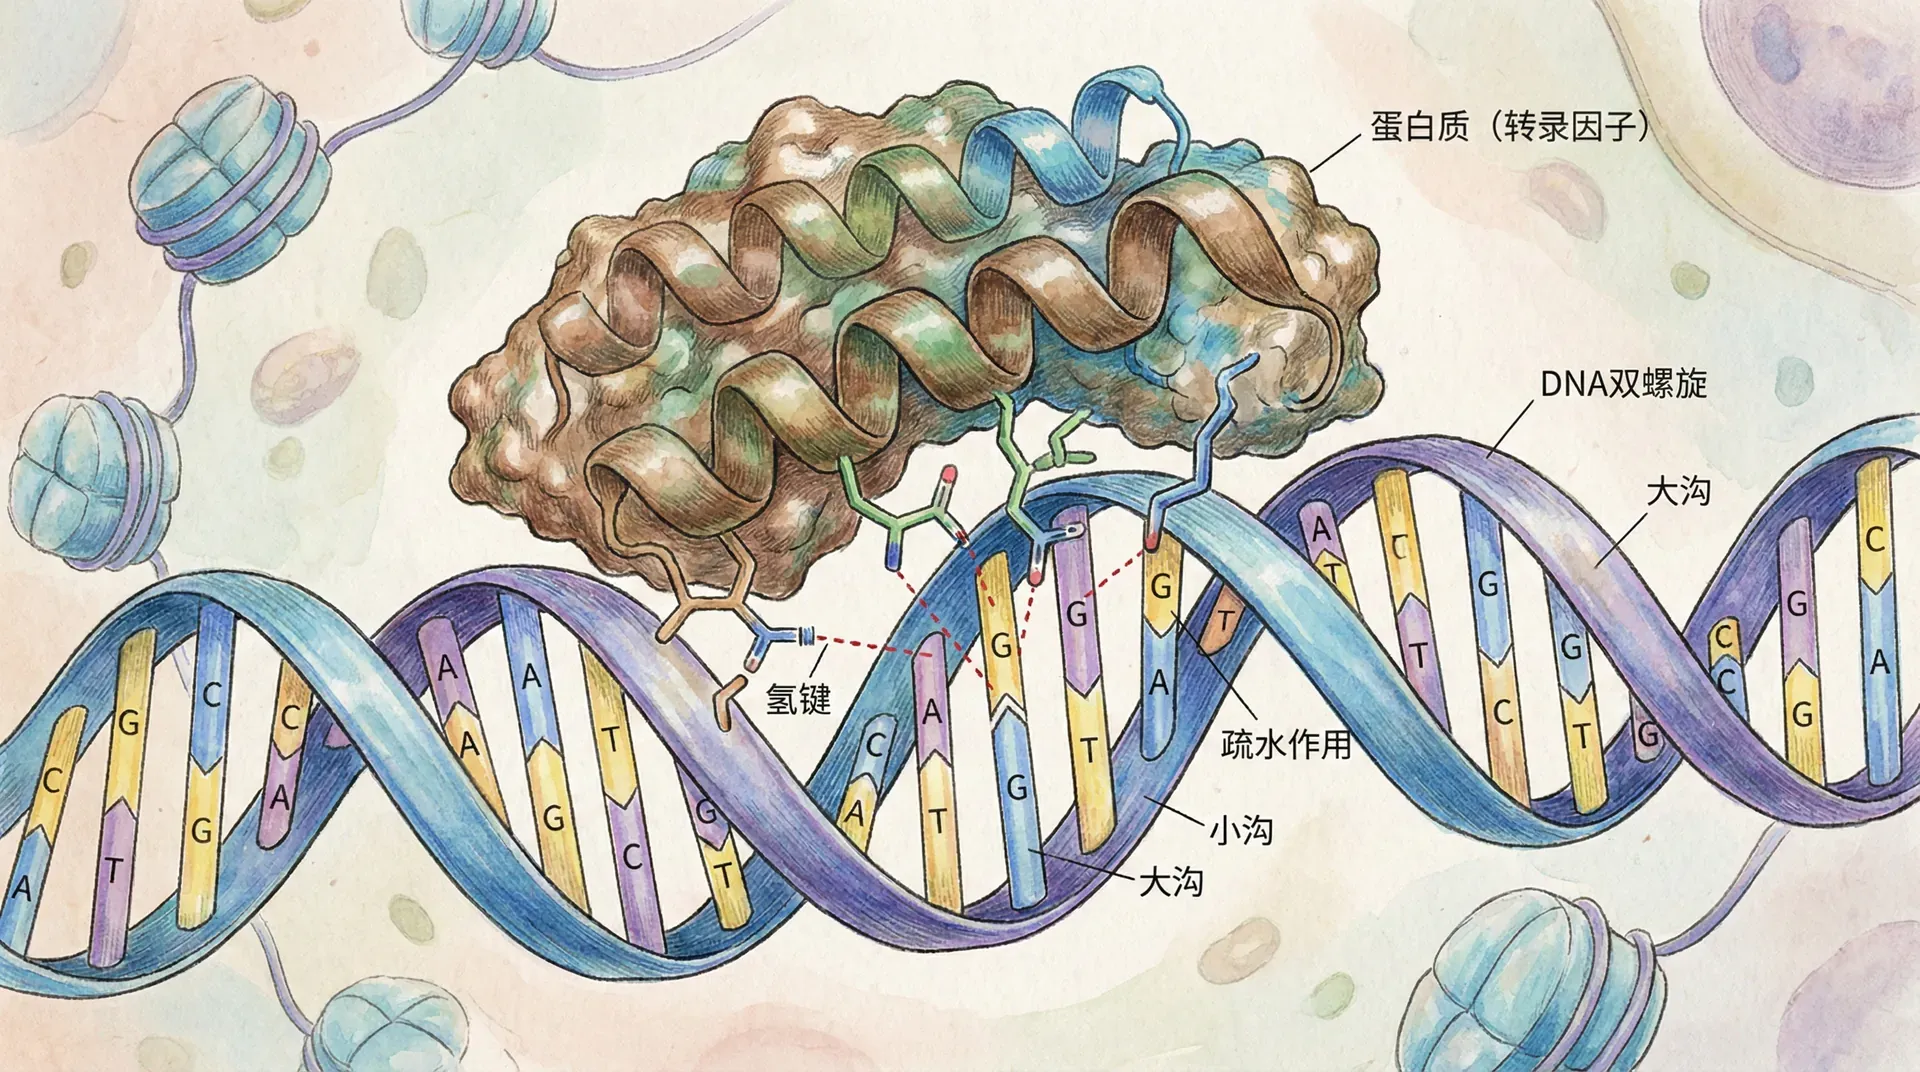
DNA结合蛋白读取碱基在沟槽中暴露的化学图案,也感受小沟宽度、弯曲倾向和局部柔性。序列既改变直接可接触的供体、受体和疏水表面,也改变DNA形状,因此“碱基代码”和“形状读取”往往同时发生。甲基化等碱基修饰还能改变沟槽化学和结合蛋白招募,使相同基本序列处在不同调控状态。
直接接触与构象诱导
转录因子识别特定DNA序列的机制,是分子生物学中最精巧和高度特异的分子识别之一。这种识别主要通过两种互补机制联合作用:
直接接触机制
氨基酸侧链伸入DNA大沟或小沟,可与碱基边缘直接形成氢键和范德华接触,也会与磷酸骨架产生静电作用。大沟通常提供更容易区分的碱基对化学图案,但并非所有蛋白都按逐个碱基的方式读取。
锌指、螺旋—转角—螺旋和亮氨酸拉链等模块采用不同几何接触DNA。某些串联锌指可让相邻手指识别连续短序列,但蛋白不是沿DNA“逐字扫描”;它先通过扩散和非特异接触寻找,再在合适序列形成稳定复合物。
构象诱导机制
结合时蛋白与DNA都可能调整构象,这称为诱导契合;另一种互补视角是构象选择,即结合伙伴先从已有构象集合中选择相容状态。非目标序列也可能短暂结合,只是自由能或寿命不同,因此识别不是绝对不会犯错的锁钥。
此外,构象变化还为生物系统提供了动态调控窗口——如某些转录因子在细胞受到刺激后才改变空间结构,只有那时才能识别DNA启动子,因而系统灵活应对外界变化。
水分子的特异性贡献
界面水可以桥接蛋白侧链与DNA碱基或骨架,也可以在结合时被排出并贡献有利熵变。哪些水分子稳定、哪些快速交换,要靠高分辨率结构、溶剂同位素效应或热力学实验判断,不能把水统一视为固定桥梁。
水介导接触在某些复合物中很重要,但不存在“超过30%的特异性由水实现”的普遍比例。特异性是多个竞争复合物自由能的比较,无法仅按结构图上水桥数量分摊。
水介导识别的分子优势主要体现在:
TATA结合蛋白识别DNA时会插入疏水残基并显著弯曲DNA,直接接触、DNA形状和水合变化共同参与。若要断言某个水分子决定选择性,需要比较突变、不同序列和结合热力学,而不能从一张静态结构图直接推出。
二聚化与特异性增强
协同效应的数学基础
转录因子二聚化可让两个DNA结合结构域同时接触相邻半位点,从而对序列、间距和方向同时提出要求。多价结合提高总体亲合力的程度,取决于单个位点自由能、连接几何和局部浓度。
若两个接触完全独立且几何预组织良好,选择优势有时近似相乘;真实二聚体还存在构象熵、协同性和部分占据状态,所以不能普遍写成。更稳妥的做法是列出各占据状态并计算总自由能或结合多项式。
下方图表展现了这一协同增长模式:
图中的指数曲线只代表理想独立模型。设计多聚化蛋白时,增加模块可能提高亲合力,也可能增加非特异黏附、聚集或错配,因此需要实测选择性而不能只按模块数外推。
实际生物系统中的例子
寡聚化参与许多转录调控,但每个系统的作用不同:
- p53: 四聚体识别包含两个半位点的响应元件;具体序列、染色质环境和辅因子决定转录输出,不能给出通用“数千倍区分率”。
- STAT蛋白: 磷酸化促进二聚并入核,不同STAT二聚体偏好不同DNA序列和伙伴。
- 核受体: 可形成同源或异源二聚体,响应元件的半位点方向与间距参与选择。
调节寡聚状态可以改变DNA占据和转录输出,也可能影响蛋白稳定、核定位与降解。因此疾病突变或人工改造的后果需要从多条路径区分,不能把所有变化都归因于选择性。
DNA识别由直接接触、DNA形状、水合、构象变化、寡聚化和竞争共同产生。越接近细胞环境,越需要把染色质可访问性、局部浓度和结合动力学纳入分析。体外测得的高亲和力若对应位点在核小体内部不可访问,细胞内仍可能几乎不占据;反过来,协同因子和开放染色质也可放大较弱结合的功能。
总结
亲和力回答“一对分子结合多强”,选择性回答“在给定备选对象和浓度下更偏向谁”。比值可描述一项具体比较,却不是唯一指标;占据率、结合寿命和细胞定位也可能决定功能结果。
多结构域和多价结合可以同时读取修饰、序列和空间关系,热点残基则说明界面能量贡献常不均匀。蛋白—DNA识别还会利用DNA形状与水合。这些机制提供的是可组合的约束,而不是绝对不会误配的身份系统。
二聚化不保证选择性按指数增长,低浓度也不自动保证正确识别。可靠判断需要把目标、竞争者、浓度、自由能和几何状态放入同一模型,再用突变、结合和细胞功能实验检验。若不同方法给出的选择性排序不一致,还应检查它们测量的是平衡占据、结合速率、停留时间还是下游输出。 这种分层比较能把结构上的“像是互补”转化为可重复的定量结论。