奇异值分解与综合应用
上一章,我们把一个向量投影到子空间里,找到了“离目标最近”的向量;最小二乘也因此变成了一个很清楚的几何问题:精确解够不到,就在列空间里找最近的点。
这一章把问题反过来问。给定一个任意矩阵 A,能不能在输入空间里挑一组互相垂直的方向,让它们经过 A 以后,在输出空间里仍然互相垂直?如果能,矩阵最擅长拉伸哪个方向,彻底压没了哪些方向,又该怎样用少数几个方向近似整个矩阵?
奇异值分解给出的答案是:能,而且每个实矩阵都能这样做。它把一个看起来杂乱的线性变换,拆成“换到合适的输入坐标—分别缩放—换到合适的输出坐标”三步。后面的图像压缩、主成分分析、推荐和降噪,都是这幅结构图的不同用法。
SVD 最值得记住的不是三个字母,而是它回答的三个问题:输入空间里的主方向是什么,矩阵沿每个方向放大多少,结果落在输出空间的哪个方向。
先看图:单位球为什么会变成椭球
设 A 是一个 m×n 实矩阵。它接收 n 维向量,输出 m 维向量:
A:Rn⟶Rm
先把输入空间里所有长度为 1 的向量放在一起。在二维里,它们围成单位圆;在三维里,它们组成单位球面;更高维时,我们仍然把这组向量叫作单位球面。
把这些向量全都送进 A,输出通常不再组成球面。某些方向被拉得很长,某些方向被压短,于是结果变成一个椭圆或高维椭球。如果矩阵把某个方向完全压成零,椭球还会“塌下去”:二维圆可能被压成一条线,甚至一个点。
SVD 就是在给这只椭球找主轴。它写成:
A=UΣVT
对输入向量 x 来说,真正的作用顺序要从右往左读:
Ax=U(Σ(VTx))
这三步各做一件事。
- VT 先把 x 换到一套特殊的输入坐标中。它只旋转或反射,不改变长度和夹角。
- Σ 沿互相垂直的坐标轴分别缩放。每条轴的缩放倍数就是一个奇异值。
- U 把缩放后的结果旋转或反射到输出空间里的最终方向。
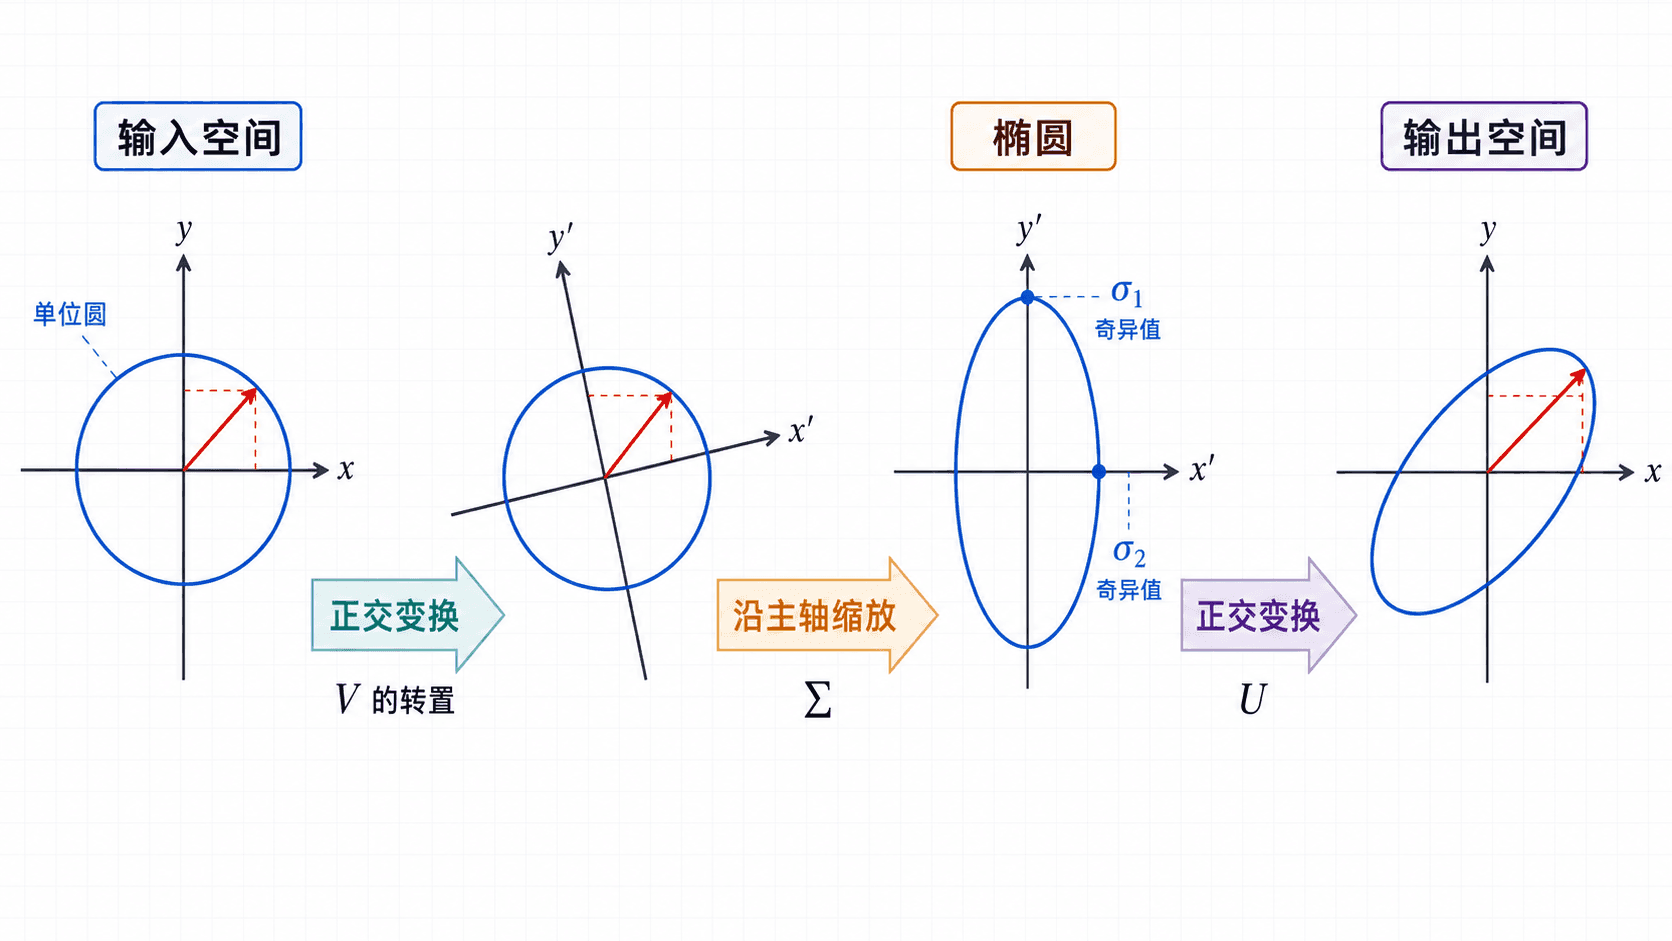
形状真正发生变化的地方是 Σ;VT 和 U 只改变朝向。
第一次看这张图时,很容易冒出一个疑问:既然单位圆转过以后还是单位圆,第一步 VT 有什么用?它的作用不是把圆变出新形状,而是给圆上的每个输入方向重新编号。这样,到了 Σ 那一步,最应该拉长的方向正好对准第一根坐标轴,第二重要的方向对准第二根坐标轴,缩放就可以用对角矩阵完成。
把 U 和 V 一律说成“旋转矩阵”并不严谨。正交矩阵的行列式可能是 −1,这时还含有反射。对 SVD 来说,真正需要的性质是保持长度和夹角。
每个符号住在哪个空间
SVD 最容易出错的地方不是计算,而是维数。我们先把每个矩阵的尺寸钉牢。
完整 SVD
如果 A 是 m×n,完整 SVD 的尺寸是:
m×n
U 的列是输出空间 Rm 的一组标准正交基,V 的列是输入空间 Rn 的一组标准正交基。也就是说:
UTU=UUT=Im
VTV=VVT=In
Σ 是矩形对角矩阵。设 A 的秩是 r,它的正奇异值按从大到小排列为:
σ1≥σ2≥⋯≥σr>
那么 Σ 的前 r 个对角位置放这些数,其余位置全是 0。可以把它想成:矩阵真正保留下来的独立通道只有 r 条。

完整 SVD 会把输入空间和输出空间的正交基都补齐,包括被压成零的方向。
右奇异向量、左奇异向量和奇异值
把 V 和 U 的列分别记作:
V=[v1v
U=[u1u2
对每个正奇异值,都有:
Avi=σiui,1≤i
这句话可以直接读成一个动作:把输入空间里的单位方向 vi 喂给矩阵,输出落在 ui 方向上,长度变成 σi。
“左”和“右”不是方向名称,只是它们在 A=UΣVT 中分别出现在 A 的左边和右边。判断时更可靠的办法是看空间:vi 有 n 个分量, 有 个分量。
薄 SVD 把零通道删掉
完整 SVD 适合解释整个输入、输出空间,但很多计算只需要正奇异值对应的部分。把这些列收在一起:
Ur=[u
再令:
Σr=diag(σ1,…,σr)
就得到本章所说的薄 SVD,也常叫紧致 SVD 或约化 SVD:
m×n
它没有近似,仍然精确等于 A,只是把所有乘上 0 的方向删掉了。
有些软件把“薄 SVD”用于另一种尺寸:令 p=min(m,n),保留 U 和 V 的前 p 列,即使其中还含有零奇异值。这种形式也叫经济型 SVD。术语可能因软件而异,所以实际使用时不要只看“thin”这个名字,要直接检查返回矩阵的尺寸。
SVD 把四个基本子空间摆在同一张图里
前面学过的四个基本子空间,在 SVD 中都有现成的标准正交基:
C(AT)=span{v1,…,vr}
N(A)=span{vr+1,…,vn}
C(A)=span{u1,…,ur}
N(AT)=span{ur+1,…,um
前两式把输入空间拆成行空间和零空间;后两式把输出空间拆成列空间和左零空间。A 在行空间上把 vi 送到 σiui,在零空间上则什么都留不下:
Avi=0,i>r
这就是秩的几何含义。秩不是矩阵里某个孤立的数字,它数的是“没有被压没的独立输入方向”。
奇异向量通常不唯一。把同一对 ui,vi 同时乘以 −1,分解不变;如果几个奇异值相同,还可以在对应子空间里换另一组标准正交基。稳定的是那个子空间,不一定是某一支箭头的朝向。
为什么要看 ATA
现在来回答最关键的计算问题:这些特殊的输入方向 vi 到底从哪里找?
从关系 Avi=σiui 出发,左乘 A:
ATAvi=σiATu
而 SVD 同时给出:
ATui=σivi
于是:
ATAvi=σi2vi
所以,右奇异向量 vi 是 ATA 的单位特征向量,奇异值 σi 是对应特征值的非负平方根。
这条路之所以总能走通,是因为 ATA 有两个很好的性质。第一,它是对称矩阵:
(ATA)T=ATA
第二,它是半正定矩阵。对任意 x:
xTATAx=(Ax)T(Ax)=∥Ax∥
因此,ATA 的特征值都是非负实数,而且能选出一组标准正交特征向量。输入主方向就这样出现了。
同理:
AATui=σi2ui
所以 AAT 给出左奇异向量。手算时,通常只解 ATA,再用下面的式子求 ui:
ui=σiAvi
这个式子只适用于 σi>0。奇异值等于 0 时不能除以它;完整 SVD 中剩余的 ui 要从 N 里另选标准正交基补齐。
手算一个不靠猜的 SVD
来看这个矩阵:
A=[3405]
我们不先猜它把圆变成什么椭圆,而是沿着 ATA 一步步算。
先计算 ATA:
这个例子把“长轴方向”说得很具体:单位圆上沿 v1 输入时,输出长度是 35;沿与它垂直的 v 输入时,输出长度只有 。 对应椭圆主轴在输入端的方向, 是主轴在输出端的朝向。
一个秩亏矩形矩阵会发生什么
再看:
B=1101
它的两列相同,所以秩只有 1。唯一的正奇异值以及对应方向可以取为:
σ1=2,v1
薄 SVD 只有这一条通道:
B=2u1v1T
与 v1 垂直的方向:
v2=2
满足 Bv2=0,所以它张成 N(B)。输出空间里,还要用两个方向补齐 U,例如:
u2=2
它们张成 N(BT)。完整 SVD 会保留这些零通道,薄 SVD 则只留下真正传递信息的 u1,σ1,v。
ATA 很适合推导和小矩阵手算,但大型数值计算通常不会先显式形成它。这样做会把条件数平方,使舍入误差更明显。成熟的 SVD 算法会用正交变换先把矩阵化到更简单的形状,再迭代求奇异值。
回到最小二乘:伪逆把投影写成坐标
上一章的最小二乘是在列空间里找离 b 最近的向量。SVD 给列空间一组标准正交基 u1,…,ur,于是这次投影几乎不用解方程:先计算 b 在每个 上的坐标,再把坐标除以对应的拉伸倍数,最后沿 方向拼回输入。
把正奇异值逐个取倒数:
Σr−1=diag(σ1
定义 Moore–Penrose 伪逆:
A+=VrΣr−1Ur
那么:
x^=A+b
给出一个最小二乘解。若 A 列满秩,它和法方程得到的解相同;若 A 不列满秩,最小二乘解不止一个,A+b 会选其中长度最小的那个。
为什么“小奇异值”会让问题变得敏感,也在这个式子里一眼可见。b 在 ui 方向上的微小扰动,求解时会被乘上 1/σi。如果 σ 很小,噪声就可能被大幅放大。
对列满秩矩阵,常用下面的比值衡量这种拉伸差距:
κ2(A)=σrσ1
κ2(A) 越大,说明不同方向的缩放越不均衡,反推输入时越容易受误差影响。奇异值等于 0 时,信息已经彻底丢失,逆变换不存在;数值上“非常接近 0”时,虽然理论秩可能没变,实际计算也常把它视为几乎不可恢复的方向。
低秩近似:为什么保留前几层最好
把薄 SVD 展开,可以把矩阵写成若干个秩一矩阵之和:
A=σ1u1v1T
单独看第 i 层:
σiuiviTx=σ
它先问输入 x 在 vi 方向上有多少,再把这个数乘以 σi,最后把结果放到 u 方向。因此,每一层都是一条“输入方向—强度—输出方向”的通道。
只保留前 k 层:
Ak=i=1∑kσi
Ak 的秩不超过 k。它不是随手删掉几层得到的近似,而是在所有秩不超过 k 的矩阵中,对 A 最好的近似。
这里的“最好”需要先说明怎么量误差。谱范数看矩阵对单位向量可能造成的最大误差:
∥M∥2=∥x∥=1max∥Mx∥
Frobenius 范数则把所有矩阵元素的平方加起来:
∥M∥F=i,j∑m
Eckart–Young 定理给出:
∥A−Ak∥2=σk+1
∥A−Ak∥F=σ
而任何秩不超过 k 的矩阵 B 都不能得到更小的这两种误差。
直觉上,Ak 已经把最强的 k 条正交通道全留下了。任何只有 k 个独立输出方向的近似,都不可能同时接住前 k+1 个互相垂直的主方向,至少会漏掉强度为 σ 的那一档。SVD 截断恰好把损失压到这个下界。
在 Frobenius 范数下,如果 σk>σk+1,最佳秩 k 近似是唯一的;若截断位置碰上相同奇异值,最佳近似可能不止一个,因为那个等强度子空间里没有唯一的优先方向。谱范数只盯住最大的剩余误差,可能允许别的最优解,但 SVD 截断始终是其中一个。
人们常计算下面的比例:
ρk=σ12+⋯+σ
它准确表示“保留了多少 Frobenius 平方能量”。在 PCA 中,它也对应解释方差比例。但离开具体问题后,不要把它直接说成“保留了多少语义”或“保留了多少有用信息”:细小文字、罕见异常和尖锐边缘的能量可能不大,业务上却可能很重要。
应用前先说清楚矩阵怎样构造
SVD 不知道一行像素代表什么,也不知道一格空白评分是不是零。它只看见一张数表。因此,每个应用都应该从“行、列和缺失值分别代表什么”讲起,再讨论奇异值。
图像压缩:像素矩阵的低秩近似
一张 m×n 的灰度图可以写成矩阵 G,第 i 行第 j 列的数是对应像素亮度。对 G 做 SVD,并保留前 k 层:
Gk=UkΣkVk
原始矩阵要存 mn 个亮度数。若直接保存低秩因子,则大约要存:
mk+k+nk=k(m+n+1)
个数,分别来自 Uk、Σk 的对角线和 Vk。只有当 足够小,这个计数才比 少。
为什么照片经常能被低秩近似?因为相邻像素和相邻行列通常有很强的相关性。大片天空、墙面和缓慢变化的明暗,不需要每个像素都独立描述。前几层先抓住这些大范围结构,后面的层再补边缘、纹理和细字。
彩色图像不能把红、绿、蓝三个通道混成一张灰度矩阵。最直接的做法是分别对三个通道做低秩近似,再合成颜色。实际文件还要考虑量化、元数据和编码开销,所以 k(m+n+1) 只是“保存浮点因子数量”的比较,不能直接当成 PNG 或 JPEG 的最终字节数。SVD 也不保证比成熟的图像编码格式更省。
PCA:先中心化,再找变化最大的方向
设数据集中有 m 个样本、n 个特征。我们约定每行是一个样本,每列是一个特征,得到数据矩阵 X∈Rm×n。
PCA 之前要先对每一列减去它的均值。把中心化后的矩阵记作 Xc:
(Xc)ij=Xij−
对它做 SVD:
Xc=UΣVT
因为样本放在行里,V 的列才是特征空间中的主成分方向。样本在前 k 个主方向上的新坐标,也叫主成分得分,是:
Z=XcVk=UkΣ
这和协方差矩阵的特征分解完全一致:
m−11XcTXc
所以第 i 个主成分的样本方差是:
m−1σi2
前 k 个主成分有两个等价的“最佳”解释:它们让投影后的总方差最大,也让从 k 维投影重建回原数据时的平方误差最小。
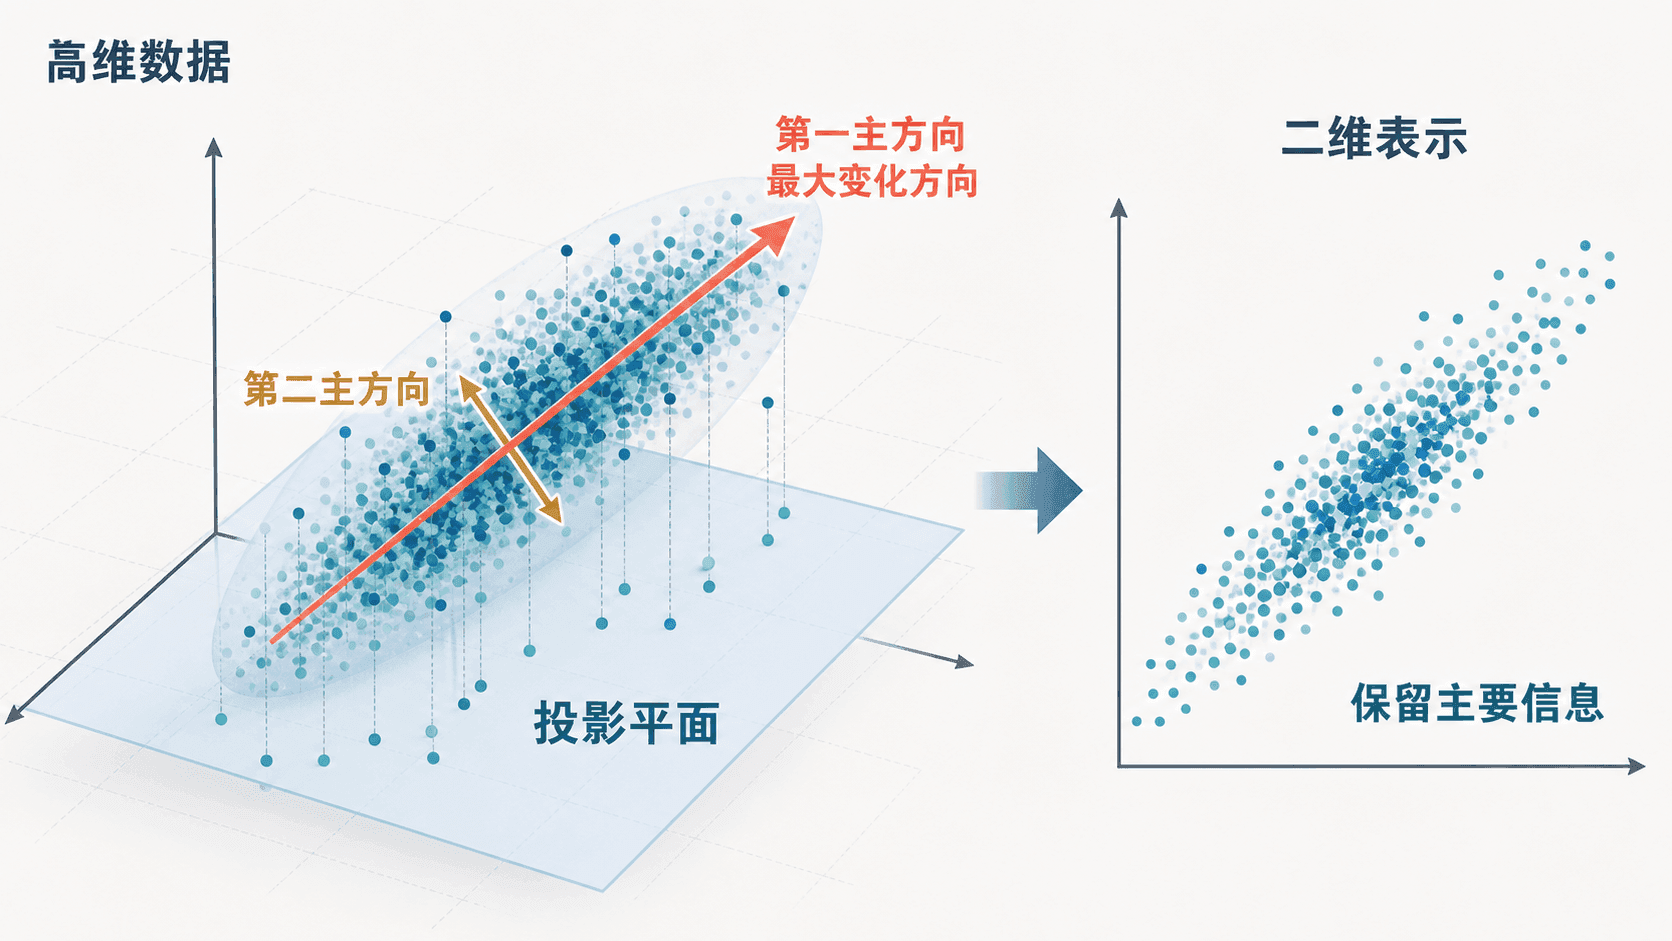
PCA 保留的是线性方向上的主要变化,不是对数据含义的自动理解。
PCA 能说明某些线性组合承载了较大的样本方差,却不能单凭这一点推出因果关系,也不能保证“大方差方向”就是预测任务最有用的方向。若不同特征的单位相差很大,例如一列用元、一列用毫米,是否先标准化会显著改变结果;这要由问题语境决定。弯曲流形等非线性结构,也可能无法用少数线性主方向展开。
若把样本存成列、特征存成行,上面的 U 和 V 会交换角色。这再次说明:记结论前先确认矩阵是怎样构造的。
推荐系统:缺失评分绝不是零分
设 R 是用户—物品矩阵,行表示用户,列表示电影、课程或商品。rij 可以是评分,也可以是经过定义的点击强度。现实里,大多数格子没有被观察到,因为用户只接触过少量物品。
低秩模型为每个用户分配一个 k 维向量 pi,为每个物品分配一个 k 维向量 qj,用点积预测:
rij=piTq
把所有用户向量放进 P,把所有物品向量放进 Q,预测矩阵就是:
R=PQT
它的秩不超过 k。但这里通常不能把空白格填成 0 后直接做普通 SVD。空白表示“没观察到”,而 0 可能表示明确不喜欢,两者不是一回事。常见做法是只在已观察集合 Ω 上拟合:
P,Qmin(i,j)∈Ω∑
正则项限制因子不要为了追逐少量评分而变得过大。真实模型还常加入用户偏置、物品偏置、时间和上下文。
交互中的因子是为了展示“点积怎样得到一格预测”的虚构数值,不代表这些因子已经从表中训练出来。即使模型确实从数据学到了潜在因子,也不能自动把每一维命名成“悬疑偏好”或“价格敏感度”;因子可以旋转而不改变乘积,语义解释需要额外证据。新用户、新物品没有历史记录时,低秩分解也会遇到冷启动问题。
去噪:先要有“信号近似低秩”的理由
设观测矩阵是:
Y=S+N
S 是希望保留的结构,N 是噪声。如果 S 主要集中在少数奇异方向,而噪声较分散,那么截断 SVD:
Yk=i=1∑kσi
可能同时完成压缩和降噪。图像可以直接按像素排成矩阵;多次传感器实验可以让每行代表一次实验、每列代表一个采样时刻;一维语音或时间序列若想用低秩结构,往往要先把重叠时间窗排成矩阵,而不是把一个长向量直接做 SVD。
“小奇异值都是噪声”不是定理。细小但真实的纹理、短暂尖峰和少数群体的模式,也可能落在小奇异值中;周期条纹、背景漂移等结构化噪声反而可能产生大奇异值。k 应结合奇异值谱的间隙、独立验证数据、残差形态和领域需求选择,不能只看一个固定的能量比例。
低秩近似给的是数学上最小的平方误差,不是自动正确的业务判断。应用结论必须依赖“重要结构确实集中在少数线性方向”这个前提。
综合例题:只看奇异值谱能读出什么
设 A 是一个 6×5 矩阵,非零奇异值为:
9,3,1,0.2
我们不需要知道 A 的每个元素,也能读出很多结构。
正奇异值有 4 个,所以:
rank(A)=4由秩—零度关系:
dimN(A)=这个例子也说明奇异值谱为什么有用:秩看正奇异值的个数,数值稳定性看最大值与最小正值的比,低秩近似误差看截断后的尾部。它们不是四个分开的技巧,而是同一串数的不同读法。
练习
练习一:完整与薄 SVD 的尺寸
设 A 是 7×4 矩阵,秩为 3。写出完整 SVD 和薄 SVD 中各因子的尺寸,并求 dimN(A) 与 dimN(A。
完整 SVD 为:
A=UΣVT尺寸是:
(7×4)=(7×7)(练习二:从 SVD 读四个子空间
设:
A=UrΣrVrT
是秩为 r 的薄 SVD。说明 Ur、Vr 的列分别张成哪个子空间;完整 SVD 中剩余的列又分别张成哪个子空间。
Vr 的列是有正奇异值的输入方向,因此张成行空间:
C(AT)Ur 的列是这些方向经过 后的输出方向,因此张成列空间:
练习三:手算一个交换与缩放矩阵
设:
A=[0230]
求它的一组 SVD,并说明三个因子的动作顺序。
先算:
ATA=[4009]练习四:最佳秩一近似的两种误差
某矩阵的非零奇异值为:
7,2,0.5
求最佳秩一近似的谱范数误差、Frobenius 误差和保留的 Frobenius 平方能量比例。
最佳秩一近似保留 7。谱范数误差是下一个奇异值:
∥A−A1∥2=2Frobenius 误差是:
练习五:图像低秩因子的存储量
一张 1200×800 灰度图用秩 k=30 的 SVD 因子保存。按浮点数个数估算,需要保存多少个数?占原始像素数的大约百分之几?
需要保存 Uk、30 个奇异值和 Vk:
30(1200练习六:PCA 为什么要中心化
某数据集的一列是身高,数值都在 170 厘米附近,另一列是相对基准线的左右偏移,均值接近 0。如果不中心化就直接做 SVD,可能出现什么问题?
不中心化时,身高列中接近 170 的共同偏移会贡献很大的平方能量。第一奇异方向可能主要指向“数据离原点很远”,而不是“样本围绕平均值怎样变化”。
PCA 关心的是样本相对均值的变化,所以应先对每个特征减去列均值。中心化后,主方向才对应协方差和样本方差。是否进一步除以标准差,则取决于厘米、元等量纲差异是否应该被消除。
练习七:能不能把未评分当作零
用户—电影矩阵中,某用户没有看过电影甲。建模时能不能把这个空白格直接填成 0,再对整个矩阵做普通 SVD?
通常不能。空白只表示“没有观察”,不表示用户明确给了零分。若全部填成 0,模型会把大量未知项误当成强烈负反馈,学到的低秩结构会被这些假数据主导。
更合理的做法是只在已观察评分上计算损失,拟合用户因子和物品因子,并用正则化限制过拟合。若业务中 0 确实是一个被观察到的有效值,也要把“观测掩码”和数值本身分开保存。
练习八:小奇异值一定是噪声吗
某张医学图像中的微小病灶只占很少像素,对应的奇异值也比较小。能不能因为它“能量小”就直接在降噪时删掉?
不能只凭奇异值小就删除。SVD 能说明这一层对整体平方能量贡献小,却不知道这层结构在诊断上是否重要。微小病灶可能正是任务关心的信号。
选择截断位置时,应结合独立标注、重建残差的位置、任务指标和领域知识。若目标是诊断,评价标准也不应只用整幅图的平均平方误差。
把全课程收成一条可复用的路线
学完这一章后,遇到一个新矩阵,可以不急着套公式。先沿着“方程—空间—变换—分解”走一遍,问题通常会自己暴露出适合的工具。
第一步永远是把对象翻译成矩阵:行和列分别代表什么,输入和输出各有几维,空白是不是零。尺寸写清楚,很多错误会在计算前就被发现。
第二步看空间。C(A) 告诉你哪些输出够得到,N(A) 告诉你哪些输入变化完全看不见;秩数出真正有效的通道。若问题是最小二乘,还要看 N(AT),因为残差必须落在那里。
第三步把矩阵当作动作。问它保持什么、拉伸什么、压没什么。方阵的特征向量寻找“方向不转”的特殊情况;SVD 则允许输入方向和输出方向不同,因此适用于任意矩形矩阵。
最后才选择分解。分解不是把一个矩阵拆得更复杂,而是在挑最适合当前问题的坐标:消元把方程变容易,QR 把投影变容易,特征分解把重复作用变容易,SVD 把任意线性变换的主方向和强度排成一列。
以后再看到一张数字表,可以先写下四句话:它把什么送到什么,哪些输出可达,哪些输入会消失,哪种分解能让当前问题变简单。矩阵的计算会变,但这条思考路线可以一直复用。