联合分布、多元随机变量与相关结构
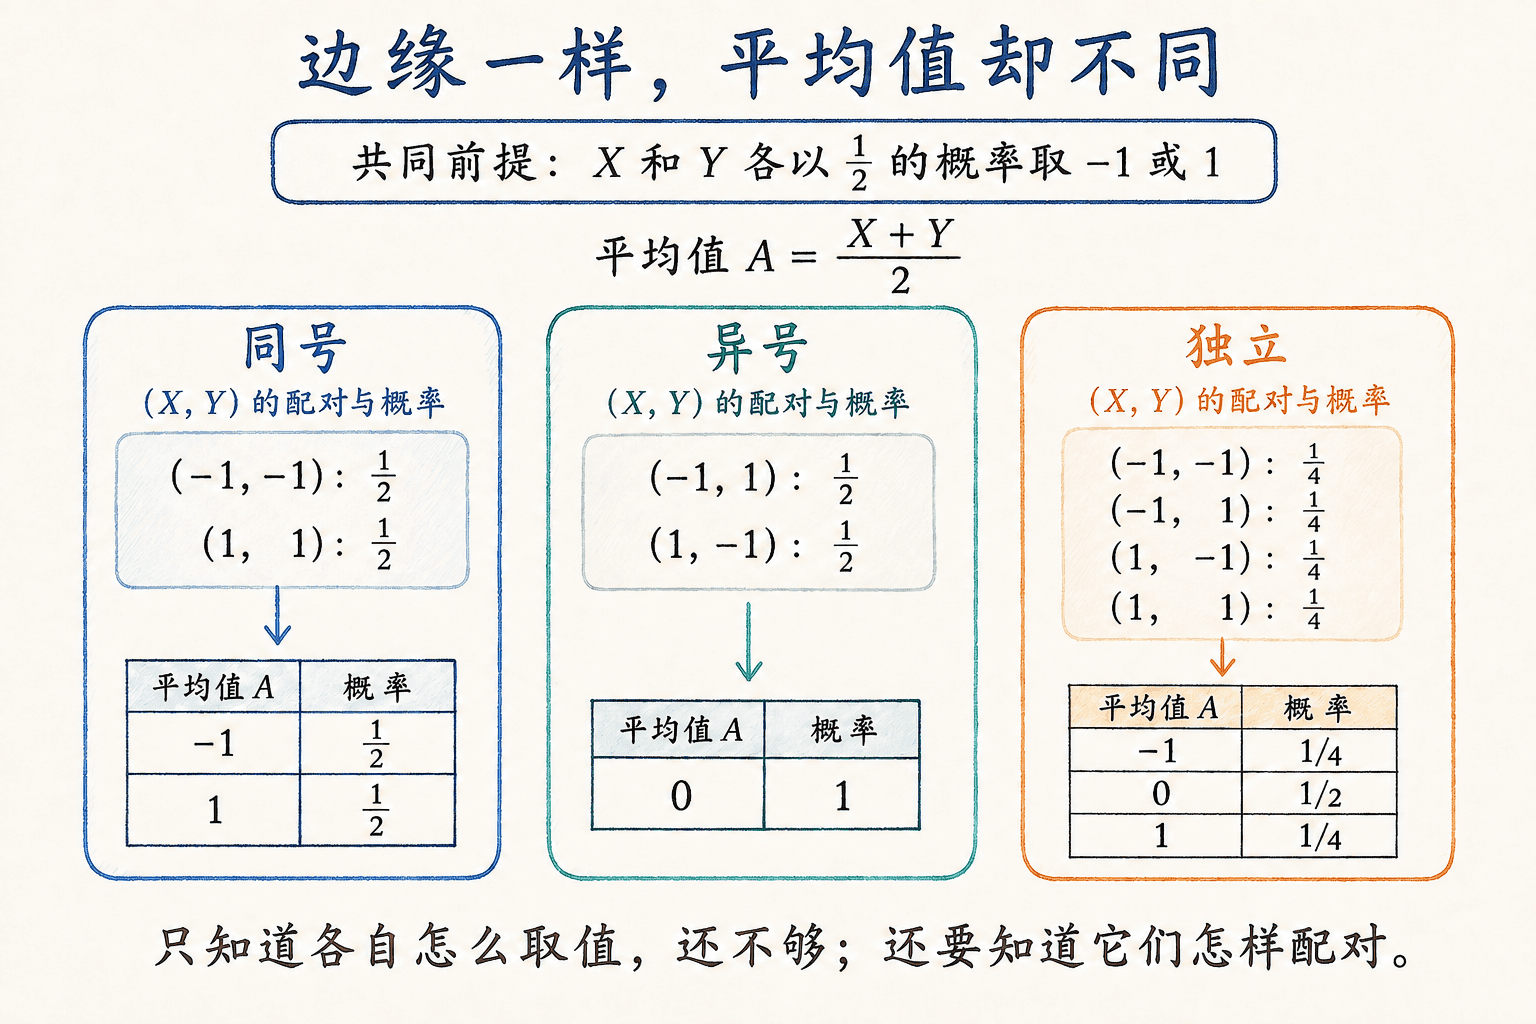
上一章里,我们把一个随机变量的分布压缩成期望、方差和矩,已经能够回答“平均在哪里”“波动有多大”。现在想象同一台设备上的两个传感器:它们的误差都以一半概率取 − 1 -1 − 1 1 1 1
还真答不了。如果两个传感器总是一起偏高、一起偏低,取平均几乎没用;如果一个偏高时另一个一定偏低,平均误差恰好为零;如果两者独立,结果又不一样。每个量各自怎样变化,并没有告诉我们它们怎样配对出现。
这一章就从这块缺失的信息讲起。先把两个数放到同一张概率表或同一片平面上,再看哪些信息会在求边缘分布时丢失、独立到底要求什么,以及协方差为什么会出现在“相加后的波动”里。前面学过的求和、积分、容斥和期望都还管用,只是这次我们必须一直留意两个变量之间的关系。
同样的两个边缘,能拼出完全不同的关系
设两个传感器的误差分别是 X X X Y Y Y
P ( X = − 1 ) = P ( X = 1 ) = P ( Y = − 1 ) = P ( Y = 1 ) = 1 2 . P(X=-1)=P(X=1)=P(Y=-1)=P(Y=1)=\frac12. P ( X = − 1 ) = P ( X = 1 ) = P ( Y = − 1 ) = P ( Y = 1 ) = 2 我们给出三种配对方式。表里的每一列是一对可能同时出现的误差,每一行是一个完整模型。
无论选哪一行,单独统计 X X X Y Y Y X + Y X+Y X + Y − 2 -2 − 2 2 2 2 0 0 0 − 2 , 0 , 2 -2,0,2
你可以把边缘分布想成两份分别整理好的名单。它保留每边有哪些数、各占多少,却没有保留“这一行的 X X X Y Y Y
严格写下来,X X X Y Y Y
Z ( ω ) = ( X ( ω ) , Y ( ω ) ) . \mathbf Z(\omega)=(X(\omega),Y(\omega)). Z ( ω ) = ( X ( ω ) , Y ( ω )) . 对同一个结果 ω \omega ω ω \omega ω D D D
P ( ( X , Y ) ∈ D ) P\bigl((X,Y)\in D\bigr) P ( ( X , Y ) ∈ D ) 是多少。“两个变量定义在同一个概率空间上”也不要求它们一定由一台实际装置同时测量;数学模型可以把不同来源的随机量放到一起,但如何配对必须交代,独立只是其中一种选择。
再回到开头的传感器问题,把刚才的总误差除以 2 2 2 A = ( X + Y ) / 2 A=(X+Y)/2 A = ( X + Y ) /2
边缘分布相同,联合分布仍可不同:同号配对的平均值为 −1 或 1,异号配对的平均值恒为 0,独立配对的平均值分布为 1/4、1/2、1/4。 离散联合分布:一格一格保存配对信息
每一个格子到底装着什么
若 X , Y X,Y X , Y
p X , Y ( x , y ) = P ( X = x , Y = y ) . p_{X,Y}(x,y)=P(X=x,Y=y). p X , Y ( x , y ) = P ( X = x , Y = y ) . 逗号读作“并且”。一格概率描述同一次结果中 X = x X=x X = x Y = y Y=y Y = y 1 1 1
p X , Y ( x , y ) ≥ 0 , ∑ x ∑ y p X , Y ( x , y ) = 1. p_{X,Y}(x,y)\ge0,\qquad \sum_x\sum_y p_{X,Y}(x,y)=1. p X , Y ( x , y ) ≥ 0 , x ∑ 不可能的配对要记为零,不能因为两个坐标分别可能出现,就断言它们可以一起出现。刚才的同向误差模型就是例子:X = 1 X=1 X = 1 Y = − 1 Y=-1 Y = − 1
我们用一张稍丰富的表贯穿后面的计算。设一次观察记录的两个计数 X , Y X,Y X , Y 0 , 1 , 2 0,1,2 0 , 1 , 2
比如 p X , Y ( 2 , 1 ) = 0.20 p_{X,Y}(2,1)=0.20 p X , Y ( 2 , 1 ) = 0.20 2 2 2 1 1 1 P ( X > Y ) P(X>Y) P ( X
P ( X > Y ) = p ( 1 , 0 ) + p ( 2 , 0 ) + p ( 2 , 1 ) = 0.15 + 0.05 + 0.20 = 0.40. P(X>Y)=p(1,0)+p(2,0)+p(2,1)=0.15+0.05+0.20=0.40. P ( X > Y ) = p ( 1 , 0 ) + p ( 2 , 0 ) + p ( 2 , 1 ) = 若问两个计数相等,就沿对角线相加,得到 0.10 + 0.10 + 0.05 = 0.25 0.10+0.10+0.05=0.25 0.10 + 0.10 + 0.05 = 0.25
边缘分布为什么是“把另一个变量加掉”
现在只问 P ( X = 1 ) P(X=1) P ( X = 1 ) X = 1 X=1 X = 1 Y Y Y ( 1 , 0 ) , ( 1 , 1 ) , ( 1 , 2 ) (1,0),(1,1),(1,2) ( 1 , 0 ) , ( 1
p X ( 1 ) = 0.15 + 0.10 + 0.10 = 0.35. p_X(1)=0.15+0.10+0.10=0.35. p X ( 1 ) = 0.15 + 0.10 + 0.10 = 0.35. 同样地,
p X ( x ) = ∑ y p X , Y ( x , y ) , p Y ( y ) = ∑ x p X , Y ( x , y ) . p_X(x)=\sum_y p_{X,Y}(x,y),\qquad p_Y(y)=\sum_x p_{X,Y}(x,y). p X ( x ) = y ∑ p “边缘”这个名字就来自表格:求和结果通常写在表的下边和右边。但真正的操作是忽略一个坐标,把带着不同 y y y x x x
求函数的期望,不一定要先求函数的分布
上一章已经知道:要算 E [ g ( X ) ] E[g(X)] E [ g ( X )] g ( x ) g(x) g ( x ) X = x X=x X = x
E [ g ( X , Y ) ] = ∑ x ∑ y g ( x , y ) p X , Y ( x , y ) . E[g(X,Y)]=\sum_x\sum_y g(x,y)p_{X,Y}(x,y). E [ g ( X , Y )] = x ∑ y ∑ g 若 g g g + ∞ +\infty + ∞
表里的 E [ X ] E[X] E [ X ] g ( x , y ) = x g(x,y)=x g ( x , y ) = x y y y
E [ X ] = 0 × 0.35 + 1 × 0.35 + 2 × 0.30 = 0.95 , E[X]=0\times0.35+1\times0.35+2\times0.30=0.95, E [ X ] = 0 × 0.35 + 1 × 0.35 + 2 × 0.30 = 0.95 , E [ Y ] = 0 × 0.30 + 1 × 0.50 + 2 × 0.20 = 0.90. E[Y]=0\times0.30+1\times0.50+2\times0.20=0.90. E [ Y ] = 0 × 0.30 + 1 × 0.50 + 2 × 0.20 = 0.90. 乘积 X Y XY X Y
E [ X Y ] = 1 × 1 × 0.10 + 2 × 1 × 0.20 + 1 × 2 × 0.10 + 2 × 2 × 0.05 = 0.90. \begin{aligned}
E[XY]
&=1\times1\times0.10+2\times1\times0.20\\
&\quad+1\times2\times0.10+2\times2\times0.05\\
&=0.90.
\end{aligned} E [ X Y ] = 1 × 1 这里不能把答案直接写成 E [ X ] E [ Y ] = 0.855 E[X]E[Y]=0.855 E [ X ] E [ Y ] = 0.855 E [ X + Y ] = E [ X ] + E [ Y ] E[X+Y]=E[X]+E[Y] E [ X + Y ] = E [ X ] + E [ Y
联合密度:概率来自一片区域,而非一个点
先确认二维密度确实存在
连续型的一维分布用曲线下面积计算概率。若随机向量 ( X , Y ) (X,Y) ( X , Y ) f X , Y f_{X,Y} f X , Y
P ( ( X , Y ) ∈ D ) = ∬ D f X , Y ( x , y ) d x d y . P\bigl((X,Y)\in D\bigr)=\iint_D f_{X,Y}(x,y)\,dx\,dy. P ( ( X , Y ) ∈ D ) = ∬ D f 密度非负,整个平面的积分为 1 1 1
f X , Y ( x , y ) Δ x Δ y . f_{X,Y}(x,y)\,\Delta x\,\Delta y. f X , Y ( x , y ) Δ x Δ y . 密度是单位面积上的概率浓度,不是某一个点的概率。它可以大于 1 1 1
这里有一个必须先讲清的条件:X X X Y Y Y
取 X ∼ U ( 0 , 1 ) X\sim U(0,1) X ∼ U ( 0 , 1 ) Y = X Y=X Y = X ( X , Y ) (X,Y) ( X , Y ) y = x y=x y =
以后遇到“两个连续随机变量”,先分清题目是否给了联合密度。边缘连续、联合分布函数连续、联合分布有二维密度,是不同层次的条件。不能只看到两个一维密度,就自动开始对某个想象出来的二维密度积分。
非矩形支持区域决定了积分上下限
设联合密度为
f X , Y ( x , y ) = { 2 , 0 < x < y < 1 , 0 , 其他位置 . f_{X,Y}(x,y)=
\begin{cases}
2,&0<x<y<1,\\
0,&\text{其他位置}.
\end{cases} f X , Y ( x , y ) = { 2 , 先把区域看明白:它在单位正方形里,位于对角线 y = x y=x y = x X X X Y Y Y 2 2 2 0 < x < y < 1 0<x<y<1 0 < x < y <
检查归一化时,我们固定横坐标 x x x x x x 0 0 0 1 1 1 x x x y y y x x x 1 1 1
∫ 0 1 ∫ x 1 2 d y d x = ∫ 0 1 2 ( 1 − x ) d x = 1. \int_0^1\int_x^1 2\,dy\,dx
=\int_0^1 2(1-x)\,dx=1. ∫ 0 1 ∫ x 1 2 d y d x = 也可以固定 y y y x x x 0 0 0 y y y
∫ 0 1 ∫ 0 y 2 d x d y = ∫ 0 1 2 y d y = 1. \int_0^1\int_0^y2\,dx\,dy=\int_0^1 2y\,dy=1. ∫ 0 1 ∫ 0 y 2 d x d y = 这两个式子算的是同一片区域,切片方向不同。重积分中最容易错的往往不是积分本身,而是把三角形不知不觉算成正方形。
边缘密度是一整条切片的积分
若只关心 X X X Y Y Y
f X ( x ) = ∫ − ∞ ∞ f X , Y ( x , y ) d y . f_X(x)=\int_{-\infty}^{\infty} f_{X,Y}(x,y)\,dy. f X ( x ) = ∫ − ∞ ∞ f 对这个三角模型,固定 0 < x < 1 0<x<1 0 < x < 1 1 − x 1-x 1 − x
f X ( x ) = { 2 ( 1 − x ) , 0 < x < 1 , 0 , 其他位置 . f_X(x)=
\begin{cases}
2(1-x),&0<x<1,\\
0,&\text{其他位置}.
\end{cases} f X ( x ) = { 2 ( 1 − x ) , 同理,水平切片长度为 y y y
f Y ( y ) = { 2 y , 0 < y < 1 , 0 , 其他位置 . f_Y(y)=
\begin{cases}
2y,&0<y<1,\\
0,&\text{其他位置}.
\end{cases} f Y ( y ) = { 2 y , 0 , 这也解释了两条边缘为什么一个下降、一个上升:小的 X X X Y Y Y Y Y Y X X X
例如
P ( X < 1 / 2 ) = ∫ 0 1 / 2 2 ( 1 − x ) d x = 3 4 . P(X<1/2)=\int_0^{1/2}2(1-x)\,dx=\frac34. P ( X < 1/2 ) = ∫ 0 1/2 2 ( 1 − x ) d x = 如果你把边缘密度误写成 f X , Y ( x , 1 / 2 ) f_{X,Y}(x,1/2) f X , Y ( x , 1/2 ) Y Y Y
下面的演示器使用的就是这个三角密度。先把固定位置设为 x = 0.35 x=0.35 x = 0.35 1.3 1.3 1.3 f X ( x ) f_X(x) f X ( x ) P ( X = x ) P(X=x) P ( X =
求区域概率,先把两个限制交起来
现在问 P ( X + Y < 1 ) P(X+Y<1) P ( X + Y < 1 ) x < y x<y x < y y < 1 − x y<1-x y < 1 − x
0 < x < 1 2 , x < y < 1 − x . 0<x<\frac12,\qquad x<y<1-x. 0 < x < 2 1 , x < y < 1 − x . 因此
P ( X + Y < 1 ) = ∫ 0 1 / 2 ∫ x 1 − x 2 d y d x = ∫ 0 1 / 2 ( 2 − 4 x ) d x = 1 2 . \begin{aligned}
P(X+Y<1)
&=\int_0^{1/2}\int_x^{1-x}2\,dy\,dx\\
&=\int_0^{1/2}(2-4x)\,dx=\frac12.
\end{aligned} P ( X + Y < 1 ) 为什么外层不是从 0 0 0 1 1 1 x > 1 / 2 x>1/2 x > 1/2 y = x y=x y = x y = 1 − x y=1-x y = 1 −
再问 P ( Y − X > r ) P(Y-X>r) P ( Y − X > r ) 0 ≤ r ≤ 1 0\le r\le1 0 ≤ r ≤ 1 x x x y y y
P ( Y − X > r ) = ∫ 0 1 − r ∫ x + r 1 2 d y d x = ( 1 − r ) 2 . P(Y-X>r)=\int_0^{1-r}\int_{x+r}^{1}2\,dy\,dx=(1-r)^2. P ( Y − X > r ) = ∫ 0 1 − r ∫ 当 r < 0 r<0 r < 0 1 1 1 r ≥ 1 r\ge1 r ≥ 1 0 0 0
二维分布函数:把左下方的概率累计起来
一种始终可用的联合描述
一维分布函数看 X ≤ x X\le x X ≤ x Y ≤ y Y\le y Y ≤ y
F X , Y ( x , y ) = P ( X ≤ x , Y ≤ y ) . F_{X,Y}(x,y)=P(X\le x,Y\le y). F X , Y ( x , y ) = P ( X ≤ x , Y ≤ y ) . 在平面上,它累计点 ( x , y ) (x,y) ( x , y ) Y = X Y=X Y = X
当联合密度存在时,
F X , Y ( x , y ) = ∫ − ∞ x ∫ − ∞ y f X , Y ( u , v ) d v d u . F_{X,Y}(x,y)=\int_{-\infty}^{x}\int_{-\infty}^{y}f_{X,Y}(u,v)\,dv\,du. F X , Y ( x , y ) = ∫ − ∞ 我们换用 u , v u,v u , v x , y x,y x , y
把 y y y Y Y Y
F X ( x ) = lim y → + ∞ F X , Y ( x , y ) , F Y ( y ) = lim x → + ∞ F X , Y ( x , y ) . F_X(x)=\lim_{y\to+\infty}F_{X,Y}(x,y),\qquad
F_Y(y)=\lim_{x\to+\infty}F_{X,Y}(x,y). F X ( x ) = y → + ∞ lim 这也是边缘化,只不过现在用极限取消限制,而不是对密度积分。
用一个三角模型把分段算清楚
继续使用 f ( x , y ) = 2 f(x,y)=2 f ( x , y ) = 2 0 < x < y < 1 0<x<y<1 0 < x < y < 1 0 < y < 1 0<y<1 0 < y <
若 0 < x < y 0<x<y 0 < x < y u u u 0 0 0 x x x v v v u u u y
F ( x , y ) = ∫ 0 x ∫ u y 2 d v d u = ∫ 0 x 2 ( y − u ) d u = 2 x y − x 2 . F(x,y)=\int_0^x\int_u^y2\,dv\,du
=\int_0^x2(y-u)\,du=2xy-x^2. F ( x , y ) = ∫ 0 x ∫ u 若 x ≥ y x\ge y x ≥ y Y ≤ y Y\le y Y ≤ y X < Y X<Y X < Y X ≤ x X\le x X ≤ x X X
把正方形外部也补全,可写成
F ( x , y ) = { 0 , x ≤ 0 或 y ≤ 0 , 2 x y − x 2 , 0 < x < y < 1 , y 2 , 0 < y < 1 , x ≥ y , 2 x − x 2 , 0 < x < 1 , y ≥ 1 , 1 , x ≥ 1 , y ≥ 1. F(x,y)=
\begin{cases}
0,&x\le0\ \text{或}\ y\le0,\\
2xy-x^2,&0<x<y<1,\\
y^2,&0<y<1,\ x\ge y,\\
2x-x^2,&0<x<1,\ y\ge1,\\
1,&x\ge1,\ y\ge1.
\end{cases} F ( x , y 沿着 x = y x=y x = y y 2 y^2 y 2 y = 1 y=1 y = 1 2 x − x 2 2x-x^2 2 x − x
举个数值例子,F ( 1 / 4 , 3 / 4 ) = 2 × ( 1 / 4 ) × ( 3 / 4 ) − ( 1 / 4 ) 2 = 5 / 16 F(1/4,3/4)=2\times(1/4)\times(3/4)-(1/4)^2=5/16 F ( 1/4 , 3/4 ) = 2 × ( 1/4 ) × ( 3/4 ) − ( 1/4 ) 2 =
四个角为什么能给出一个矩形的概率
若 a < b , c < d a<b,c<d a < b , c < d
P ( a < X ≤ b , c < Y ≤ d ) . P(a<X\le b,c<Y\le d). P ( a < X ≤ b , c < Y ≤ d ) . 先取 F ( b , d ) F(b,d) F ( b , d ) F ( a , d ) F(a,d) F ( a , d ) F ( b , c ) F(b,c) F ( b , c )
P ( a < X ≤ b , c < Y ≤ d ) = F ( b , d ) − F ( a , d ) − F ( b , c ) + F ( a , c ) . \begin{aligned}
P(a<X\le b,c<Y\le d)
&=F(b,d)-F(a,d)\\
&\quad-F(b,c)+F(a,c).
\end{aligned} P ( a < X ≤ b , c < Y ≤ d ) 这就是早先事件容斥的同一个逻辑。对三角模型,取 a = 1 / 4 , b = 1 / 2 , c = 1 / 2 , d = 3 / 4 a=1/4,b=1/2,c=1/2,d=3/4 a = 1/4 , b = 1/2 , c = 1/2 , d = 3/4 1 / 2 , 5 / 16 , 1 / 4 , 3 / 16 1/2,5/16,1/4,3/16 1/2 , 5/16 ,
半开区间 ( a , b ] (a,b] ( a , b ] ( c , d ] (c,d] ( c , d ] a < X a<X a < X a ≤ X a\le X a ≤ X F ( a − , y
什么样的函数才可能是二维 CDF
二维 CDF 的值在 [ 0 , 1 ] [0,1] [ 0 , 1 ]
二维还有一项一维里容易被忽略的要求:任何矩形的四角增量都必须非负。因为刚才的四项组合本身就是一个概率。仅检查“对 x x x y y y
例如在 [ 0 , 1 ] 2 [0,1]^2 [ 0 , 1 ] 2 H ( x , y ) = max ( x , y ) H(x,y)=\max(x,y) H ( x , y ) = max ( x , y ) ( 1 / 4 , 3 / 4 ] × ( 1 / 4 , 3 / 4
3 4 − 3 4 − 3 4 + 1 4 = − 1 2 . \frac34-\frac34-\frac34+\frac14=-\frac12. 4 3 − 4 3 − 4 概率不可能为负,所以它不可能作为某个二维 CDF 在这片区域内的取值。二维累积函数需要让所有矩形的概率彼此相容,比“两条方向都朝上”更严格。
独立:什么时候可以把联合分布拆开
独立性要对所有范围成立
前面在事件层面学过独立。把事件换成随机变量的取值范围,就得到随机变量独立的定义:对任意 Borel 集合 A , B A,B A , B
P ( X ∈ A , Y ∈ B ) = P ( X ∈ A ) P ( Y ∈ B ) . P(X\in A,Y\in B)=P(X\in A)P(Y\in B). P ( X ∈ A , Y ∈ B ) = P ( X ∈ A ) P ( Y ∈ B ) . 这里的 Borel 集合包括区间,以及通过可数并、交、补构成的常用取值集合。它保证无论怎样询问两个变量各自落在哪里,联合概率都能相乘。
“知道一个不会改变另一个的概率”是很好的读法,但正式定义不必除以条件事件的概率,因此也能妥善处理零概率事件。下一章再讨论连续变量取精确值时,怎样定义条件分布。
实际判断不必逐个检查所有集合,可以用下面的等价形式。
CDF 判据足够,是因为左下矩形的概率决定整个联合分布;PMF 判据足够,是因为任意离散事件可以由格子相加。密度判据说“几乎处处”,是因为改变面积为零的集合上的密度值不会改变任何概率。不能只拿一个点上的密度写法不同,就推断不独立。
支持区域必须跟公式一起检查
先看贯穿本章的离散表。独立时,左上格应等于两个边缘的乘积,但实际
p ( 0 , 0 ) = 0.10 ≠ 0.35 × 0.30 = 0.105. p(0,0)=0.10\ne0.35\times0.30=0.105. p ( 0 , 0 ) = 0.10 = 0.35 × 0.30 = 0.105. 找到这一个不相等的格子,就已经否定独立。反过来,只有某一个格子恰好相等,却不足以证明独立;需要所有格子都满足。
对三角密度,不必纠缠内部常数 2 2 2
A = { X > 3 / 4 } , B = { Y < 1 / 4 } . A=\{X>3/4\},\qquad B=\{Y<1/4\}. A = { X > 3/4 } , B = { Y < 1/4 } . 它们的概率各为 1 / 16 1/16 1/16 X < Y X<Y X < Y
P ( A ∩ B ) = 0 ≠ 1 16 × 1 16 . P(A\cap B)=0\ne\frac1{16}\times\frac1{16}. P ( A ∩ B ) = 0 = 16 1 × 这个事件证明避开了“给定连续变量恰好等于某个值”的细节,也把依赖来自何处说得很清楚:两个正概率的取值范围被联合支持区域禁止搭配。
换一个真正可分离的例子:
f ( x , y ) = { 4 x y , 0 < x < 1 , 0 < y < 1 , 0 , 其他位置 . f(x,y)=
\begin{cases}
4xy,&0<x<1,\ 0<y<1,\\
0,&\text{其他位置}.
\end{cases} f ( x , y ) = { 4 x y , 0 , 积分得到 f X ( x ) = 2 x f_X(x)=2x f X ( x ) = 2 x f Y ( y ) = 2 y f_Y(y)=2y f Y ( y ) = 2 y
矩形支持只是帮助检查的线索,本身并不能证明独立。例如单位正方形上 f ( x , y ) = x + y f(x,y)=x+y f ( x , y ) = x + y 1 1 1 t + 1 / 2 t+1/2 t + 1/2 x + y x+y x +
独立为什么允许乘积期望拆开
若 X , Y X,Y X , Y E ∣ X ∣ , E ∣ Y ∣ E|X|,E|Y| E ∣ X ∣ , E ∣ Y ∣ E ∣ X Y ∣ E|XY| E ∣ X Y ∣
E [ X Y ] = E [ X ] E [ Y ] . E[XY]=E[X]E[Y]. E [ X Y ] = E [ X ] E [ Y ] . 用密度看这件事尤其直观:
E [ X Y ] = ∬ x y f X ( x ) f Y ( y ) d x d y = ( ∫ x f X ( x ) d x ) ( ∫ y f Y ( y ) d y ) . \begin{aligned}
E[XY]
&=\iint xy f_X(x)f_Y(y)\,dx\,dy\\
&=\left(\int xf_X(x)\,dx\right)
\left(\int yf_Y(y)\,dy\right).
\end{aligned} E [ X Y ] 能够拆开,是因为一个因子只含 x x x y y y
同样的结论对可测函数 g , h g,h g , h X , Y X,Y X , Y g ( X ) , h ( Y ) g(X),h(Y) g ( X ) , h ( Y ) E [ g ( X ) h ( Y ) ] = E [ g ( X ) ] E [ h ( Y ) ] E[g(X)h(Y)]=E[g(X)]E[h(Y)]
协方差:相加时缺的那一项
先把各自的中心挪到零
讨论共同变化时,“大”应该相对于各自的平均水平来理解。温度 30 30 30 0.3 0.3 0.3
以下假设 E [ X 2 ] , E [ Y 2 ] E[X^2],E[Y^2] E [ X 2 ] , E [ Y 2 ] μ X = E [ X ] \mu_X=E[X] μ X = E
Cov ( X , Y ) = E [ ( X − μ X ) ( Y − μ Y ) ] . \operatorname{Cov}(X,Y)=E[(X-\mu_X)(Y-\mu_Y)]. Cov ( X , Y ) = E [( X − μ X ) ( Y − μ 若两个偏差同号,乘积为正;异号,乘积为负。协方差把这些乘积按发生概率加权。它看的是整体平均效果,并不要求每一对结果都沿着同一个方向变化。
二阶矩有限是很方便的保证:由 2 ∣ X Y ∣ ≤ X 2 + Y 2 2|XY|\le X^2+Y^2 2∣ X Y ∣ ≤ X 2 + Y 2
Cov ( X , Y ) = E [ X Y ] − μ X E [ Y ] − μ Y E [ X ] + μ X μ Y = E [ X Y ] − E [ X ] E [ Y ] . \begin{aligned}
\operatorname{Cov}(X,Y)
&=E[XY]-\mu_XE[Y]-\mu_YE[X]+\mu_X\mu_Y\\
&=E[XY]-E[X]E[Y].
\end{aligned} Cov ( X , Y ) 因此协方差衡量的,也是乘积期望与“假如可以分别取平均再相乘”之间的差。
对前面的联合表,
Cov ( X , Y ) = 0.90 − 0.95 × 0.90 = 0.045. \operatorname{Cov}(X,Y)=0.90-0.95\times0.90=0.045. Cov ( X , Y ) = 0.90 − 0.95 × 0.90 = 0.045. 这是正值,说明偏差乘积的加权总和略偏向正,但仅凭这个数大小还不能判断关系强弱:如果两个计数都乘以 100 100 100 10000 10000 10000
为什么总和的方差一般不能直接相加
现在把传感器问题接回来。展开总偏差的平方:
Var ( X + Y ) = E [ ( ( X − μ X ) + ( Y − μ Y ) ) 2 ] = Var ( X ) + Var ( Y ) + 2 Cov ( X , Y ) . \begin{aligned}
\operatorname{Var}(X+Y)
&=E\left[\bigl((X-\mu_X)+(Y-\mu_Y)\bigr)^2\right]\\
&=\operatorname{Var}(X)+\operatorname{Var}(Y)
+2\operatorname{Cov}(X,Y).
\end{aligned} Var ( X + Y ) 这次多出来的交叉项没有凭空消失,它就是两倍协方差。一般地,常数 a , b a,b a , b
Var ( a X + b Y ) = a 2 Var ( X ) + b 2 Var ( Y ) + 2 a b Cov ( X , Y ) . \operatorname{Var}(aX+bY)
=a^2\operatorname{Var}(X)+b^2\operatorname{Var}(Y)
+2ab\operatorname{Cov}(X,Y). Var ( a X + bY ) = a 2 Var ( X ) + b 对开头的两只传感器,每个误差的均值都是零、方差都是 1 1 1 1 1 1 ( X + Y ) / 2 (X+Y)/2 ( X + Y ) /2 1 1 1 − 1 -1 − 1 1 / 2 1/2 1/2
这说明“多测几次再平均,波动就会减小”需要看不同观测怎样联系。若它们共享同一种偏差,仅靠重复次数不能把共同波动消掉。后面证明大数定律时,方差里的这些交叉项会再次出现。
协方差还满足对称性与双线性。例如平移只改变均值,不改变偏差,所以
Cov ( a X + b , c Y + d ) = a c Cov ( X , Y ) . \operatorname{Cov}(aX+b,cY+d)=ac\operatorname{Cov}(X,Y). Cov ( a X + b , c Y + d ) = a c Cov ( X , Y ) . 这些性质都可以从定义直接展开得到。尤其 Cov ( X , X ) = Var ( X ) \operatorname{Cov}(X,X)=\operatorname{Var}(X) Cov ( X , X ) = Var ( X )
相关系数:除去单位后,还能说明多少
标准化后,大小才可比较
假设两个方差有限且严格大于零。把协方差除以两个标准差,得到相关系数
ρ X , Y = Cov ( X , Y ) σ X σ Y . \rho_{X,Y}=\frac{\operatorname{Cov}(X,Y)}{\sigma_X\sigma_Y}. ρ X , Y = σ X σ 设标准化变量
U = X − μ X σ X , V = Y − μ Y σ Y . U=\frac{X-\mu_X}{\sigma_X},\qquad
V=\frac{Y-\mu_Y}{\sigma_Y}. U = σ X X − μ X 那么两者均值都是零、方差都是 1 1 1 ρ = E [ U V ] \rho=E[UV] ρ = E [ U V ]
为什么相关系数一定在 [ − 1 , 1 ] [-1,1] [ − 1 , 1 ]
0 ≤ E [ ( U − V ) 2 ] = 2 − 2 ρ , 0\le E[(U-V)^2]=2-2\rho, 0 ≤ E [( U − V ) 2 ] = 2 − 2 ρ , 0 ≤ E [ ( U + V ) 2 ] = 2 + 2 ρ . 0\le E[(U+V)^2]=2+2\rho. 0 ≤ E [( U + V ) 2 ] = 2 + 2 ρ . 两个不等式合起来就给出 − 1 ≤ ρ ≤ 1 -1\le\rho\le1 − 1 ≤ ρ ≤ 1 ρ = 1 \rho=1 ρ = 1 U = V U=V U = V ρ = − 1 \rho=-1 ρ = − 1
某个变量是常数时,其标准差为零,相关系数没有定义。不能把“没有定义”填成零;协方差为零与无法标准化是两件事。
继续算联合表的相关系数:
E [ X 2 ] = 0.35 + 4 × 0.30 = 1.55 , Var ( X ) = 1.55 − 0.95 2 = 0.6475 , E[X^2]=0.35+4\times0.30=1.55,
\qquad \operatorname{Var}(X)=1.55-0.95^2=0.6475, E [ X 2 ] = 0.35 + 4 × 0.30 = 1.55 , Var ( X ) = 1.55 E [ Y 2 ] = 0.50 + 4 × 0.20 = 1.30 , Var ( Y ) = 1.30 − 0.90 2 = 0.49. E[Y^2]=0.50+4\times0.20=1.30,
\qquad \operatorname{Var}(Y)=1.30-0.90^2=0.49. E [ Y 2 ] = 0.50 + 4 × 0.20 = 1.30 , Var ( Y ) = 1.30 所以
ρ X , Y = 0.045 0.6475 × 0.49 ≈ 0.0799. \rho_{X,Y}=\frac{0.045}{\sqrt{0.6475\times0.49}}\approx0.0799. ρ X , Y = 0.6475 × 0.49 这个模型的线性相关很弱。它早已被证明不独立,而一个接近零的相关系数并不会推翻那个结论。
零相关可以藏着完全确定的关系
取 X ∼ U ( − 1 , 1 ) X\sim U(-1,1) X ∼ U ( − 1 , 1 ) Y = X 2 Y=X^2 Y = X 2 X X X Y Y Y
E [ X ] = 0 , E [ Y ] = E [ X 2 ] = 1 3 , E [ X Y ] = E [ X 3 ] = 0. E[X]=0,\qquad E[Y]=E[X^2]=\frac13,
\qquad E[XY]=E[X^3]=0. E [ X ] = 0 , E [ Y ] = E [ X 2 ] = 所以 Cov ( X , Y ) = 0 \operatorname{Cov}(X,Y)=0 Cov ( X , Y ) = 0
Var ( X ) = 1 3 , q q u a d Var ( Y ) = E [ X 4 ] − E [ X 2 ] 2 = 1 5 − 1 9 = 4 45 , \operatorname{Var}(X)=\frac13,qquad
\operatorname{Var}(Y)=E[X^4]-E[X^2]^2=\frac15-\frac19=\frac4{45}, Var ( X ) = 3 1 , q q u a d Var ( Y 两个方差都为正,相关系数确实是零。
它们为什么不独立,可以不用一句“显然有关系”带过。令 A = { ∣ X ∣ ≤ 1 / 2 } A=\{|X|\le1/2\} A = { ∣ X ∣ ≤ 1/2 } B = { Y ≤ 1 / 4 } B=\{Y\le1/4\} B = { Y ≤ 1/4 } Y = X 2 Y=X^2 Y =
P ( A ∩ B ) = 1 2 , q q u a d P ( A ) P ( B ) = 1 4 . P(A\cap B)=\frac12,qquad P(A)P(B)=\frac14. P ( A ∩ B ) = 2 1 , q q u a d P ( A ) P ( B ) 独立性被明确否定。零协方差的原因是:正的 X X X X 2 X^2 X 2 X X X X 2 X^2 X 2
因此,在有限二阶矩的条件下,独立推出零协方差;反过来不成立。即便两个边缘都正态,也不能直接反推独立,必须有“它们联合构成多元正态”这一额外条件。下一部分会把这句话说清楚。
相关也不是因果。联合分布告诉我们两者如何一起出现,没有单凭这件事就说明干预一个变量会使另一个怎样变化。解释现实数据时,要把随机模型中的数学关系与产生数据的机制区分开。
多个变量:把所有线性波动放进一张矩阵
联合独立比两两独立更强
有 d d d X = ( X 1 , … , X d ) T \mathbf X=(X_1,\ldots,X_d)^{\mathsf T} X = ( X 1 , … , X d )
F X ( x 1 , … , x d ) = P ( X 1 ≤ x 1 , … , X d ≤ x d ) . F_{\mathbf X}(x_1,\ldots,x_d)
=P(X_1\le x_1,\ldots,X_d\le x_d). F X ( x 1 , … , x d ) 需要某几个坐标的边缘时,就对其余坐标求和或积分;用 CDF 表示,则把其余阈值趋于正无穷。注意“边缘”也可以是二维或三维分布,不限于一个变量。
这些变量相互独立,要求对任意 Borel 集合 A 1 , … , A d A_1,\ldots,A_d A 1 , … , A d
P ( X 1 ∈ A 1 , … , X d ∈ A d ) = ∏ i = 1 d P ( X i ∈ A i ) . P(X_1\in A_1,\ldots,X_d\in A_d)=\prod_{i=1}^dP(X_i\in A_i). P ( X 1 ∈ A 1 , … , X 只检查每一对还不够。取独立的公平二元变量 A , B A,B A , B C C C C = 1 C=1 C = 1 C = 0 C=0 C = 0
( 0 , 0 , 0 ) , ( 0 , 1 , 1 ) , ( 1 , 0 , 1 ) , ( 1 , 1 , 0 ) , (0,0,0),\ (0,1,1),\ (1,0,1),\ (1,1,0), ( 0 , 0 , 0 ) , ( 0 , 1 , 1 ) , ( 1 , 0 , 1 ) , ( 1 , 1 , 0 ) , 各以 1 / 4 1/4 1/4 1 / 4 1/4 1/4 1 / 4 1/4 1/4 ( 1 / 2 ) 3 = 1 / 8 (1/2)^3=1/8 ( 1/2 ) 3 = 1/8
协方差矩阵不只是把数字排成方阵
假设每个分量都有有限二阶矩,记均值向量 μ = E [ X ] \boldsymbol\mu=E[\mathbf X] μ = E [ X ]
Σ = E [ ( X − μ ) ( X − μ ) T ] , q q u a d Σ i j = Cov ( X i , X j ) . \Sigma=E\left[(\mathbf X-\boldsymbol\mu)(\mathbf X-\boldsymbol\mu)^{\mathsf T}\right],qquad
\Sigma_{ij}=\operatorname{Cov}(X_i,X_j). Σ = E [ ( X − μ ) ( X − μ ) T ] 对角线是每个变量自己的方差;非对角线是两两协方差。由协方差的对称性,Σ \Sigma Σ D = diag ( σ 1 , … , σ d ) D=\operatorname{diag}(\sigma_1,\ldots,\sigma_d) D = diag ( σ 1 , … , σ d )
R = D − 1 Σ D − 1 . R=D^{-1}\Sigma D^{-1}. R = D − 1 Σ D − 1 . 它的对角线全为 1 1 1 [ − 1 , 1 ] [-1,1] [ − 1 , 1 ]
任取常数向量 a \mathbf a a a T X \mathbf a^{\mathsf T}\mathbf X a T X
Var ( a T X ) = a T Σ a ≥ 0. \operatorname{Var}(\mathbf a^{\mathsf T}\mathbf X)
=\mathbf a^{\mathsf T}\Sigma\mathbf a\ge0. Var ( a T X ) = a T Σ a ≥ 0. 这叫矩阵半正定。它不是额外附会的代数术语,而是在说:不管怎样给这些变量加权,相加后的方差都不能为负。
例如假定三个方差都是 1 1 1 − 0.9 -0.9 − 0.9 [ − 1 , 1 ] [-1,1] [ − 1 , 1 ]
3 + 2 × 3 × ( − 0.9 ) = − 2.4. 3+2\times3\times(-0.9)=-2.4. 3 + 2 × 3 × ( − 0.9 ) = − 2.4. 不可能。所以这样的三维相关矩阵不存在。两两关系还需要能彼此共存。
更一般地,若用常数矩阵 A A A b \mathbf b b Y = A X + b \mathbf Y=A\mathbf X+\mathbf b Y = A X + b
E [ Y ] = A μ + b , q q u a d Cov ( Y ) = A Σ A T . E[\mathbf Y]=A\boldsymbol\mu+\mathbf b,qquad
\operatorname{Cov}(\mathbf Y)=A\Sigma A^{\mathsf T}. E [ Y ] = A μ + b , q q u a d Cov ( Y ) = A Σ A 它同时包含了“平移不改变方差”“乘常数后方差乘平方”和“和的方差含交叉项”。矩阵记号没有换一套原理,只是把同样的展开打包了。
多元正态的特殊之处在哪里
称随机向量是多元正态,意思是它的每一个线性组合都服从正态分布,允许方差为零的常数情形。只说每个坐标单独正态,还没有达到这个要求。
在协方差矩阵正定时,多元正态有密度
f ( x ) = 1 ( 2 π ) d / 2 ( det Σ ) 1 / 2 exp [ − 1 2 ( x − μ ) T Σ − 1 ( x − μ ) ] . f(\mathbf x)=\frac{1}{(2\pi)^{d/2}(\det\Sigma)^{1/2}}
\exp\left[-\frac12(\mathbf x-\boldsymbol\mu)^{\mathsf T}
\Sigma^{-1}(\mathbf x-\boldsymbol\mu)\right]. f ( x ) = ( 2 π ) d /2 ( det 这个公式现在不用硬背。先读它的几何含义:均值向量确定中心,协方差矩阵决定等密度椭球的方向与宽窄。若矩阵奇异,分布集中在较低维的平面上,上面含逆矩阵的密度公式不能使用;这与 Y = X Y=X Y = X
对联合正态向量,两个分量协方差为零就意味着它们独立;若整个协方差矩阵是对角矩阵,则所有分量相互独立。在正定的情形可以直接看出来:矩阵为对角时,指数变成各坐标的平方项之和,密度随之分解成一维正态密度的乘积。
为什么一定要强调“联合”?取 Z ∼ N ( 0 , 1 ) Z\sim N(0,1) Z ∼ N ( 0 , 1 ) − 1 , 1 -1,1 − 1 , 1 S S S X = Z , Y = S Z X=Z,Y=SZ X = Z , Y =
E [ X Y ] = E [ S Z 2 ] = E [ S ] E [ Z 2 ] = 0. E[XY]=E[SZ^2]=E[S]E[Z^2]=0. E [ X Y ] = E [ S Z 2 ] = E [ S ] E [ Z 2 ] = 但 ∣ X ∣ = ∣ Y ∣ |X|=|Y| ∣ X ∣ = ∣ Y ∣ q = P ( ∣ Z ∣ ≤ 1 ) q=P(|Z|\le1) q = P ( ∣ Z ∣ ≤ 1 ) 0 < q < 1 0<q<1 0 < q
把这些关系亲手算一遍
练习一:从合法性查到独立性
某个联合表中,X , Y X,Y X , Y 0 , 1 0,1 0 , 1 p ( 0 , 0 ) , p ( 1 , 0 ) , p ( 0 , 1 ) , p ( 1 , 1 ) p(0,0),p(1,0),p(0,1),p(1,1) p ( 0 , 0 ) , p ( 1 , 0 ) , p ( 0 , 1 ) ,
显示答案 原表总和是 0.95 0.95 0.95 0.40 0.40 0.40
修正后 P ( X = 0 ) = 0.30 , P ( X = 1 ) = 0.70 P(X=0)=0.30,P(X=1)=0.70 P ( X = 0 ) = 0.30 , P ( X = 1 ) = 0.70
练习二:归一化与可分解性一起检查
设单位正方形上 f ( x , y ) = c x y f(x,y)=cxy f ( x , y ) = c x y c c c P ( X < 1 / 2 , Y > 1 / 2 ) P(X<1/2,Y>1/2) P ( X < 1/2 , Y > 1/2 )
显示答案 归一化给出 c × ( 1 / 2 ) × ( 1 / 2 ) = 1 c\times(1/2)\times(1/2)=1 c × ( 1/2 ) × ( 1/2 ) = 1 c = 4 c=4 c = 4 6 6 6 1.5 1.5 1.5
边缘为
练习三:三角支持里的一条窄带
对密度 f ( x , y ) = 2 f(x,y)=2 f ( x , y ) = 2 0 < x < y < 1 0<x<y<1 0 < x < y < 1 P ( Y − X < 1 / 4 ) P(Y-X<1/4) P ( Y −
显示答案 由正文已推得 P ( Y − X > r ) = ( 1 − r ) 2 P(Y-X>r)=(1-r)^2 P ( Y − X > r ) = ( 1 − r ) 2
P ( Y − X < 1 / 4 ) = 1 − ( 3 / 4 ) 2 = 7 16 . P(Y-X<1/4)=1-(3/4)^2=\frac7{16}. 练习四:没有联合密度,CDF 还能怎么写
设 X ∼ U ( 0 , 1 ) X\sim U(0,1) X ∼ U ( 0 , 1 ) Y = X Y=X Y = X 0 ≤ x , y ≤ 1 0\le x,y\le1 0 ≤ x , y ≤ 1
显示答案 两个限制 X ≤ x X\le x X ≤ x Y ≤ y Y\le y Y ≤ y X ≤ min ( x , y ) X\le\min(x,y) X ≤ min ( x , y ) F ( x , y ) = min ( x , y ) F(x,y)=\min(x,y)
练习五:零协方差与零方差别混在一起
设 X X X − 2 , 0 , 2 -2,0,2 − 2 , 0 , 2 Y = X 2 Y=X^2 Y = X 2 Y Y Y 4 4 4
显示答案 由对称性 E [ X ] = E [ X 3 ] = 0 E[X]=E[X^3]=0 E [ X ] = E [ X 3 ] = 0 X , Y X,Y X , Y
令 A = { X = 0 } , B = { Y = 0 } A=\{X=0\},B=\{Y=0\}
练习六:矩阵里的交叉项去了哪里
设三个随机变量的协方差矩阵为
Σ = ( 1 1 / 2 0 1 / 2 1 0 0 0 4 ) . \Sigma=\begin{pmatrix}
1&1/2&0\\
1/2&1&0\\
0&0&4
\end{pmatrix}. Σ = 求 Var ( X 1 + X 2 − X 3 ) \operatorname{Var}(X_1+X_2-X_3) Var ( X 1 + X 2 − X 3 ) X 3
显示答案 权重向量为 ( 1 , 1 , − 1 ) T (1,1,-1)^{\mathsf T} ( 1 , 1 , − 1 ) T
Var ( X 1 + X 2 − X 3 ) = 1 + 1 + 4 + 2 × 1 2 = 7. \operatorname{Var}(X_1+X_2-X_3)
=1+1+4+2\times\frac12=7. Var ( X 1 + 现在我们能把几个量完整地放在同一个模型里,也知道单独求边缘会丢掉什么。还有一个很自然的问题没有回答:如果观察到了 Y Y Y X X X