常见连续分布:均匀、指数、正态、Gamma 与 Beta
上一章,我们把“连续随机变量取某个值的概率”换成了“它落在某段区间里的概率”。密度曲线负责描述概率怎样分布,积分负责把一段区间里的概率收起来。这套语言已经有了,接下来要解决一个更实际的问题:面对等待时间、测量读数或一个未知的比例,到底该画哪一条密度曲线?
先别急着背五个名字。设想我们关心三件事:一段录音中随机选中的播放位置、传感器下一次收到信号的等待时间、仪器测量同一个零件时的读数。它们都可以用连续变量描述,可“随机”的方式并不相同。播放位置有起点和终点,等待时间不能为负,测量读数则可能在中心上下波动。分布的公式,是这些差别的数学表达。
这一章会把均匀、指数、正态、Gamma 和 Beta 五个分布逐个展开。我们既要会算概率,也要看清楚每个公式背后多加了什么假设。你在导论课里可能听过“等待时间用指数”“误差用正态”,现在要补上的正是这半句话:什么条件让它合理,什么现象会让它不再合理。
先把变量说清楚,再给分布起名字
如果有人问“网站点击率是什么分布”,我们还不能马上回答。一次访问是否点击,只有 0 和 1 两种结果,可以用 Bernoulli 变量表示;固定 n 次访问里的点击次数,是一个整数;实际观测到的点击比例只能取 0,1/n,…,1,仍然是离散的。另一个问题是,我们怎样表达对未知点击概率本身的不确定性,这时才可能让一个取值在 [0,1] 的连续变量进入模型。
这几个问题都带着“点击率”三个字,数学对象却不同。选模型之前,先写一句完整的话:“令 X 表示……,计量单位是……,可能取值是……。”很多看起来像公式错误的题,其实在这一步就已经把变量认错了。
本章这些分布都有密度,所以单个端点的概率都是 0。把指数密度在 0 处定义成 λ 或 0,并不会改变分布;Beta 密度在端点附近可以趋于无穷,也不表示端点本身获得了正概率。我们关心的始终是面积。
后面会顺便算出每个分布的期望和方差,为下一章作准备。先给这两个量一个够用的解释:期望 E(X) 是按概率加权的中心,方差是偏离这个中心的平方的加权平均。对于本章这些具有有限二阶矩的密度,我们使用
E(X)=∫−∞∞xf
其中 E(X2)=∫x2fX(x)dx。期望是否存在、这些计算规则为什么成立,下一章会系统讨论。现在先让公式在具体分布里有一点可见的含义。
均匀分布:相等的是区间长度对应的概率
“每个点一样可能”还不够准确
一段录音长 12 分钟。我们用一个规则随机选择播放位置,并要求任意两个长度相同的时间区间,被选中的概率都相同。这样,开头一分钟和最后一分钟各占总概率的 1/12;从第 3 分钟到第 6 分钟,占总长度的四分之一,概率也应当是四分之一。
这才是连续均匀分布里“均匀”的准确意思。不能把它理解成“每个点分到同一个正概率”:区间里有无穷多个点,任何一个精确点的概率都是 0。能拿来比较的是一段长度所分到的概率。
一般地,设 X∼U(a,b),其中 a<b。区间内密度是常数 c,又因为总面积必须为 1,所以 c(b。于是
fX(x)=⎩⎨
密度的高度有时会超过 1。例如 U(0,0.2) 的密度高达 5,没有任何问题:高 5、宽 0.2 的矩形面积仍然是 1。这里也能再体会一次,密度高度和概率是两个不同的量。
从密度走到分布函数和区间概率
当 x<a 时,X 不可能落在 x 左边,所以分布函数为 0。当 a≤x<b 时,累积的是宽 的矩形面积。超过 之后,所有面积都已经收完。三种情况合起来是
FX(x)=⎩
因此,对位于支持区间内部的 a≤c≤d≤b,
P(c≤X≤d)=FX(d)−F
如果题目给的区间超出了 [a,b],不能直接把整段长度代进去。比如 X∼U(0,12),求 P(10<X<15),真正可能发生的只有 ,所以答案是 。对一般的 ,先取区间交集即可:
P(c≤X≤d)=b−amax{0,min(d
这个稍长的公式并不需要死记,它只是把“先裁掉支持集外面的部分”写成了一行。
中心为什么在中点,方差为什么有一个十二
均匀密度左右对称,期望落在中点很合理。直接计算可以确认:
E(X)=b−a1∫a
为了看清方差,把中心移到 0,记 m=(a+b)/2,区间长度记作 L=b−a。此时左右端点是 −L/2 和 ,所以
Var(X)
现在 1/12 不再只是表格里冒出来的数。它来自对整个区间的平方距离取平均。区间平移不会改变这些距离;区间长度扩大为原来的两倍,平方距离就扩大为四倍,方差也因此扩大为四倍。
有界不等于均匀,“不知道”也不等于均匀
只知道一个同学会在八点到九点之间到达,不能推出每一段时间的到达概率相同。如果课程八点半开始,他可能集中在八点二十五分到八点三十分到达;即使我们暂时不知道这种偏好,它也不会因此消失。
均匀分布是一项明确的建模假设,需要由抽样规则、对称性或数据支持。上面的录音例子中,我们直接规定了“等长区间等概率”的选择规则,所以使用均匀模型有依据。对现实到达时间,则应把这项假设单独说明。
还可以检查这个模型是否能承受变量变换。若 U∼U(0,1),令 Y=U2,那么在 0≤y≤1 上,
P(Y≤y)=P(U≤y)=
所以 Y 的密度是 1/(2y),并不均匀。均匀是相对于当前数轴刻度而言的;非线性地换一个量,通常会改变形状。不过线性伸缩可以保留均匀性:a+。这也是把计算机产生的单位区间随机数换到指定范围的基本方法。
指数分布:已经等过的时间什么时候可以忽略
从“还没有发生”开始建模
有些等待越久,剩下的时间就越短。例如每隔 10 分钟固定发车,刚错过一班后已经等了 8 分钟,显然和刚开始等的情况不同。另一些等待可以近似为:只要事件还没发生,接下来一小段时间里发生的机会基本不受已经等待多久影响。
指数分布描述的是后一种机制。令 T 为等待时间,记
S(t)=P(T>t).
这叫生存函数,表示等到 t 时事情仍然没有发生的概率。假设对小的 h>0,在已经等到 t 的条件下,接下来 h 时间内发生事件的概率满足
P(t<T≤t+h∣T>t)=λh+o(h),
其中 λ>0 不随 t 变化。在生存函数可微等正则条件下,把这句话改写为
S(t)S(t)−S(t+h)=λh+o(h),
再除以 h 并取极限,就得到 S′(t)=−λS(t)。由 S(0)=1,解得
S(t)=e−λt,t≥0.
因此指数分布的分布函数和密度分别为
FT(t)
我们记作 T∼Exp(λ)。总面积也可以直接核对:∫0∞λe−λtd。
这里的 λ 是率参数。若时间单位为分钟,它的单位就是“每分钟”。λt 没有单位,因此可以放在指数里。率越大,生存函数下降越快,较长等待留下的概率越少。
无记忆性是一条条件概率等式
设已经等了 s,事件仍然没有发生。还要再等超过 t,对应的事件是总等待时间超过 s+t。由条件概率公式,
P(T>s+t∣T
这就是无记忆性。它说的是在已经等到 s 的条件下,剩余等待时间 T−s 的分布,与最初等待时间的分布相同。它没有说“事件没有原因”,也没有说一条已经记录下来的等待时间会重新随机生成。我们只是得到新信息 T>s 后,重新计算剩余时间的条件分布。
例如,某种信号的等待时间被建模为均值 5 分钟的指数分布,率为 λ=1/5。从现在开始等超过 8 分钟的概率是
P(T>8)=e−8/5≈0.2019.
如果已经等了 3 分钟,再等超过 8 分钟的概率仍然是 0.2019;相应事件应写成 T>11,条件是 T>3。容易写错的是 P,它问的是剩下还要等超过 分钟,答案为 。
顺便比较一下均匀等待。若 W∼U(0,10),则
P(W>3)=107,P(W>8
后一个事件表示已经等了 5 分钟后,还要再等超过 3 分钟。它和从头等超过 3 分钟的概率不一样。上界 10 分钟让过去提供了有用的信息,所以无记忆性在这里不成立。
图中把时间起点平移到“已经等了 s”的时刻。上面从 s 到 s+t,下面从 0 到 t,都还需要等待同样长的一段时间;指数模型说的是,在尚未发生这一条件下,这两段等待对应相同的生存概率。
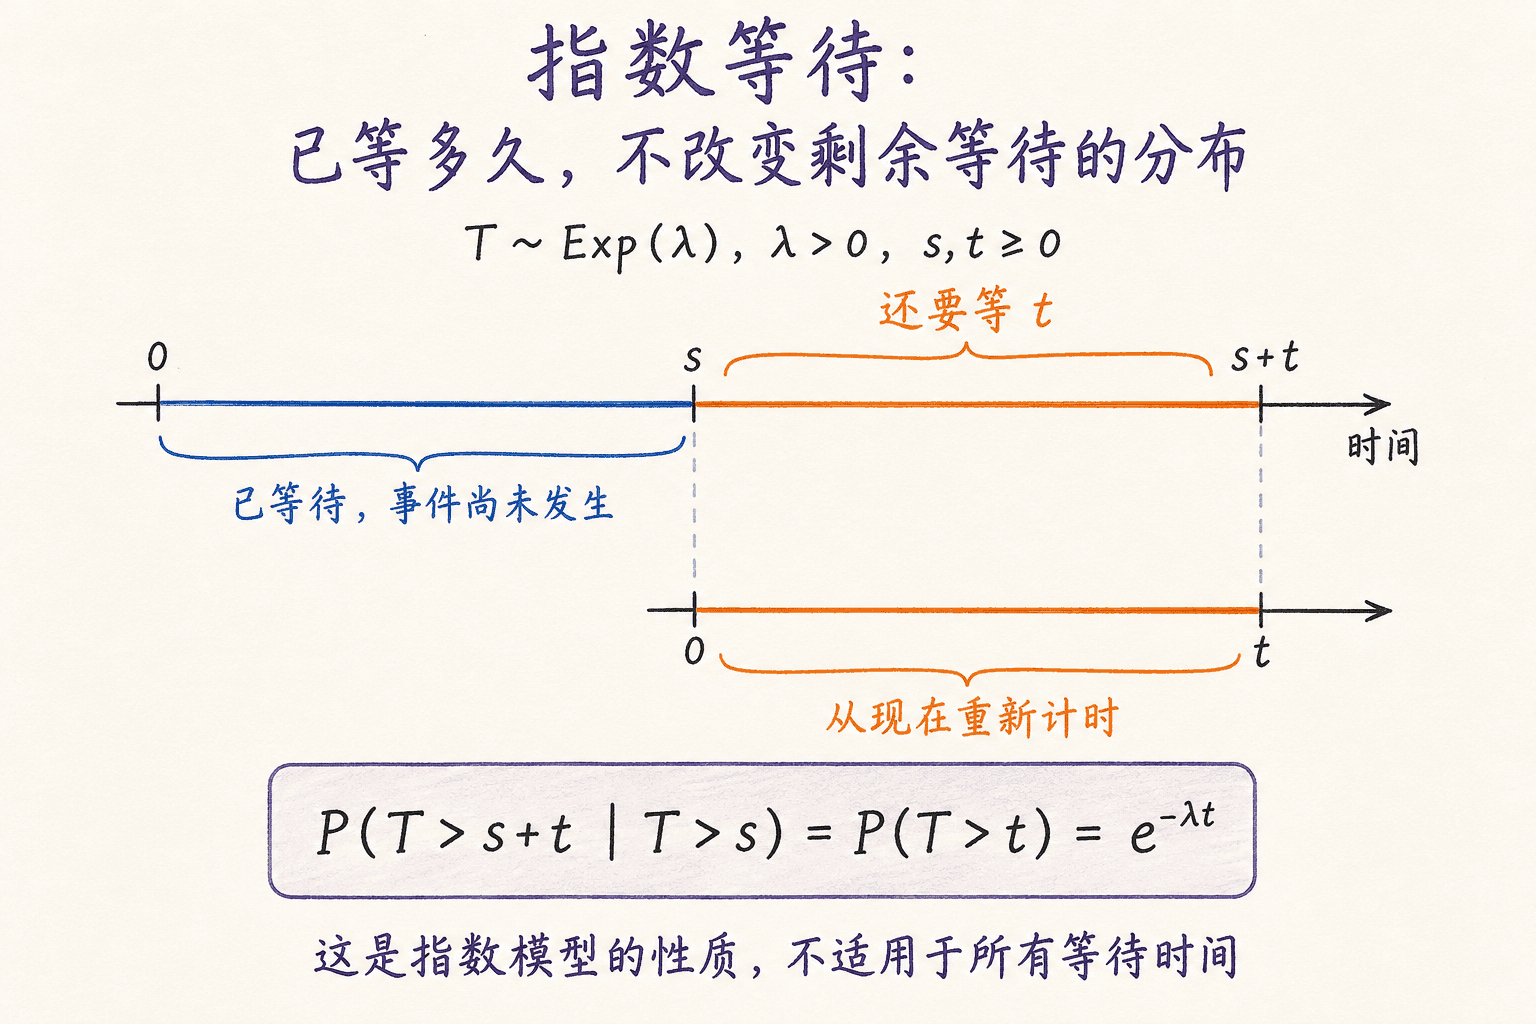 已等了多久,不改变指数模型中剩余等待的分布;两条等长橙色区间对应相同的等待长度 t。
均值、方差与中位数,各自在说什么
对指数密度分部积分,边界项 te−λt 在无穷远趋于 0,因此
E(T)=∫
二阶矩同样计算:
E(T2)=[−t2e−λ
所以
Var(T)=λ22−λ
指数等待的标准差恰好等于均值。这说明等待的波动并不小:“平均等五分钟”绝不等于“通常只在五分钟附近轻微浮动”。少量很长的等待会把均值向右拉。
如果问“一半的等待会在多久以内结束”,需要求中位数 m。由 FT(m)=1/2,
m=λlog2<λ1.
均值和中位数不同,正好反映了右侧长尾的影响。更一般地,0<q<1 的分位数为 −log(1−q)/λ。反过来,若 U∼U(0,,令 ,就能生成这个指数分布;把不等式代回 CDF 即可验证。
平均到达率并不足以推出指数等待
如果信号构成率为 λ 的齐次 Poisson 过程,那么长度为 t 的区间里信号数服从 Poisson(λt)。从一个固定起点到下一次信号的等待超过 t,恰好等价于这段时间一个信号也没来,于是
P(T>t)=P(N(t)=0)=e−λt.
这里真正提供依据的是 Poisson 过程的假设,包括稳定的率和不相交时间区间的独立增量。仅仅“平均每五分钟一个信号”不能推出指数分布:每五分钟准时来一次,也满足这个平均频率,却显然有另一种等待规律。
寿命模型也一样。容易老化的零件,已经使用的时间会影响未来失效机会;人流高峰前后,下一通电话的到达率会变化。这些现象都要求重新检查指数假设。模型的优点是条件概率很简洁,它的限制也正藏在这份简洁里。
正态分布:平移和缩放,为什么可以省下一整套概率表
先看公式怎样控制中心和宽度
假设某仪器测得的长度在 40 毫米附近上下波动,左右偏差大致对称。一个待检验的模型是 X∼N(40,0.52)。这里第一个参数是中心,第二个参数是方差;0.5 才是标准差,单位同样是毫米。
一般地,对 μ∈R、σ>0,正态密度为
fX(x)=σ2π
平方项让距离中心同样远的左右两点具有相同密度。离中心越远,平方偏差越大,指数项越小。增大 σ 后,同样一段绝对距离折合成的标准差倍数变小,曲线变宽;前面的 1/σ 又把高度压低,保证总面积不变。
为什么会出现 2π?它来自归一化积分。记
I=∫−∞∞e−z2/2dz.
这个一维积分没有通常初等函数形式的原函数。把它平方,变为平面上的二重积分,再用极坐标,计算反而简化:
I2
极坐标里的 r 是面积变换因子;径向积分用 u=r2/2 就等于 1。因为 I>0,所以 I。若你还未学过二重积分,可以先记住这个归一化结果,后面的概率计算并不依赖亲手复现这段计算。
标准化是在给偏差换单位
令
Z=σX−μ.
先减去中心,再用标准差作为新的计量单位。比如 X=41、μ=40、σ=0.5,对应 Z=2,读作“比中心高两个标准差”。它不是把观测值变得更随机,也不是把任意分布强行变成正态,只是一次线性变换。
当原来的 X 确实服从正态分布时,对应密度为
fZ(z)=σfX(μ+σz)
因子 σ 来自 dx=σdz。于是 Z∼N(0,1),所有正态概率都能转成这同一条标准正态曲线的面积。记标准正态分布函数为
Φ(z)=∫−∞z2π
对 l<r,由于 σ>0,标准化不会翻转不等号,因此
P(l<X<r)=Φ(σr−μ
这一步同时说明了为什么密度表不能直接代替概率表:我们相减的是已经累计面积的 Φ,不是端点的密度高度。
下面的计算器可以用来核对标准化。先设 μ=0、σ=1、l=−1、r=2,观察两个标准化端点与约 的面积。再只增大 ,保持原来的区间端点,看看它们折合成的标准差倍数如何改变。曲线会随显示范围缩放,因此比较概率时应读出计算结果,不能只比较屏幕上的像素面积。
计算器要求标准差为正;若把下端调到上端右侧,事件 l≤X≤r 为空,界面会提示并把概率记为 0。显示的 CDF 结果是数值近似,四位小数中的 0.0000 也可能代表一个很小的正概率。
一次完整的计算与反向计算
继续采用 X∼N(40,0.52) 的长度模型,求读数在 39.5 到 41 毫米之间的概率。
先确认第二个参数是方差,所以标准化时除以 0.5。左端点是 (39.5−40)/0.5=−1,右端点是 (41−。
反过来,如果想找覆盖中间 95% 读数的对称区间,两端各留 2.5%。由 Φ(1.95996)≈0.975,区间为
[μ−1.95996σ, μ+1.95996σ].
在这个例子里约为 [39.020,40.980] 毫米。它是一个指定分布的中心概率区间,还不是“未知总体均值的置信区间”;后者涉及样本和估计量,是另一个问题。
正态曲线左右对称,所以 Φ(−z)=1−Φ(z)。利用这一点可以得到
P(∣X−μ∣≤kσ)=2Φ(k)−1.
当 k=1,2,3 时,数值依次约为 68.27%、95.45% 和 99.73%。它们常被称为经验法则,但在正态模型内部,它们其实是确定的积分数值。对任意一条大致钟形的曲线,则不能直接保证这些比例。
为什么参数真的是均值和方差
标准正态密度记为 ϕ(z)。由于 ∣z∣ϕ(z) 可积,左右对称使
E(Z)=∫−∞∞zϕ(z)dz=0.
这里补上“绝对可积”很有必要:不能看到一个奇函数就把两边可能发散的面积强行抵消。对于正态密度,指数衰减足够快,不存在这个问题。
再利用 ϕ′(z)=−zϕ(z),分部积分得到
E(Z2)=−∫−∞
由 X=μ+σZ,期望为 μ,偏差平方为 σ2Z2,所以方差为 。位置、尺度这两个直觉,现在都有积分计算支撑。
标准化不会改变分布所属的基本形状。均匀变量减均值再除标准差,仍然有一个平顶;指数变量这样处理后,仍然偏斜。只有原变量本来服从正态分布,标准化后才是标准正态分布。
正态为什么常见,又为什么不能随处套用
导论课可能用“许多小误差叠加”解释正态曲线。这个直觉后面会由中心极限定理的一组明确条件来支持。以本课程将证明的独立同分布版本为例,若 Xi 独立同分布且具有有限均值 μ 和有限正方差 σ2,则
σnX
结论说的是经过适当中心化和缩放的和,其分布趋近正态。它没有说任意变量相加都必然正态,也没有说每一项自身会变成正态。共享同一个大干扰的误差、由某一项支配的总量、方差无限的重尾模型,都不能只凭“项数很多”就套用这一版本。
正态支持集是整个实轴。若把只能为正的长度近似成正态,需要检查负数一侧的概率是否小到可以接受;若把比例近似成正态,要检查越过 0 和 1 的概率。身高、成绩和测量误差的现实分布是否近似正态,也需要由具体机制和数据判断,不能当作定理直接宣布。
Gamma 分布:一次等待变成若干次等待之后
从第二次到达开始,密度不再只是下降
指数等待密度在 0 附近最高。现在换一个问题:不是等下一个信号,而是等第三个信号。极短时间里连来三次信号,比只来一次更难,所以总等待时间的密度不应还在 0 附近最高。我们需要一个能先上升、再下降的正值分布。
设一个齐次 Poisson 过程的率为 λ,从时刻 0 起等到第 k 次事件的时间记为 Tk。对 t≥0,
{Tk≤t}={N(t)≥k}.
这是同一件事情的两种问法:要么盯着第 k 次到达的时刻,要么数固定时间内已经来了几次。因此
FTk(t)=1−e
对 t>0 求导,乘积法则产生的两串和式会抵消大部分项,最后留下
fTk(t)=(k−1)!
这就是整数形状的 Gamma 密度,也称 Erlang 密度。当 k=1 时,tk−1=1,退回指数分布。当 k>1 时,t 把靠近 的密度压下去,指数项则让很远处的密度下降,两者共同形成中间的峰。
把整数形状延伸到任意正数
整数 k 可以解释为需要累计的事件个数。为了得到更灵活的正值分布,把它推广成任意 α>0。但 (k−1)! 也要随之推广,于是引入 Gamma 函数
Γ(α)=∫0∞uα−1e−
靠近 0 时,uα−1 可积的条件正是 α>0;在无穷远,指数衰减压过幂的增长。分部积分给出
Γ(α+1)=αΓ(α),Γ(1)=1,
所以对正整数 k,Γ(k)=(k−1)!。现在定义
fT(t)=
这里统一使用形状 α、率 λ。令 u=λt,便有
∫0∞fT(t)dt=
有时公式用尺度参数 θ,它与本章的率满足 θ=1/λ。于是指数项写成 e−t/θ,系数写成 1/(Γ(α)。同一个符号“Gamma 的第二个参数”在不同约定下可能含义相反,计算前要看密度式,不能只看参数位置。
形状和尺度怎样影响曲线
在 t>0 上,对密度取对数再求导,能更容易找峰的位置:
dtdlogfT(t)=t
当 α>1 时,导数在 t=(α−1)/λ 处从正变负,所以这是密度的峰。α=1 时密度指数下降;0 时密度在 附近趋于无穷,然后下降。最后一种情况仍有有限总面积,因为端点处的奇异性可积。
率 λ 主要控制横向尺度。如果 Y=λT,那么 Y∼Gamma(α,1)。固定形状时把率扩大为两倍,就把等待时间整体压缩为一半。
形状不是整数时,比如 α=2.7,分布完全有数学意义,但不能直接把它解释成“等到第 2.7 次事件”。整数阶段等待给了我们认识这个分布的入口,一般形状则扩展了可拟合的正值形状。
用一次矩计算同时得到均值和方差
对满足 r>−α 的实数 r,把 tr 乘进密度并作变量代换,可得
E(Tr)
其中 r>−α 保证靠近 0 的积分收敛。特别取 r=1,2,利用 Gamma 函数递推式,
E(T)=λα,E(T
整数形状下,均值就是 k 段平均长度为 1/λ 的等待相加。标准差与均值的比值为 1/α,所以形状增大时,相对于自身均值的波动会缩小。这里说的是相对波动:固定率时,方差本身仍会随 α 增大。
同率、独立,这两个词不能省略
如果 T1,…,Tk 相互独立,并且每一个都服从 Exp(λ),那么它们的和服从 。更一般地,两个独立 Gamma 变量具有相同率时,形状参数可以相加:
X∼Gamma(α,λ),Y∼Gamma(β,λ)⟹X+
这一结论的卷积证明会在随机变量求和时展开。现在要记住它的适用范围:两道服务流程耗时均为正,不足以保证总时间服从 Gamma;即使每段都是指数,如果率不同,总和通常也不是这个同率 Gamma 族。如果两段共用一个拥堵因素而有依赖,也不能直接套相加规则。
例子:信号按率每小时 4 次的齐次 Poisson 过程到达,问第二次信号是否会在半小时内到达。令 T2∼Gamma(2,4),则半小时内次数的均值为 4×0.5=2,所以
P(T2≤0.5)=P(N(0.5)≥2)=1−
率的单位和时间单位必须匹配。这里若把半小时误写成 30 而仍使用“每小时 4 次”的率,指数里的数就完全错了。
Beta 分布:同一个平均比例,可以有很不一样的不确定性
先分清比例观测与未知概率
一个页面是否被点击,可以用成功概率 p 的 Bernoulli 试验描述。如果 p 已知,它是模型里的固定参数,无须再给它分布。如果我们要用概率模型表达对 p 的不确定性,就可以引入连续随机变量 P,让它的取值在 0 与 1 之间。
这正是 Beta 分布常见的用法之一。它也可以描述本身连续变化的有界比例,但不是“所有比例天然都服从 Beta”。固定 n 次试验中的样本比例有有限个取值;若数据在恰好 0 或 1 处集中着正概率,普通 Beta 密度也表达不了这些端点质量。
两个幂次怎样控制两端
设 α,β>0,Beta 密度定义为
fP(p)=⎩
归一化常数为
B(α,β)=∫01pα−1(1−
靠近 0 时,主要看 pα−1;靠近 1 时,主要看 (1−p)β−1。两参数都大于 ,保证两端的积分有限。于是,参数小于 时可以出现端点附近的高峰,并不违反密度的定义。
例如 Beta(2,2) 的密度是 6p(1−p),关于 1/2 对称,中间单峰;而 Beta(1/2,1/2) 也关于 对称,却在两端附近放了更多概率。
当 α,β>1 时,对数密度的导数是
dpdlogfP(p)=
令它为 0,得到峰的位置
pmode=α+β−2α−1.
这一公式有前提。参数小于 1 时把数字硬塞进去,可能算出区间外的数,或把内部低谷误叫峰。
Beta 函数为什么与 Gamma 函数相连
两个名字相似的函数并不是碰巧共享字母。考虑两个 Gamma 积分的乘积:
Γ(α)Γ(β)=∫0∞∫
令总量 s=u+v、第一部分所占比例 p=u/(u+v),反解得 u=sp、。区域变成 ,面积变换因子为 ,于是
Γ(α)Γ(β)
所以
B(α,β)=Γ(α+β)Γ(α)Γ(β).
这段换元说明了一个很自然的联系:Gamma 描述正的总量时,拆出“其中一部分占总量的比例”,就会出现 Beta 积分。进一步的分布结论是,如果 A、B 独立且分别服从同率的 Gamma(α,λ)、Gamma(β,λ),那么 。以后学习联合变换时,可以沿着这里的“总量加比例”换元把它完整推出来。
不背矩公式,也能把中心和波动算出来
期望的积分比归一化积分只多一个 p,所以可以直接识别成另一个 Beta 函数:
E(P)=B(α,β)B(α+1,β)=
同样,
E(P2)=B(α,β)B
二阶矩减去均值平方,得到
Var(P)=(α+β)2(α+β+1)α
这时可以换一组更容易读懂的参数。令
m=α+βα,κ=α+β,
那么 α=mκ、β=(1−m)κ,并且
E(P)=m,Var(P)=κ+1m(1−m)
固定 m 再增大 κ,分布围绕同一均值的波动会缩小。比如 Beta(3,2) 和 Beta(30,20) 的均值都是 0.6,方差却分别是 和约 。我们可以表达“平均看法一样,但后一种模型的不确定性更小”。
不能省掉“固定均值”这个条件而笼统地说“参数之和越大,方差一定越小”,因为均值同时变化时,分子 m(1−m) 也在变化。两参数也不是一般意义下的真实成功、失败次数;只有放进特定的更新模型后,才会出现与计数相加的解释。
用一个完整概率计算,看见均值以外的信息
设 P∼Beta(2,3)。先算归一化常数:
B(2,3)=4!1!2!=
均值为 2/5=0.4,内部峰却在 1/3,两者不相同。若想知道 P 超过 1/2 的概率,需要积分,不能因为均值低于 1/2 就断言该事件“不可能”或“概率等于 0.4”:
P(P>1/2)
均值只压缩了分布的一部分信息,区间概率仍需要完整的密度。这一点会成为下一章讨论期望时的重要提醒。
还可以预看一下参数与计数如何联系。假设给定 P=p 后,n 次试验条件独立、成功概率均为 p。观察到 s 次成功、n−s 次失败后,关于 p 的条件密度正比于
pα−1(1−p)β−1⋅p
归一化后仍是 Beta 分布,参数变为 α+s、β+n−s。这解释了为什么参数有时会被说成“已有信息加新计数”。不过它来自明确的条件独立模型和密度更新,不能脱离这些假设,把任何 α 都机械当成已经观察到的成功次数。
把五种分布连起来,检查模型有没有多说一句
回头看,这些分布之间的关系已经可以由公式核对。Gamma(1,λ) 是指数分布,Beta(1,1) 是单位区间均匀分布。同率独立指数等待相加得到整数形状 Gamma;同率独立 Gamma 正量相除得到的份额可以是 Beta。均匀变量通过分位数变换,还能生成指数变量。
另一类联系是近似,必须与上面的精确等式分开。大量独立同分布、有限正方差变量的标准化和趋近正态,是极限结论;它没有承诺固定几个变量相加就精确正态。例如两个独立 U(0,1) 变量之和的密度是三角形,而不是正态。以后推导和的密度时,我们会直接看到这件事。
面对一个新问题,可以按下面的顺序检查,但每一步都应当回答具体问题。
例如,若只知道“某任务平均花费十分钟”,五个分布里根本没有哪一个被这个信息唯一决定。若再说明“时间一定在八到十二分钟之间,等长区间等概率”,均匀模型才被完整指定。若说明“任务完成的瞬时率恒定”,指数模型才有了机制依据。平均数很有用,但它不等于完整分布。
练习:把条件、计算和解释一起写完整
区间超出范围之后,怎样计算
设 X∼U(2,10)。求 P(5<X<7)、P(8<X、 和 。令 ,求 的分布,并解释为什么 不再均匀。
第一个区间完全位于支持集内,长度为 2,所以概率是 2/8=1/4。第二个区间先与 [2,10] 取交集,真正可取的部分是 (8,10],概率同样是 1/4,不是 。
已经等了四分钟,题目究竟在问什么
设 T∼Exp(1/6),单位为分钟。分别求 P(T>10∣T>4) 和“已经等了四分钟后,还要再等超过十分钟”的概率。再求等待时间的中位数。
第一问的总时间门槛是 10 分钟,已知已等 4 分钟,所以剩余门槛为 6 分钟:
P(T>10∣T>4)正态参数中的平方,不能多除或少除一次
设读数 X∼N(120,42)。求 P(116<X<128),并求一个以 120 为中心、覆盖 模型概率的区间。给定 、、。
标准差是 4。标准化两端分别得到 −1 和 2,所以
P(116<X<128)=Φ(2)等第三次到达,与一小时内恰好三次相同吗
信号构成每小时率为 2 的齐次 Poisson 过程,令 T3 为第三次信号的到达时间。求 E(T3)、Var( 和 。解释为什么最后一个概率不是 。
T3∼Gamma(3,2),这里第二个参数是率。因此
E(TGamma 的参数相加,缺少条件会发生什么
设 X 和 Y 独立,分别服从 Exp(1) 和 Exp(2)。有人说“两个指数相加,所以 X+Y∼”。用均值否定这个结论;再说明把率换成 ,让均值匹配,是否足以得到正确的 Gamma 分布。
实际均值是 E(X+Y)=1+1/2=3/2,而 Gamma(2,1) 的均值是 2,已经不符。
若改成 ,均值确实等于 ,但其方差为
同均值的两个 Beta 模型,到底差在哪儿
比较 P∼Beta(3,2) 与 Q∼Beta(30,20) 的均值、方差,并计算 P(P>1/2。最后判断:若某次实验在十次访问中观察到八次点击,样本比例 是否因此服从 ?
两个模型的均值都是 3/5=0.6。由 m=0.6,集中度分别为 5 和 50,
我们现在已经能给一个连续模型写出完整密度,计算区间概率,并检查它的参数和假设。接下来的问题会换一个方向:完整分布包含太多信息时,我们怎样用少数几个数概括中心和波动?本章已经算过的均值与方差,就是入口。下一章会把这些计算从五个具体分布里抽出来,解释期望为何必须按概率加权,以及这种“压缩分布”的做法保留了什么、又丢掉了什么。