中心极限定理、正态近似与综合建模
上一章已经替我们解决了一个悬了很久的问题:独立重复试验时,为什么频率会靠近概率,样本均值会靠近期望。过去凭直觉接受的“多做几次就会稳定”,终于有了大数定律作依据。不过,“会靠近”还没有回答另一件实际问题:做了这么多次,现在剩下的误差大约有多大?偏高和偏低的可能性又怎样分配?
例如,一次服务的耗时可能很不对称:大多数订单几分钟就完成,少数订单要等很久。一天完成几百个订单以后,平均耗时通常稳定了,但它不可能每次都刚好等于理论均值。我们要研究的,就是平均值周围这团还在晃动的误差。
中心极限定理把镜头对准这团误差。它先减去中心,再按误差本来的大小调整刻度,最后发现:对于独立同分布、方差有限且不为零的观测,这个经过调整的误差分布趋向标准正态分布。单次服务可以依旧右偏,硬币结果可以始终只有两个值;改变形状的是许多观测的和或平均值。
这一章会把“趋向”真正写清楚,也会追问为什么偏偏是正态分布。等我们把证明走完,再回来算抽样误差、计数概率和模拟误差,就能知道每一步近似借用了哪些条件。
平均值越来越稳,误差为什么还值得研究
先看一个很熟悉的模型。独立抛掷正面概率为 p p p X i X_i X i i i i 1 1 1 0 0 0
X ˉ n = X 1 + ⋯ + X n n . \bar X_n=\frac{X_1+\cdots+X_n}{n}. X ˉ n = n X 1 + 大数定律说,对任何固定的容许误差 ε > 0 \varepsilon>0 ε > 0
P ( ∣ X ˉ n − p ∣ > ε ) ⟶ 0. P(|\bar X_n-p|>\varepsilon)\longrightarrow0. P ( ∣ X ˉ n − p ∣ > ε ) ⟶ 0. 这里的关键词是“固定”。如果容许误差一直是 0.05 0.05 0.05 n n n
这时方差提供了一条线索。单次硬币结果的方差是 p ( 1 − p ) p(1-p) p ( 1 − p )
Var ( X ˉ n ) = p ( 1 − p ) n , SD ( X ˉ n ) = p ( 1 − p ) n . \operatorname{Var}(\bar X_n)=\frac{p(1-p)}{n},
\qquad
\operatorname{SD}(\bar X_n)=\sqrt{\frac{p(1-p)}{n}}. Var ( X ˉ n ) = n 所以,一个与误差自然大小相配的窗口是“中心左右若干个标准差”。对于公平硬币,抛 100 100 100 0.05 0.05 0.05 10 000 10\,000 10 000 0.005 0.005 0.005
如果我们把误差除以各自的标准差,就能比较两个实验。原来 0.05 0.05 0.05 0.005 0.005 0.005
大数定律与中心极限定理因而并不重复:前者说明固定窗口外的概率趋于零,后者刻画按 1 / n 1/\sqrt n 1/ n
先把中心和尺度算对
把硬币推广成一般观测。设 X 1 , X 2 , … X_1,X_2,\ldots X 1 , X 2 , …
E ( X i ) = μ , Var ( X i ) = σ 2 , 0 < σ 2 < ∞ . E(X_i)=\mu,\qquad \operatorname{Var}(X_i)=\sigma^2,
\qquad 0<\sigma^2<\infty. E ( X i ) = μ , Var ( X i ) = σ 我们同时保留总和与均值两种写法:
S n = ∑ i = 1 n X i , X ˉ n = S n n . S_n=\sum_{i=1}^nX_i,
\qquad
\bar X_n=\frac{S_n}{n}. S n = i = 1 ∑ n X i 期望线性性不需要独立性,直接给出 E ( S n ) = n μ E(S_n)=n\mu E ( S n ) = n μ
Var ( S n ) = ∑ i = 1 n Var ( X i ) + 2 ∑ i < j Cov ( X i , X j ) . \operatorname{Var}(S_n)
=\sum_{i=1}^n\operatorname{Var}(X_i)
+2\sum_{i<j}\operatorname{Cov}(X_i,X_j). Var ( S n ) = i = 1 ∑ n 现在有独立性,协方差项才全部消失,得到 Var ( S n ) = n σ 2 \operatorname{Var}(S_n)=n\sigma^2 Var ( S n ) = n σ 2 Var ( a X ) = a 2 Var ( X ) \operatorname{Var}(aX)=a^2\operatorname{Var}(X) Var ( a X ) =
总和的波动在变大,平均值的波动在变小,这两件事完全相容。总工作量增加时,超过平均总量几分钟并不奇怪;但分摊到每个订单以后,这几分钟的影响就小了。
标准化就是先减去对应的中心,再除以对应的标准差:
Z n = S n − n μ σ n = X ˉ n − μ σ / n = n ( X ˉ n − μ ) σ . Z_n=\frac{S_n-n\mu}{\sigma\sqrt n}
=\frac{\bar X_n-\mu}{\sigma/\sqrt n}
=\frac{\sqrt n(\bar X_n-\mu)}{\sigma}. Z n = σ n 请亲手核对中间那一步:把第一个分式的分子和分母同时除以 n n n
对每一个 n n n E ( Z n ) = 0 E(Z_n)=0 E ( Z n ) = 0 Var ( Z n ) = 1 \operatorname{Var}(Z_n)=1 Var ( Z n )
若观测单位是分钟,σ \sigma σ σ n \sigma\sqrt n σ n σ 2 \sigma^2
把中心极限定理逐字读清楚
在刚才的独立同分布、有限正方差条件下,中心极限定理断言
Z n = S n − n μ σ n → d Z , Z ∼ N ( 0 , 1 ) . Z_n=\frac{S_n-n\mu}{\sigma\sqrt n}
\xrightarrow{d}Z,
\qquad Z\sim N(0,1). Z n = σ n 这里的 N ( 0 , 1 ) N(0,1) N ( 0 , 1 )
Φ ( x ) = 1 2 π ∫ − ∞ x e − u 2 / 2 d u . \Phi(x)=\frac{1}{\sqrt{2\pi}}\int_{-\infty}^{x}e^{-u^2/2}\,du. Φ ( x ) = 2 π 由于 Φ \Phi Φ x x x
P ( Z n ≤ x ) ⟶ Φ ( x ) . P(Z_n\le x)\longrightarrow\Phi(x). P ( Z n ≤ x ) ⟶ Φ ( x ) . 于是,对固定的 a < b a<b a < b
P ( a < Z n ≤ b ) ⟶ Φ ( b ) − Φ ( a ) . P(a<Z_n\le b)\longrightarrow\Phi(b)-\Phi(a). P ( a < Z n ≤ b ) ⟶ Φ ( b ) − Φ ( a ) . 定理说的是分布函数和区间概率的趋近。它没有说某次模拟出来的 Z n Z_n Z n Z n Z_n Z n
离散的变量怎样趋近连续分布
如果每个 X i X_i X i 0 0 0 1 1 1 S n S_n S n Z n Z_n
关键在于相邻格点的间距。标准化后,相邻成功次数之间相差
Δ z = 1 n p ( 1 − p ) . \Delta z=\frac{1}{\sqrt{np(1-p)}}. Δ z = n p ( 1 − p ) 1 固定 0 < p < 1 0<p<1 0 < p < 1
因此,看到直方图接近钟形时,要读成“区间里的概率接近”。一般的中心极限定理不直接保证每个点的概率可以用密度值代替,也不直接保证原有密度逐点收敛。要研究单点概率或密度本身的细致近似,需要更强的局部结论。
三个条件分别排除了什么
“同分布”表示每次观测来自同一概率规律,使 μ \mu μ σ 2 \sigma^2 σ 2 σ n \sigma\sqrt n σ n
如果 σ 2 = 0 \sigma^2=0 σ 2 = 0 X i = μ X_i=\mu X i = μ
反过来,原分布并不需要对称,不需要连续,不需要有密度,也不需要所有高阶矩都存在。一个分布可以右偏、带原子、带较长尾巴;只要满足本版条件,结论仍然成立。至于有限样本要等多久才能近似得好,定理暂时还没有给答案。
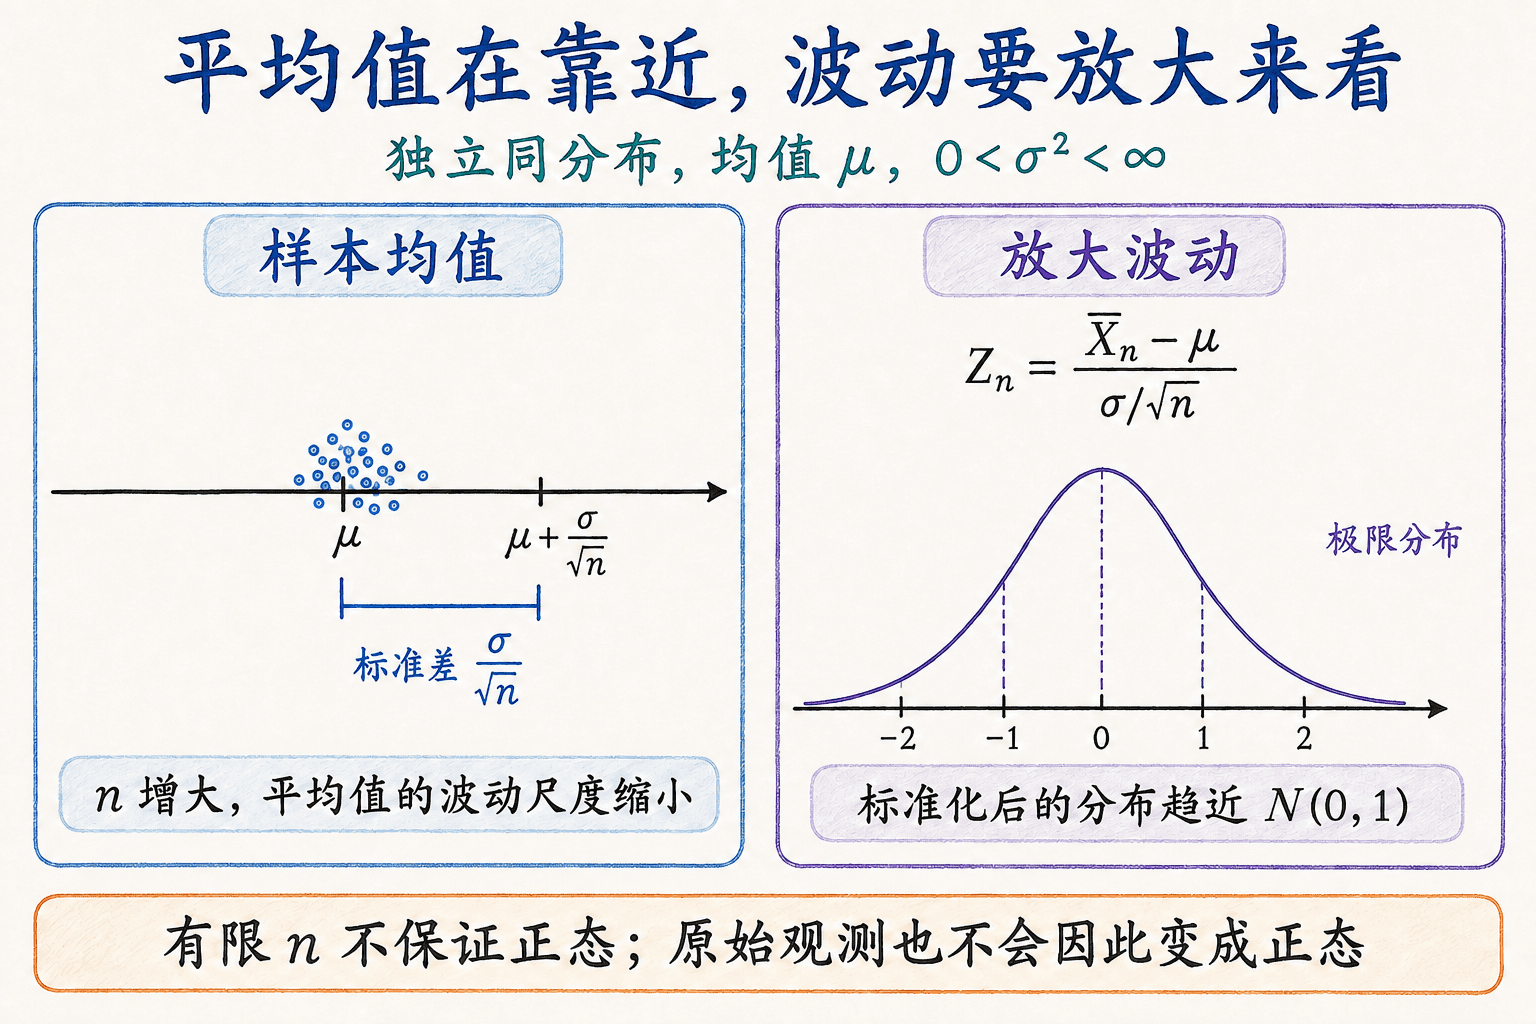
把这两种尺度并排看,就能接上上一章的大数定律:平均值本身越来越集中,中心极限定理则把缩小的波动重新放大,研究放大后的分布形状。右边画的是极限分布;有限样本的分布未必已经是一条正态曲线。
独立同分布且方差有限、非零时,样本均值围绕μ的波动尺度按σ/√n缩小。把这份波动放大到单位尺度后,标准化统计量的分布趋近N(0,1);有限样本及原始观测不因此必然正态。 为什么最后留下的是正态分布
我们在随机变量和的讨论里已经遇到过一个麻烦:卷积一次还好,连续卷积几十次,公式很快就难以处理。证明中心极限定理时,可以换到特征函数这一边,让“独立随机变量求和”变成“函数相乘”。下面把用到的性质和推导都展开,不必先记住整套特征函数理论。
对实随机变量 Y Y Y
φ Y ( t ) = E ( e i t Y ) = E ( cos ( t Y ) ) + i E ( sin ( t Y ) ) , t ∈ R . \varphi_Y(t)=E(e^{itY})
=E(\cos(tY))+iE(\sin(tY)),\qquad t\in\mathbb R. φ Y ( t ) = E ( e i t Y ) = 这里 i 2 = − 1 i^2=-1 i 2 = − 1 ∣ e i t Y ∣ = 1 |e^{itY}|=1 ∣ e i t Y ∣ = 1 E ( e t Y ) E(e^{tY}) E (
独立性给它带来了所需的运算性质。如果 Y 1 , … , Y n Y_1,\ldots,Y_n Y 1 , … , Y n
E ( e i t ( Y 1 + ⋯ + Y n ) ) = E ( ∏ j = 1 n e i t Y j ) = ∏ j = 1 n E ( e i t Y j ) . E\left(e^{it(Y_1+\cdots+Y_n)}\right)
=E\left(\prod_{j=1}^ne^{itY_j}\right)
=\prod_{j=1}^nE(e^{itY_j}). E ( e i t ( Y 1 + ⋯ + Y 这就是独立性在证明中真正工作的地方。若这些变量还同分布,右边就成为同一个特征函数的 n n n
有限二阶矩怎样决定零点附近的形状
先将单次观测标准化,令
Y i = X i − μ σ . Y_i=\frac{X_i-\mu}{\sigma}. Y i = σ X i − μ . 于是 E ( Y i ) = 0 E(Y_i)=0 E ( Y i ) = 0 E ( Y i 2 ) = 1 E(Y_i^2)=1 E ( Y i 2 ) = 1
从微积分的二阶展开出发,我们预计
φ ( u ) = 1 + i u E ( Y 1 ) − u 2 2 E ( Y 1 2 ) + o ( u 2 ) = 1 − u 2 2 + o ( u 2 ) , u → 0. \varphi(u)=1+iuE(Y_1)-\frac{u^2}{2}E(Y_1^2)+o(u^2)
=1-\frac{u^2}{2}+o(u^2),\qquad u\to0. φ ( u ) = 1 + i u E ( Y 1 ) − 这里 o ( u 2 ) o(u^2) o ( u 2 ) u 2 u^2 u 2 E ∣ Y 1 ∣ 3 E|Y_1|^3 E ∣ Y 1 ∣
可以用一个更合适的余项写法。定义
r ( v ) = e i v − 1 − i v + v 2 / 2 v 2 ( v ≠ 0 ) , r ( 0 ) = 0. r(v)=\frac{e^{iv}-1-iv+v^2/2}{v^2}\quad(v\ne0),
\qquad r(0)=0. r ( v ) = v 2 e i v 二阶展开说明 r ( v ) → 0 r(v)\to0 r ( v ) → 0 v → 0 v\to0 v → 0 r r r v 2 v^2 v 2
φ ( u ) − 1 + u 2 / 2 u 2 = E [ Y 1 2 r ( u Y 1 ) ] ⟶ 0. \frac{\varphi(u)-1+u^2/2}{u^2}
=E\bigl[Y_1^2r(uY_1)\bigr]\longrightarrow0. u 2 φ ( u ) − 1 + u 2 /2 最后的极限由控制收敛得到:对每个有限的 Y 1 Y_1 Y 1 r ( u Y 1 ) r(uY_1) r ( u Y 1 ) Y 1 2 Y_1^2 Y 1
把许多小因子乘起来
根据独立性与同分布性,
φ Z n ( t ) = [ φ ( t n ) ] n . \varphi_{Z_n}(t)
=\left[\varphi\left(\frac{t}{\sqrt n}\right)\right]^n. φ Z n ( t ) = [ φ ( 固定 t t t n → ∞ n\to\infty n → ∞ t / n t/\sqrt n t / n
φ Z n ( t ) = [ 1 − t 2 2 n + o ( 1 n ) ] n ⟶ e − t 2 / 2 . \varphi_{Z_n}(t)
=\left[1-\frac{t^2}{2n}+o\left(\frac1n\right)\right]^n
\longrightarrow e^{-t^2/2}. φ Z n ( t ) = [ 1 − 这一步使用的是熟悉的指数极限。更精确地,令括号中超过 1 1 1 a n a_n a n n a n → − t 2 / 2 na_n\to-t^2/2 n a n → − t 2
而 e − t 2 / 2 e^{-t^2/2} e − t 2 /2 Z n → d N ( 0 , 1 ) Z_n\xrightarrow{d}N(0,1) Z n d
现在回头看这段证明,正态分布出现的原因就不只是“很多图看起来像钟形”了。中心化消掉了一阶项,标准化把二阶项固定成 − u 2 / 2 -u^2/2 − u 2 /2 e − t 2 / 2 e^{-t^2/2} e − t 2 /2
这里确实使用了一个没有展开证明的桥梁——特征函数连续性定理。它负责从函数极限回到分布极限;前面的计算则解释了 CLT 的主要机制,以及为什么有限正方差会成为自然条件。
用模拟看见定理,也分清两个次数
下面的模拟器每次生成 n n n m m m m m m
增加 n n n σ / n \sigma/\sqrt n σ / n m m m n = 1 n=1 n =
先选指数分布,保持重复次数不变,把样本量从 1 1 1 10 10 10 100 100 100 1 1 1 N ( μ , σ 2 / n ) N(\mu,\sigma^2/n) N ( μ , σ 2 / n )
再切换到偏斜两点分布:P ( X = 0 ) = 0.85 P(X=0)=0.85 P ( X = 0 ) = 0.85 P ( X = 6 ) = 0.15 P(X=6)=0.15 P ( X = 6 ) = 0.15 0.9 0.9 0.9 36 × 0.15 − 0.9 2 = 4.59 36\times0.15-0.9^2=4.59
模拟能帮助我们发现模式、检查计算,但没有代替证明。即使某次直方图恰好非常漂亮,它也只对应当前分布、当前参数与有限的随机样本。
从目标事件开始做正态近似
现在回到平均耗时、平均重量等计算。正确的顺序是先确定变量及其联合假设,写出目标事件,再用中心与尺度把这个事件翻译到标准正态尺上。
若题目问 S n ≤ c S_n\le c S n ≤ c ( c − n μ ) / ( σ n ) (c-n\mu)/(\sigma\sqrt n) ( c − n μ ) / ( σ n
平均重量的误差
设一袋产品的重量均值为 500 500 500 12 12 12 64 64 64 497 497 497 503 503 503
首先,均值和标准差有精确公式:
E ( X ˉ 64 ) = 500 , SD ( X ˉ 64 ) = 12 8 = 1.5. E(\bar X_{64})=500,
\qquad
\operatorname{SD}(\bar X_{64})=\frac{12}{8}=1.5. E ( X ˉ 64 ) = 500 , SD ( X ˉ 这里还没有使用正态近似。接下来,把事件等价改写:
P ( 497 ≤ X ˉ 64 ≤ 503 ) = P ( − 2 ≤ X ˉ 64 − 500 1.5 ≤ 2 ) . P(497\le\bar X_{64}\le503)
=P\left(-2\le\frac{\bar X_{64}-500}{1.5}\le2\right). P ( 497 ≤ X ˉ 64 ≤ 503 ) = P ( − 直到最后一步,我们才使用中心极限定理,把标准化均值的分布换成标准正态:
P ( 497 ≤ X ˉ 64 ≤ 503 ) ≈ Φ ( 2 ) − Φ ( − 2 ) ≈ 0.9545. P(497\le\bar X_{64}\le503)
\approx\Phi(2)-\Phi(-2)
\approx0.9545. P ( 497 ≤ X ˉ 64 ≤ 503 ) ≈ Φ ( 2 ) − Φ 这个约 95.45 % 95.45\% 95.45% 64 64 64 n n n
上一章的切比雪夫不等式也能处理同一事件。它给出
P ( ∣ X ˉ 64 − 500 ∣ ≥ 3 ) ≤ 12 2 64 × 3 2 = 1 4 . P(|\bar X_{64}-500|\ge3)
\le\frac{12^2}{64\times3^2}=\frac14. P ( ∣ X ˉ 64 − 500∣ ≥ 3 ) ≤ 这说明落在开区间 ( 497 , 503 ) (497,503) ( 497 , 503 ) 0.75 0.75 0.75 0.75 0.75 0.75 0.9545 0.9545 0.9545
为指定精度选择样本量
如果希望平均重量与 500 500 500 ε \varepsilon ε 95 % 95\% 95%
1.96 σ n ≤ ε , n ≥ ( 1.96 σ ε ) 2 . 1.96\frac{\sigma}{\sqrt n}\le\varepsilon,
\qquad
n\ge\left(\frac{1.96\sigma}{\varepsilon}\right)^2. 1.96 n σ ≤ ε , 取 σ = 12 \sigma=12 σ = 12 ε = 2 \varepsilon=2 ε = 2 138.2976 138.2976 138.2976 139 139 139
如果需要仅靠方差的严格保证,切比雪夫要求 σ 2 / ( n ε 2 ) ≤ 0.05 \sigma^2/(n\varepsilon^2)\le0.05 σ 2 / ( n ε 2 ) ≤ 0.05 n ≥ 720 n\ge720 n ≥ 720
二项分布:先对齐整数格子,再查正态面积
设 B n ∼ Bin ( n , p ) B_n\sim\operatorname{Bin}(n,p) B n ∼ Bin ( n , p ) 0 < p < 1 0<p<1 0 < p < 1 n n n
B n − n p n p ( 1 − p ) → d N ( 0 , 1 ) . \frac{B_n-np}{\sqrt{np(1-p)}}\xrightarrow{d}N(0,1). n p ( 1 − p ) B 因此,在近似适用时,可以用 Y ∼ N ( n p , n p ( 1 − p ) ) Y\sim N(np,np(1-p)) Y ∼ N ( n p , n p ( 1 − p )) n p np n p n ( 1 − p ) n(1-p) n ( 1 − p )
为什么要两边都检查?即使试验次数很大,若预期成功次数只有几个,成功次数仍然明显右偏;若预期失败次数只有几个,则会明显左偏。只有 n n n
连续性校正究竟在校正什么
把整数 k k k [ k − 0.5 , k + 0.5 ) [k-0.5,k+0.5) [ k − 0.5 , k + 0.5 ) k k k
例如事件 45 ≤ B n ≤ 55 45\le B_n\le55 45 ≤ B n ≤ 55 45 45 45 55 55 55 [ 44.5 , 55.5 ) [44.5,55.5) [ 44.5 , 55.5 )
对整数 a , b , k a,b,k a , b , k
这里最容易出错的是“超过”与“至少”。先把文字改成准确的整数事件,再移动边界,远比背“加半还是减半”可靠。如果计数间距是 h h h h / 2 h/2 h /2 0.5 0.5 0.5
至少 220 次成功
设 B ∼ Bin ( 400 , 0.52 ) B\sim\operatorname{Bin}(400,0.52) B ∼ Bin ( 400 , 0.52 ) 400 400 400 P ( B ≥ 220 ) P(B\ge220) P ( B ≥ 220 )
均值为 208 208 208 400 × 0.52 × 0.48 = 99.84 400\times0.52\times0.48=99.84 400 × 0.52 × 0.48 = 99.84 9.992 9.992 9.992 219.5 219.5 219.5
P ( B ≥ 220 ) ≈ 1 − Φ ( 219.5 − 208 99.84 ) ≈ 1 − Φ ( 1.1509 ) ≈ 0.1249. P(B\ge220)
\approx1-\Phi\left(\frac{219.5-208}{\sqrt{99.84}}\right)
\approx1-\Phi(1.1509)
\approx0.1249. P ( B ≥ 220 ) ≈ 1 − Φ ( 99.84 若不校正,就会把界限放在 220 220 220 1.2010 1.2010 1.2010 0.1149 0.1149 0.1149
在比较器里先保持 n = 80 n=80 n = 80 p = 0.35 p=0.35 p = 0.35 [ a , a ] [a,a] [ a , a ] P ( B = a ) = 0 P(B=a)=0 P ( B = a ) =
再把 p p p 0.01 0.01 0.01
稀有成功时,另一个极限可能更合适
当 p p p n n n p n = 2 / n p_n=2/n p n = 2/ n n → ∞ n\to\infty n → ∞ n p n = 2 np_n=2
这也解释了二项近似的选择:成功和失败两侧都充足时可考虑正态;成功很稀少而次数很多时可考虑泊松;如果可以稳定地计算二项概率,直接计算往往更合适。近似的价值在于解释结构和简化计算,不在于替代已经容易得到的精确答案。
泊松分布:大参数为何接近正态
若 Q λ ∼ Pois ( λ ) Q_\lambda\sim\operatorname{Pois}(\lambda) Q λ ∼ Pois ( λ )
E ( Q λ ) = Var ( Q λ ) = λ . E(Q_\lambda)=\operatorname{Var}(Q_\lambda)=\lambda. E ( Q λ ) = Var ( Q λ ) = λ . 我们已经知道独立泊松变量相加,参数也相加。特别地,当 λ \lambda λ m m m Q m Q_m Q m m m m Pois ( 1 ) \operatorname{Pois}(1) Pois ( 1 )
Q m − m m → d N ( 0 , 1 ) . \frac{Q_m-m}{\sqrt m}\xrightarrow{d}N(0,1). m Q m 对于一般实数 λ → ∞ \lambda\to\infty λ → ∞ λ = m + r \lambda=m+r λ = m + r m = ⌊ λ ⌋ m=\lfloor\lambda\rfloor m = ⌊ λ ⌋ 0 ≤ r < 1 0\le r<1 0 ≤
Q λ − λ λ = m λ Q m − m m + R r − r λ . \frac{Q_\lambda-\lambda}{\sqrt\lambda}
=\sqrt{\frac m\lambda}\frac{Q_m-m}{\sqrt m}
+\frac{R_r-r}{\sqrt\lambda}. λ Q 第一个系数趋于 1 1 1 r / λ ≤ 1 / λ r/\lambda\le1/\lambda r / λ ≤ 1/ λ
Q λ − λ λ → d N ( 0 , 1 ) , λ → ∞ . \frac{Q_\lambda-\lambda}{\sqrt\lambda}\xrightarrow{d}N(0,1),
\qquad \lambda\to\infty. λ Q λ 因此,大参数时使用 N ( λ , λ ) N(\lambda,\lambda) N ( λ , λ )
一分钟内至少 45 次到达
假设某分钟内的到达数确实可建模为 Q ∼ Pois ( 36 ) Q\sim\operatorname{Pois}(36) Q ∼ Pois ( 36 ) 6 6 6 Q ≥ 45 Q\ge45 Q ≥ 45 44.5 44.5 44.5
P ( Q ≥ 45 ) ≈ 1 − Φ ( 44.5 − 36 6 ) = 1 − Φ ( 1.4167 ) ≈ 0.0783. P(Q\ge45)
\approx1-\Phi\left(\frac{44.5-36}{6}\right)
=1-\Phi(1.4167)
\approx0.0783. P ( Q ≥ 45 ) ≈ 1 − Φ ( 6 44.5 − 36 ) 保留“近似”很必要。泊松分布偏度为 1 / λ 1/\sqrt\lambda 1/ λ 0.0819 0.0819 0.0819
当 λ \lambda λ λ \lambda λ
最后别忘了检查泊松模型本身。到达强度若随着时段明显变化,或者许多到达由同一个事件触发,“均值等于方差”的假设就可能不合适。正态近似再准确,也只是在近似那个已经选定的泊松模型。
多大才算大:近似速度与真正的反例
经常有人把中心极限定理缩成一句“样本量超过 30 就正态了”。这句话省掉的,恰好是使用中最需要判断的部分。不同分布的尾部和偏斜差别很大,而且中心附近概率与极端尾概率对误差的要求也不同,没有一个对所有有限方差分布都适用的小样本门槛。
三阶绝对矩给出一条误差界
在 iid、有限正方差之外,再假设
ρ = E ∣ X 1 − μ ∣ 3 < ∞ . \rho=E|X_1-\mu|^3<\infty. ρ = E ∣ X 1 − μ ∣ 3 < ∞. 则存在与分布及 n n n C C C
sup x ∈ R ∣ P ( Z n ≤ x ) − Φ ( x ) ∣ ≤ C ρ σ 3 n . \sup_{x\in\mathbb R}
\left|P(Z_n\le x)-\Phi(x)\right|
\le\frac{C\rho}{\sigma^3\sqrt n}. x ∈ R sup ∣ P ( Z n ≤ x ) − Φ ( x ) 这是 Berry–Esseen 型误差界。我们用它理解数量关系,不追求最优常数。ρ / σ 3 \rho/\sigma^3 ρ / σ 3
这条界控制分布函数的绝对误差。对区间概率,由两个端点的分布函数相减,误差可用两倍右端控制。可是如果真实尾概率只有百万分之一,哪怕绝对误差上界是千分之一,对那个尾概率仍然没有足够精度。不能把一个绝对误差很小的结论,直接读成“每个罕见事件的相对误差都小”。
有限二阶矩已经足够 CLT 成立,三阶绝对矩有限是这里得到明确 1 / n 1/\sqrt n 1/ n
有限方差也可能很慢
考虑 X ∼ Bernoulli ( 10 − 6 ) X\sim\operatorname{Bernoulli}(10^{-6}) X ∼ Bernoulli ( 1 0 − 6 ) n = 1000 n=1000 n = 1000
P ( S 1000 = 0 ) = ( 1 − 10 − 6 ) 1000 ≈ 0.9990005. P(S_{1000}=0)=(1-10^{-6})^{1000}\approx0.9990005. P ( S 1000 = 0 ) = ( 1 − 1 0 − 6 ) 也就是说,超过 99.9 % 99.9\% 99.9% n n n
重尾:大数成立,正态尺度却可能失效
若独立同分布的 X i X_i X i
P ( X i > x ) = x − α , x ≥ 1 , 1 < α < 2 , P(X_i>x)=x^{-\alpha},\qquad x\ge1,
\qquad 1<\alpha<2, P ( X i > x ) = x − α , x ≥ 1 , 则期望 α / ( α − 1 ) \alpha/(\alpha-1) α / ( α − 1 ) σ \sigma σ
更直接的例子是标准柯西分布。它的特征函数为 e − ∣ t ∣ e^{-|t|} e − ∣ t ∣
φ X ˉ n ( t ) = ( e − ∣ t ∣ / n ) n = e − ∣ t ∣ . \varphi_{\bar X_n}(t)
=\left(e^{-|t|/n}\right)^n=e^{-|t|}. φ X ˉ n ( t ) = ( 所以无论平均多少次,平均值仍是同一个标准柯西分布。它既不变得越来越集中,也不趋向正态;这里连有限期望条件也没有满足。说“任何分布加起来都会正态”,会直接撞上这个反例。
依赖:多记几份同一个结果不增加信息
令 Y Y Y − 1 -1 − 1 1 1 1 X i = Y X_i=Y X i = Y X i X_i X
S n = n Y , X ˉ n = Y , Var ( S n ) = n 2 . S_n=nY,\qquad \bar X_n=Y,
\qquad \operatorname{Var}(S_n)=n^2. S n = nY , X ˉ n = 若误套独立情形的分母,得到 S n / n = n Y S_n/\sqrt n=\sqrt nY S n / n = n
实际模型中的共同天气、共同设备故障、同一批次偏移,都是要检查的依赖来源。较弱的依赖在附加条件下可以有其他 CLT,但方差尺度通常需要计入协方差,不能自动沿用 σ / n \sigma/\sqrt n σ / n
不同分布相加时,不能让某一项控制全场
同分布不是所有 CLT 的必要要求,不过去掉它以后需要另作检查。设独立变量 X i X_i X i μ i \mu_i μ i
s n 2 = ∑ i = 1 n Var ( X i ) > 0. s_n^2=\sum_{i=1}^n\operatorname{Var}(X_i)>0. s n 2 = i = 1 ∑ n Var ( X 一种足以得到标准正态极限的条件是:对每个 ε > 0 \varepsilon>0 ε > 0
1 s n 2 ∑ i = 1 n E [ ( X i − μ i ) 2 1 { ∣ X i − μ i ∣ > ε s n } ] ⟶ 0. \frac1{s_n^2}\sum_{i=1}^n
E\left[(X_i-\mu_i)^2
\mathbf1_{\{|X_i-\mu_i|>\varepsilon s_n\}}\right]
\longrightarrow0. s n 2 1 这就是林德伯格条件的一种写法。它要求:超过总标准差某个固定比例的大跳跃,对总方差的贡献最终可以忽略。在这个条件下,( ∑ X i − ∑ μ i ) / s n → d N ( 0 , 1 ) (\sum X_i-\sum\mu_i)/s_n\xrightarrow{d}N(0,1) ( ∑ X i − ∑ μ i ) / s n
例如,每一行包含 n n n ± n \pm\sqrt n ± n n − 1 n-1 n − 1 ± 1 \pm1 ± 1
这也是解释现实钟形数据时应保持的准确程度。测量误差若能写成许多满足相应条件的小误差之和,正态模型就有理由;人的身高、考试成绩是否适用,还要核对加法结构、群体组成与依赖关系。单凭“影响因素很多”不能直接证明它们正态。
蒙特卡洛:用定理给模拟结果配上误差尺度
前面把概率当作模型给出的量来计算,现在反过来:如果一个概率或期望太难直接算,能不能通过模拟估计它?
假设目标是 θ = E ( Y ) \theta=E(Y) θ = E ( Y ) Y 1 , … , Y m Y_1,\ldots,Y_m Y 1 , … , Y m
θ ^ m = 1 m ∑ i = 1 m Y i \hat\theta_m=\frac1m\sum_{i=1}^mY_i θ ^ m = m 1 i = 估计 θ \theta θ E ∣ Y ∣ < ∞ E|Y|<\infty E ∣ Y ∣ < ∞ 0 < τ 2 = Var ( Y ) < ∞ 0<\tau^2=\operatorname{Var}(Y)<\infty 0 < τ 2 = Var ( Y ) <
θ ^ m − θ τ / m → d N ( 0 , 1 ) . \frac{\hat\theta_m-\theta}{\tau/\sqrt m}\xrightarrow{d}N(0,1). τ / m θ 因此,估计量的标准误差是 τ / m \tau/\sqrt m τ / m Y Y Y τ \tau τ
未知方差为什么可以用样本方差替换
通常 τ \tau τ
s m 2 = 1 m − 1 ∑ i = 1 m ( Y i − θ ^ m ) 2 . s_m^2=\frac1{m-1}\sum_{i=1}^m(Y_i-\hat\theta_m)^2. s m 2 = m − 1 1 把它改写成
s m 2 = m m − 1 ( 1 m ∑ i = 1 m Y i 2 − θ ^ m 2 ) . s_m^2=\frac m{m-1}
\left(\frac1m\sum_{i=1}^mY_i^2-\hat\theta_m^2\right). s m 2 = m − 1 m ( 由于 E ( Y 2 ) < ∞ E(Y^2)<\infty E ( Y 2 ) < ∞ Y i Y_i Y i Y i 2 Y_i^2 Y i
再把标准化误差写成
θ ^ m − θ s m / m = θ ^ m − θ τ / m ⋅ τ s m . \frac{\hat\theta_m-\theta}{s_m/\sqrt m}
=\frac{\hat\theta_m-\theta}{\tau/\sqrt m}\cdot\frac\tau{s_m}. s m / m 第一项依分布趋于标准正态,第二项依概率趋于 1 1 1 s m / m s_m/\sqrt m s m / m
由此得到常用的近似区间
θ ^ m ± 1.96 s m m . \hat\theta_m\pm1.96\frac{s_m}{\sqrt m}. θ ^ m ± 1.96 m 这里约 95 % 95\% 95% 95 % 95\% 95% θ \theta θ 95 % 95\% 95%
若原观测恰好正态,使用样本标准差后的统计量在有限样本下有精确的 t m − 1 t_{m-1} t m − 1
用一个单位方形算概率
独立生成 U , V ∼ U ( 0 , 1 ) U,V\sim U(0,1) U , V ∼ U ( 0 , 1 ) P ( U + V > 1.2 ) P(U+V>1.2) P ( U + V > 1.2 )
Y = 1 { U + V > 1.2 } . Y=\mathbf1_{\{U+V>1.2\}}. Y = 1 { U + V > 1.2 } . 这就把概率问题改成 E ( Y ) E(Y) E ( Y ) 0.8 0.8 0.8 θ = 0.8 2 / 2 = 0.32 \theta=0.8^2/2=0.32 θ = 0. 8 2 /2 = 0.32 τ 2 = 0.32 × 0.68 = 0.2176 \tau^2=0.32\times0.68=0.2176 τ
如果模拟 m = 10 000 m=10\,000 m = 10 000
0.2176 10 000 ≈ 0.004665. \sqrt{\frac{0.2176}{10\,000}}\approx0.004665. 10 000 0.2176 ≈ 0.004665. 近似 95 % 95\% 95% 0.00914 0.00914 0.00914 0.91 0.91 0.91 40 000 40\,000 40 000 1 / 2 1/\sqrt2 1/ 2
更一般地,估计概率 p p p p ( 1 − p ) ≤ 1 / 4 p(1-p)\le1/4 p ( 1 − p ) ≤ 1/4 1 / ( 2 m ) 1/(2\sqrt m) 1/ ( 2 m
在实验室中选择 P ( U + V > 1.2 ) P(U+V>1.2) P ( U + V > 1.2 ) m = 1000 m=1000 m = 1000 m = 4000 m=4000 m = 4000
图上的每一对上下界都是按当时样本数计算的近似区间,不能理解为“整条路径有 95 % 95\% 95% m m m
模拟很稳定,也可能稳定在错误目标上
增加 m m m
因此,报告一个模拟结果时应同时交代一次输出如何生成、目标量是什么、独立重复次数是多少、标准误差多大。若输出来自一条相关的随机过程轨迹,就不能把轨迹长度直接当成独立模拟次数;需要针对依赖性重新评估误差。
把整套推理放回一个总量问题
考虑一个简化的年度赔付模型:有 500 500 500 X X X 120 120 120 600 600 600 80 000 80\,000 80 000
从随机变量的定义开始:X i X_i X i i i i S 500 = ∑ X i S_{500}=\sum X_i S 500 = ∑ X
E ( S 500 ) = 500 × 120 = 60 000. E(S_{500})=500\times120=60\,000. E ( S 500 ) = 500 × 120 = 60 000. 独立性给出方差相加,因此
SD ( S 500 ) = 600 500 ≈ 13 416.4. \operatorname{SD}(S_{500})=600\sqrt{500}\approx13\,416.4. SD ( S 500 ) = 600 500 ≈ 13 在正态近似足够好的前提下,
P ( S 500 > 80 000 ) ≈ 1 − Φ ( 80 000 − 60 000 600 500 ) ≈ 1 − Φ ( 1.4907 ) ≈ 0.0680. P(S_{500}>80\,000)
\approx1-\Phi\left(\frac{80\,000-60\,000}{600\sqrt{500}}\right)
\approx1-\Phi(1.4907)
\approx0.0680. P ( S 500 > 80 000 ) ≈ 1 − Φ ( 这个结果约为 6.8 % 6.8\% 6.8% 500 500 500
例如,若各份赔付方差仍为 σ 2 \sigma^2 σ 2 r r r
Var ( S n ) = n σ 2 + n ( n − 1 ) r σ 2 = n σ 2 [ 1 + ( n − 1 ) r ] . \operatorname{Var}(S_n)
=n\sigma^2+n(n-1)r\sigma^2
=n\sigma^2[1+(n-1)r]. Var ( S n ) = n σ 2 + n ( n − 即使 r = 0.01 r=0.01 r = 0.01 n = 500 n=500 n = 500 5.99 5.99 5.99 2.45 2.45 2.45
从定义变量到计算矩,从联合关系到选择极限定理,再回到事件解释,这才是一条完整的建模过程。它与本课程前面学过的样本空间、随机变量、分布和条件结构,其实是同一套语言的连续使用。
练习:把条件、尺度和事件一起写出来
平均值稳定了,标准化误差也趋于零吗
设 X i X_i X i μ \mu μ 0 < σ 2 < ∞ 0<\sigma^2<\infty 0 < σ 2 < ∞ X ˉ n →
显示答案 第一个推断错误。依概率趋于零的误差乘上发散的 n \sqrt n n N ( 0 , 1 ) N(0,1) N ( 0 , 1 ) X 1 X_1 X
一百个零件的平均长度
独立同分布的零件长度均值为 20 20 20 0.4 0.4 0.4 100 100 100 20.06 20.06 20.06
显示答案 均值的标准差精确等于 0.4 / 100 = 0.04 0.4/\sqrt{100}=0.04 0.4/ 100 = 0.04 ( 20.06 − 20 ) / 0.04 = 1.5 (20.06-20)/0.04=1.5 ( 20.06 − 20 ) /0.04 = 1.5
少于 16 次成功与不超过 15 次成功
设 B ∼ Bin ( 250 , 0.08 ) B\sim\operatorname{Bin}(250,0.08) B ∼ Bin ( 250 , 0.08 ) B < 16 B<16 B < 16 B ≤ 15 B\le15 B ≤ 15
显示答案 这两个离散事件完全相同,都包含 0 0 0 15 15 15 15.5 15.5 15.5 16.5 16.5 16.5
μ = 20 , σ = 250 × 0.08 × 0.92 = 18.4 , \mu=20,\qquad \sigma=\sqrt{250\times0.08\times0.92}=\sqrt{18.4}, μ = 20 , σ = 一个泊松区间
设 Q ∼ Pois ( 64 ) Q\sim\operatorname{Pois}(64) Q ∼ Pois ( 64 ) P ( 55 ≤ Q ≤ 75 ) P(55\le Q\le75) P ( 55 ≤ Q ≤ 75 ) Φ ( 75 ) − Φ ( 55 ) \Phi(75)-\Phi(55) Φ ( 75 ) − Φ ( 55
显示答案 近似正态变量的均值为 64 64 64 8 8 8 [ 54.5 , 75.5 ] [54.5,75.5] [ 54.5 , 75.5 ]
P ( 55 ≤ Q ≤ 75 ) ≈ Φ ( 75.5 − 64 8 ) − Φ ( 54.5 − 64 8 ) = Φ ( 1.4375 ) − Φ ( − 1.1875 ) ≈ 0.8072. P(55\le Q\le75)
\approx\Phi\left(\frac{75.5-64}{8}\right)
-\Phi\left(\frac{54.5-64}{8}\right)
=\Phi(1.4375)-\Phi(-1.1875)
\approx0.8072. P ( 55 ≤ 由一次模拟报告规划下一次
一次独立重复模拟做了 10 000 10\,000 10 000 2.37 2.37 2.37 5.8 5.8 5.8 95 % 95\% 95%
显示答案 标准误差估计为 5.8 / 100 = 0.058 5.8/100=0.058 5.8/100 = 0.058 1.96 1.96 1.96
2.37 ± 1.96 × 0.058 = 2.37 ± 0.11368 , 2.37\pm1.96\times0.058
=2.37\pm0.11368, 2.37 ± 1.96 × 0.058 = 2.37 ± 0.11368 , 即约 [ 2.2563 , 2.4837 ] [2.2563,2.4837]
总工时与共同变慢
仓库一天处理 900 900 900 4.2 4.2 4.2 3 3 3 3900 3900 3900
显示答案 总工时期望为 900 × 4.2 = 3780 900\times4.2=3780 900 × 4.2 = 3780 3 900 = 90 3\sqrt{900}=90 3 900 = 90
P ( 从“平均会稳定”走到“误差可以计算”
回想课程最开始,样本空间装着一次实验可能出现的结果;随机变量是一条把结果映射成数的确定规则。分布把取值与概率组织起来,期望按概率加权给出中心,方差描述离中心的波动。联合分布与条件概率提醒我们:单个变量各自怎样分布,还没有说完它们如何一起出现。
到随机变量的和,我们开始研究许多次观测共同形成的量。上一章的大数定律说明,满足条件的平均值会稳定到期望。现在的中心极限定理进一步说明,在有限正方差的 iid 模型里,平均误差的自然尺度是 σ / n \sigma/\sqrt n σ / n
导论课里那句“频率可以估计概率”,到这里已经有了两层更具体的解释:大数定律说明估计为什么趋于正确目标,中心极限定理帮助我们估计有限次数下的随机误差。它们都没有替我们保证模型正确,也没有要求每条路径的误差逐次减小。
以后进入统计推断,你会把样本均值及其标准误差组合成区间和检验;进入随机过程,你会重新处理随时间产生的依赖;做模拟时,你会区分单次输出的波动与模拟平均值的误差。继续往前时,可以始终保留本章这一习惯:先问研究的是哪个随机量、有哪些联合条件,再写它的中心、尺度和目标事件。公式因此有了可以核对的对象,近似也有了明确的适用范围。