条件分布、条件期望与全期望公式
上一章,我们把两个随机变量放进一张联合分布表里。表中的每个格子都在说:这两个量怎样一起出现。现在假设其中一个量已经看到了,接下来该怎么办?
比如,我们正在估计一张订单里有多少件商品。只看所有订单,可以算出一个总体平均;但如果又知道“这张订单来自会员”,原来的平均还合适吗?这条信息没有直接告诉我们商品件数,却可能改变不同件数出现的概率。我们需要把这份信息真正放进计算,而不只是在答案旁边加一句“会员可能买得更多”。
这就是本章的起点:已知一部分信息以后,怎样重新描述剩下的不确定性? 条件分布给出更新后的整份概率规律,条件期望把它压缩成一个平均数。随后,我们再把条件信息暂时拿掉,看看各组平均怎样合成总体平均,各组波动怎样合成总体波动。你在导论课里用过的“分组算一算,再合起来”,到这里会有完整的公式和理由。
知道一张订单来自会员以后
设 X 表示一张订单中的商品件数,Y 表示会员状态,Y=1 为会员,Y=0 为非会员。为了把注意力放在条件化这个动作上,我们使用一个只允许购买 1,2,3 件商品的简化模型。联合概率如下:
如果尚未看到会员状态,买三件商品的概率是沿着最后一个商品件数列求和:
P(X=3)=0.05+0.20=0.25.
现在告诉你,这张订单来自会员。第一行就不再符合已知信息,只剩第二行。但第二行三个数加起来是 0.65,并不是 1。原因很简单:表中 0.20 记录的是“会员并且买三件”在全部订单中的占比,我们现在需要的是“会员订单内部买三件”的占比。分母换了,概率自然要重新算。
P(X=3∣Y=1)=P(Y=1)
同样处理另外两个格子,就得到会员订单的条件分布:
现在三项之和是 1。你可以把这一步理解为:先把观察对象限制到会员这一组,再让这一组内部的全部可能性重新占满百分之百。
一行表格背后的通用公式
对离散随机变量,只要 pY(y)=P(Y=y)>0,就有
pX∣Y(x∣y)=P
固定 y 以后,pX∣Y(x∣y) 是关于 x 的概率质量函数。它非负,而且
x∑pX∣Y(x∣y)=
这里的“固定”很容易读错。给定 Y=y 只是说 Y 的值已经知道了,X 往往还有许多可能取值。条件化保留的正是这部分尚未消失的不确定性。
反过来,如果已知每组的条件分布和每组的概率,也可以拼回联合分布:
pX,Y(x,y)=pX∣Y(x∣
这个式子把“先确定类别,再在类别内部生成结果”的过程写了出来。后面谈混合模型时,我们会直接按这个顺序建模。
若 P(Y=y)=0,离散条件概率的比值公式不能使用。不要把零概率行除以零,也不要把它擅自改成等可能的一行。原来的联合分布没有通过这个比值指定该条件下的概率规律。
连续变量不能除以点概率,怎么办
离散表格中的一行有正概率,连续模型中的一条水平线却通常没有。假设 (X,Y) 有联合密度,那么对任意指定实数 y,P(Y=y)=0。如果照搬上一节,分子 P(X 也为零,于是会出现没有意义的 。
但“已经测得 Y=y”仍然是我们想处理的信息。解决办法是从联合密度构造条件密度,而不是把零当成很小的正数去除。
先给这个公式一个直观来路。实际测量往往只精确到一个很窄的区间,我们可以先条件于 y≤Y≤y+Δ,其中 Δ>0。此时
P(X∈A∣y≤Y≤y+
如果相关密度在这个位置足够规则,分子、分母都近似含有一个区间宽度 Δ。把区间不断缩窄,它们的比值就引导我们写出
fX∣Y(x∣y)=
这条密度比值公式用于 0<fY(y)<∞ 的位置。对于一般密度,不必要求上面的逐点极限处处成立;条件密度的实际依据是它能正确还原联合概率。把条件密度乘回 fY(y),再对有关区域积分,就回到原来的联合模型。
为什么还要归一化
固定 y 后,fX,Y(x,y) 是联合密度的一条切片。它沿 x 方向的积分等于 f,通常不是 。因此还要除以 :
∫−∞∞fX∣Y
离散模型是“取一行再除以行和”,连续模型是“取一条切片再除以切片面积”。两种算法处理的是同一件事。
有了条件密度,就可以求区间概率:
P(a<X<b∣Y=y)=∫ab
密度仍然不是点概率。在有上述条件密度的情形,给定 Y=y 后,P(X=x∣Y=y)=0,而密度高度完全可能大于 1。
联合分布确定的条件分布允许在一组 Y 取到的概率为零的位置上作不同约定,而不改变任何总体概率计算。尤其在 fY(y)=0 的位置,不能用比值公式硬算。本文使用自然的密度比值版本;涉及条件期望的随机变量等式,都理解为以概率一成立。
也别漏掉前提“有联合密度”。例如 Y=X,即使 X 有密度,(X,Y) 的概率仍全部集中在直线 y=x 上,没有普通的二维联合密度。给定 Y= 后, 就确定等于 ,条件分布是一个点上的全部概率,不能用本节的二维密度比值公式。这不是条件分布失效,而是你选择的计算工具有适用范围。
支持区域决定条件分布的范围
连续题里最常见的麻烦,往往不在积分技巧,而在“到底对哪一段积分”。我们看一个能同时练习边缘分布和条件分布的模型:
fX,Y(x,y)={2,
平面上满足 0<x<y<1 的区域是面积为 1/2 的三角形,乘以密度 2 后总概率为 1。先检查这一点,才能放心往下计算。
如果给定 Y=y,其中 0<y<1,允许的横坐标范围就变成 0<x<y。于是
fY(y)=∫0y2dx=2y
从而
fX∣Y(x∣y)={
给定 Y=y 后,X 在 (0,y) 上均匀分布。例如 Y=0.6 时,X 的范围是 ,而
P(X<0.2∣Y=0.6)=∫00.2
若问 P(X<0.8∣Y=0.6),答案是 1。不能机械地把 1/0.6 从 0 积到 0.8,因为超过 的部分密度已经是零。
现在调换条件,已知 X=x,研究 Y。三角形告诉我们,此时应沿着 x<y<1 积分:
fX(x)=∫x12dy=
所以
fY∣X(y∣x)=1−x1
这次是 (x,1) 上的均匀分布。X∣Y=y 与 Y∣X=x 既不是同一个问题,也没有同一个分母。条件符号右边的变量决定了哪一个坐标被固定、哪一条边缘密度负责归一化。
同一块三角形,也可能有不同的条件形状
如果把联合密度改成
fX,Y(x,y)=6x,0<x<y<1,
区域不变,但右侧位置的联合密度更高。先核对总概率:
∫01∫0y6xdxdy=
给定 Y=y 后,边缘密度为 3y2,条件密度便是
fX∣Y(x∣y)=y2
它在允许区间上随 x 增大。给定相同的上限 y,较大的 x 有更高的密度,所以条件均值应该高于区间中点 y/2。这个定性判断,马上会成为下一节计算结果的检查方式。
条件期望为什么还是一个随机变量
回到订单问题。如果知道会员状态以后只想报一个平均件数,就在刚算出的条件分布下求平均:
E[X∣Y=1]=1⋅133+2
对非会员订单,则有
E[X∣Y=0]=0.351⋅0.18+2⋅0.12+3
这两个数分别回答“在已知会员的那组里平均买几件”和“在已知非会员的那组里平均买几件”。期望不要求本身是一个可能结果,所以预测 2.077 件并没有说一张订单真能买到小数件商品。
一般地,在条件分布下的平均写成
m(y)=E[X∣Y=y]=x∑xp
或在存在条件密度时写成
m(y)=E[X∣Y=y]=∫−∞
我们先假设 E[∣X∣]<∞。这保证条件期望在以概率一会遇到的条件值上有限,也使后面交换求和、积分的步骤有依据。不能因为某个对称积分看起来抵消成零,就跳过绝对可积性的要求。
真正容易卡住的是下一步:为什么课本还会写一个没有小写值的 E[X∣Y]?
先把每种可能观察值对应的平均整理成一个规则 m(y)。观察前,输入 Y 还没有确定;输入确定以后,这个规则才给出具体的条件平均。因此
E[X∣Y]=m(Y).
它是把随机变量 Y 送进一个确定函数 m 得到的新随机变量。和随机变量最初的定义一样,规则本身不随机,输入的试验结果尚未确定,输出于是也尚未确定。
在订单例子里,随机变量 m(Y) 以概率 0.35 取 57/35,以概率 0.65 取 27/13。观察到 Y=1 后,这次的条件预测才成为数值 。
用连续模型再看一次
在均匀三角形模型里,X∣Y=y 在 (0,y) 上均匀,所以
E[X∣Y=y]=∫0yx
在密度为 6x 的三角形模型里,计算则变成
E[X∣Y=y]=∫0yx
这正好符合刚才的判断:同一个区间内,条件密度偏向右侧时,条件均值也从 y/2 向右移到了 2y/3。公式算完后回到图形和范围检查一下,比只盯着分子分母更容易发现错误。
回到联合密度为 2 的均匀三角形,取 y=0.6,把刚才的计算逐步画出来。原切片的高度是 2,宽度是 0.6,总量为 1.2;归一化以后,条件密度高度变为 5/3,条件均值则落在区间中点 0.3。这张图对应第一个均匀模型。
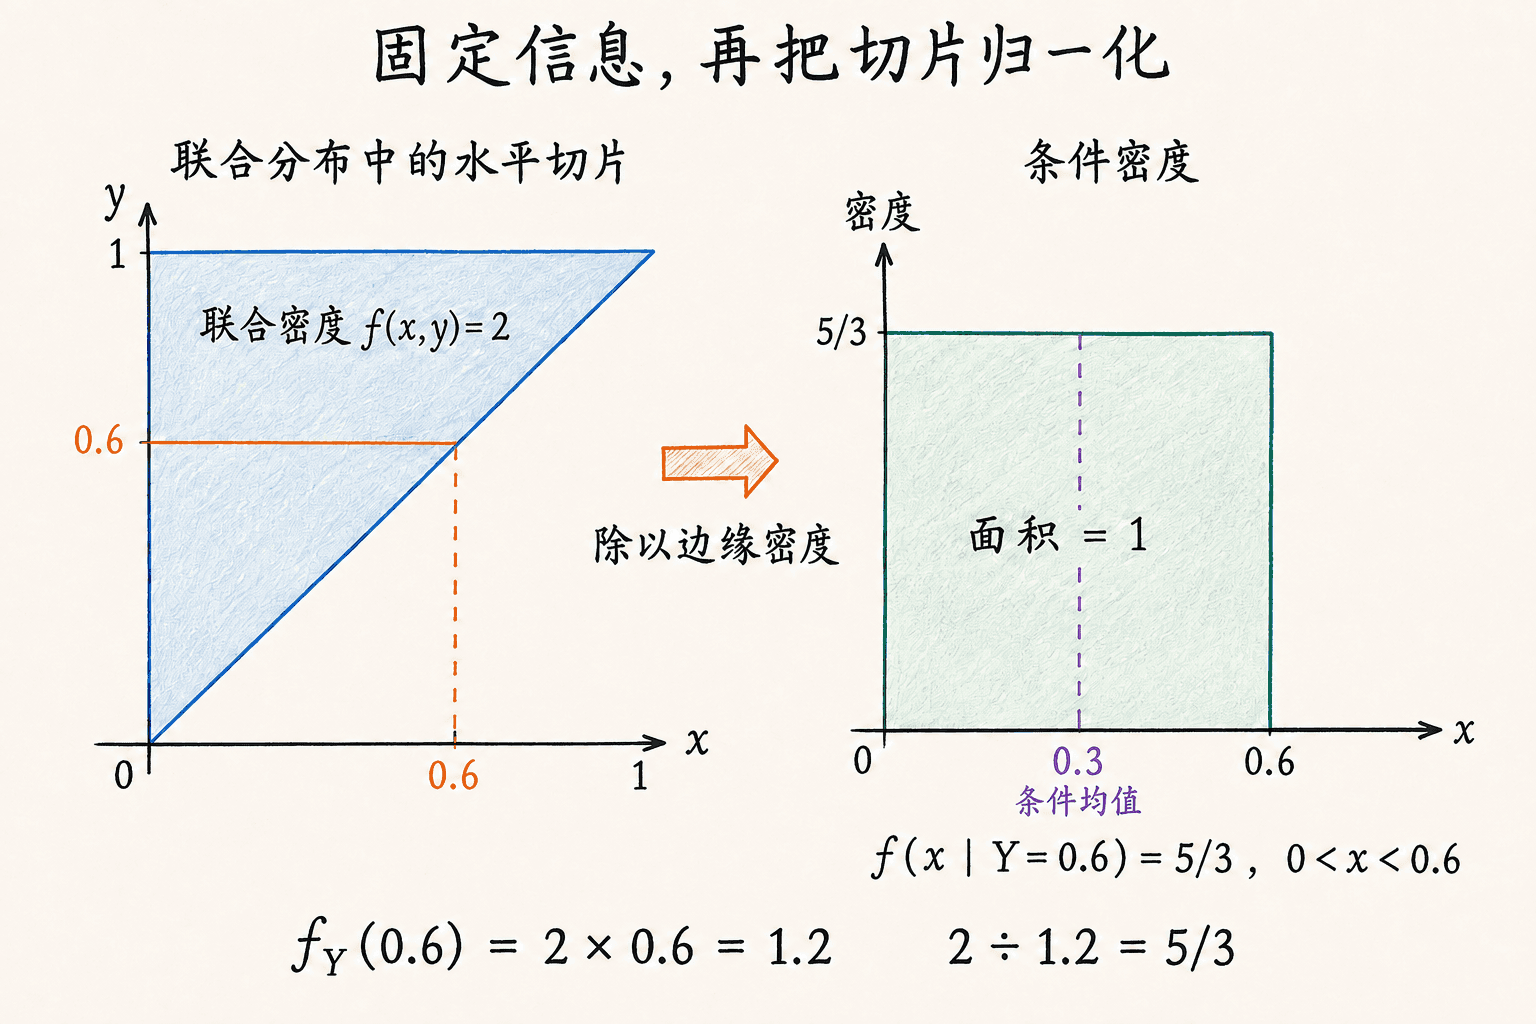 固定 Y=0.6 后,联合密度切片的总量为 1.2;除以 1.2 得到面积为 1 的条件密度,其中心与条件均值都是 0.3。
哪些量在条件下可以当成常数
如果 Y 已知,那么 Y 的任何确定函数也已知。例如知道商品件数,就知道“每件收取三元包装费”对应的费用。于是只要相关变量可积,
E[h(Y)∣Y]=h(Y).
特别地,E[Y∣Y]=Y。右边的 Y 不会被平均掉,因为我们正是在已经知道它的条件下求平均。
同样,已知的因子可以提到条件期望外面:若 E[∣X∣]<∞ 且 E[∣h(Y)X∣]<∞,则
E[h(Y)X∣Y]=h(Y)E[X∣Y].
你可以在固定 Y=y 后,把 h(y) 看成普通常数,先从求和或积分中提出,再把 y 换回 Y。条件期望也保持线性:对于可积的 U,V 和常数 ,
E[aU+bV∣Y]=aE[U∣Y]+bE[V∣Y
这里不需要 U,V 独立。但一般不能把乘积的条件期望拆成两个条件期望的乘积;没有已知因子或相应的条件独立假设时,那样做没有依据。
如果 X,Y 独立,知道 Y 不会改变 X 的分布,自然也不会改变平均:
E[X∣Y]=E[X].
反过来却不成立。设 Y 等可能取 0,1;给定 Y=0,X 等可能取 −1,1;给定 Y, 等可能取 。两组平均都是零,因而 ,但知道 后,我们马上知道 是 还是 。条件均值相同,只说明平均数没有变化,不能说明整份分布没有变化。
全期望:分组平均怎样合回总体
订单来自会员的概率是 0.65,来自非会员的概率是 0.35。既然两组平均已经算好,整体平均该怎样合成?
不是把 27/13 与 57/35 相加除以二,因为那样等于给两组各分一半权重。真正的总体中,会员订单更多,应占更大的分量:
E[X]=3557⋅0.35+1327
直接从原联合表求边缘分布也能验证这一点。三种件数的边缘概率是 0.33,0.42,0.25,所以
E[X]=1⋅0.33+2⋅0.42+3⋅0.25=1.92.
两条路线得到同一个数,正是全期望公式:
E[X]=y∑E[X∣Y=y]P(Y
内层把 X 换成每组的平均,外层再按组的真实概率求平均。它没有假定各组一样大,也没有假定 X,Y 独立。
公式为什么成立
假设 E[∣X∣]<∞。从条件概率的定义出发,可以逐步写出
第一步是“把各组均值加权”,第二步把条件概率乘回组概率,还原联合概率;第三步只是换一个求和次序。绝对可积保证这里不是在随意重排一个可能发散的正负级数。若 X 非负,也可以使用允许结果为 +∞ 的非负版本。
当 Y 有密度时,组不再是一个个离散类别,外层加权变为积分:
E[X]=∫−∞∞m(y)fY(y
注意积分时用的是 Y 的边缘密度。均匀三角形模型中 m(y)=y/2、fY(y)=2y,因此
E[X]=∫012y⋅2y
如果误把 m(y) 从 0 到 1 普通平均,会得到 1/4。错在把各种 y 视为同样可能;实际上 f,较大的 附近有更高的概率密度。
保持各组均值不变,只调整组的权重,总体平均会随构成比例改变,即使任何一组内部都没有变化。读总体平均的变化时,先分清“组内平均改变”和“各组占比改变”,往往能避免错误解释。
条件概率其实也藏在这条公式里
事件 A 的指示变量 1A 只取 0,1,它的条件期望就是条件概率:
E[1A∣Y]=P(A∣Y).
对它应用全期望,就得到
P(A)=E[P(A∣Y)].
若 Y 离散,这恰好是按 Y 的各个取值分组的全概率公式。前面学过的全概率与这里的全期望,并不是两套互不相干的技巧;全概率正是“先求条件平均,再平均一次”在零一变量上的表现。
塔式性质:信息逐层减少时,平均可以逐层做
全期望把所有条件信息都去掉。如果只去掉一部分信息,会发生什么?
设 Y 表示一张客服工单的详细类型,Z=h(Y) 表示它所属的大类。知道详细类型就能确定大类,知道大类却未必能反推出详细类型。因此,Y 包含的信息比 Z 更细。
对于可积的处理时长 T,有
E[E[T∣Y]∣Z]=E[T∣Z].
先对每个详细类型求平均,再在同一大类中按详细类型的条件比例加权,结果等于直接在这个大类内求平均。这是塔式性质的一种具体写法。它描述的是分组逐渐变粗时,平均过程可以合并。
例如,一个“大类”内部包含两种详细类型,比例为 1/4 和 3/4,平均用时分别为 4 分钟和 8 分钟。那么这个大类的平均用时是
4⋅41+8⋅43=7.
这里的 1/4,3/4 是已经给定大类之后的条件比例,不是这两类在所有工单中的总体占比。多层条件题里,每一步用哪一层的权重,比记住括号有几层更重要。
另一方向也容易理解:
E[E[T∣Z]∣Y]=E[T∣Z].
因为知道 Y 后就知道 Z,从而已经知道 E[T∣Z] 这个预测值。对一个已经能由条件信息确定的量再求条件期望,它保持原样。
若两份信息原来并没有谁包含谁,就不能随意套用这两条等式。不过,联合观察 (Y,Z) 显然包含单独观察 Y 的信息,所以始终可以在可积条件下写成
E[E[T∣Y,Z]∣Y]=E[T∣Y].
塔式性质需要核对信息的包含关系。它不是“只要看见两层条件期望,就能随便删掉内层或外层”。每次化简前,先用一句普通话说明:我现在知道的信息,能不能确定另一层条件所用的信息?
全方差:组内波动和组间差异都要算
算平均时,把组均值加权就够了。算方差时,如果也只把每组方差加权,会漏掉什么?
想象两条生产线都非常稳定。一条每件产品恰好重 100 克,另一条恰好重 110 克。每条线内部的方差都是零,但把两条线的产品混在一起,重量显然有波动。漏掉的就是两组平均值之间的差异。
设 E[X2]<∞。条件方差定义为
Var(X∣Y)=E[(X−E[X∣Y]
和条件期望一样,它通常是 Y 的函数,所以本身也是随机变量。给定具体的 Y=y 后,才得到该组内部的一个方差数值。
全方差公式是
Var(X)=E[Var(X∣Y)]+Var(E[X∣Y]).
第一项是组内方差的加权平均,第二项是各组平均本身的方差。两项都具有 X 单位的平方,例如处理时间用分钟计,方差就用平方分钟计。
从二阶矩把公式推出来
记 m(Y)=E[X∣Y]。由条件方差的定义,
E[X2∣Y]=Var(X∣Y)+m(Y)
两边取期望,对左边使用全期望:
E[X2]=E[Var(X∣Y)]+E[m(Y)
再减去总体均值的平方。因为 E[m(Y)]=E[X],所以
这一推导没有使用独立性。恰恰是当不同组均值不同、条件信息有用时,第二项才会把这种结构显出来。
把客服模型算完整
假设一张随机客服工单可能属于简单、中等、复杂三类,用 G 记录类别,用 T 记录处理时长。模型给出:
先算整体平均:
μ=E[T]=0.50⋅4+0.35⋅9+0.15⋅20=8.15.
组内方差平均为
E[Var(T∣G)]=0.50⋅2.25+0.35⋅9+0.15⋅36=9.675.
注意这里加权的是方差,不能把标准差 1.5,3,6 直接平均后平方。接着计算组均值相对于总体平均的偏离:
Var(E[T∣G])
于是
Var(T)=9.675+29.9275=39.6025.
在这个模型里,组间平均差异贡献的波动更大。若想提高预测能力,先知道工单属于哪一类,会比始终使用一个 8.15 分钟的整体预测更有帮助。下一节会把“更有帮助”精确写成平均预测误差的下降。
上面的演示另外选取了三个正态条件分布来画图,并不使用客服例子的具体参数。彩色曲线已经乘以各组权重,因此表示各组对总体密度的贡献;完整曲线的面积是该组概率,不是 1。图中只展示 [−8,8] 的横轴视窗,正态分布在视窗以外仍有尾部,数值方差使用的是完整分布。
操作时,可以先让不同组的均值靠近,再把它们拉开,观察组间项怎样改变。另一次保持均值不变,只改变层内标准差,查看程序把标准差平方后得到的组内项,就能分辨两种波动的作用。全方差相加的是这两部分,而不是把几个标准差相加。
信息更多,不保证每一个条件组都更稳定
由全方差公式,
E[Var(X∣Y)]≤Var(X).
这是平均意义上的结论,不能改成“对每一个 y,条件方差都不超过总体方差”。某个已知条件可能恰好告诉我们“这次属于波动特别大的那一组”。
例如以概率 0.9 令 X=0,以概率 0.1 进入另一组,在那组内 X 等可能取 −10,10。两组均值都是零,总体方差为 10,但第二组的条件方差为 。知道自己进入了第二组后,不确定性确实变大;平均起来的组内方差仍是 ,没有违反全方差。
为什么条件均值是平方误差下最好的预测
前面一直把 E[X∣Y] 叫作根据 Y 的平均预测。它还有一个更强、也更具体的性质:如果用平均平方误差评价预测,并且 E[X2]<∞,条件均值是所有只利用 Y 的预测规则中最好的。
先把“最好”说清楚。你看到 Y 后可以报出任何函数值 g(Y),预测误差是 X−g(Y)。我们用
E[(X−g(Y))2]
衡量这条规则的平均表现。平方使正负误差不会相互抵消,也让大误差付出更高代价。不同的损失标准可能选出不同预测,因此这里的“最好”有明确的平方误差前提。
令 m(Y)=E[X∣Y],把误差拆成
X−g(Y)=(X−m(Y))+(m(Y)−g
第一部分是已经使用条件均值后仍然留下的误差;第二部分是你的预测规则相对于条件均值的额外偏离。平方展开时会出现交叉项,但它的期望是零:
E[(X−m
原因是给定 Y 后,m(Y)−g(Y) 已经确定,而
E[X−m(Y)∣Y]=m(Y)−m(Y)=0.
对平方可积的预测规则 g(Y),因此有
E[(X−g(Y))2]=E[(X−m(Y
最后一项非负,只有 g(Y)=m(Y) 以概率一成立时为零。这就证明了最优性。它不是说条件均值每一次都猜得最近,而是说,在模型给定的概率加权下,没有另一条只用同样信息的规则能够得到更小的平均平方误差。
回到客服模型,完全不用类别信息时,最好的常数预测是 E[T]=8.15,平均平方误差是 39.6025。使用类别条件均值后,平均平方误差变为
E[(T−E[T∣G])2]=E[Var(T∣G)]=
减少的 29.9275 恰好就是全方差中的组间项。全方差于是有了另一种读法:总体均值预测的误差,等于使用类别信息后的剩余误差,加上这份信息能够消除的平均平方误差。
条件均值是平均预测,不是一个保证区间,也不一定是最可能发生的取值。若要回答“落在某段范围内有多大概率”,仍需条件分布。知道一个平均数,并不意味着已经知道全部不确定性。
混合模型:先选状态,再产生观测
许多现实模型很适合分两步描述:先决定处于哪个状态,再由该状态产生一个观测值。我们不必先写出复杂的总体分布,可以从每个状态内部比较简单的分布开始。
设 Z 是状态变量,取离散值 z,权重为 πz=P(Z=z)。若各状态下 X 是离散的,就有
pX(x)=z∑pX∣Z
若各状态下 X 有密度,则
fX(x)=z∑fX∣Z
这就是混合分布。每个条件分布自身归一化,权重非负且和为 1,因此混合后仍是合法分布。状态可以是实际记录的类别,也可以是模型中没有直接观察到的隐藏类别。
两种服务状态的等待时间
我们用一个明确假设的模型来计算。以概率 0.8 处于普通状态,以概率 0.2 处于拥堵状态。给定状态后,等待时间 X 服从指数分布;普通状态平均等待 3 分钟,拥堵状态平均等待 12 分钟。因此两组的率参数分别是 1/3 和 1/12:
fX∣Z(x∣普通)=3
总体密度是
fX(x)=0.8⋅31e
它通常不是另一个指数分布。不能先把两组均值平均为 4.8,然后就宣布总体服从均值为 4.8 的指数分布。平均数一致,只是一个数值相同,并不能保证密度曲线一致。
如果只求期望,完全不必对混合密度积分:
E[X]=0.8⋅3+0.2⋅12=4.8.
指数分布的方差等于均值平方,所以组内方差平均为
E[Var(X∣Z)]=0.8⋅9+0.2⋅144=36.
组间均值方差为
Var(E[X∣Z])=0.8(3−4.8)2+0.2(12−4.8
最终
Var(X)=36+12.96=48.96.
若误用均值 4.8 的单一指数分布,方差会被算成 4.82=23.04,明显不同。混合不同状态会带来一种单看整体平均无法识别的波动。
从观测反推状态,权重也会改变
假设已经等了 6 分钟还没有等到服务。这时拥堵状态的概率还应是 0.2 吗?
我们观察到的是事件 X>6。它在拥堵状态下更容易发生,所以应使用条件概率更新状态权重:
P(Z=拥堵∣X>6)=
先前只有五分之一的拥堵概率,看到长等待后上升到了约一半。这里改变的是我们根据新信息对状态的判断,模型中的先验生成比例仍是 0.8,0.2。
这也解释了为什么混合指数分布一般没有指数分布的无记忆性。每个状态内部可能都满足无记忆性,但等待越久,我们对“现在处于哪个状态”的判断也在变;未知状态混合起来后的剩余等待分布于是可能改变。
如果 X 连续,而且观察的是密度意义下的具体值 x,对应的更新公式为
P(Z=z∣X=x)=f
分子是该状态对这个位置的密度贡献,分母把所有状态的贡献加起来。这里的权重根据观测更新以后,可以继续用于条件平均预测。
共同的隐藏状态会让观测彼此相关
还要区分两种生成方法:每次观测都重新独立选择状态,和先选择一个共同状态再生成多次观测。它们可能有相同的单次边缘分布,却有不同的联合关系。
例如某一天的状态 Z 等可能取“低负荷”“高负荷”,相应的到达率参数 λZ 为 1 和 5。给定这一天的状态后,两个时段的计数 N1 条件独立,分别服从均值为 的泊松分布。
于是
E[N1]=E[N2]=E[λ
而通过条件独立和全期望,
E[N1N2]=E[E[N
所以
Cov(N1,N2)=13−3⋅3=4.
已知状态时两个时段独立,未观察状态时却相关,因为高负荷状态会同时提高两段的平均计数。这再次呼应上一章的提醒:仅知道每个变量各自的分布还不够,必须说明它们如何共享信息、如何一起生成。
练习:把已知信息放到计算的正确位置
由一张联合表完整走到期望
设联合概率如下:
求 P(X=2∣Y=1)、E[X∣Y=0]、 和 。最后用边缘分布核对整体期望。
两行总概率都是 0.50,因此
P(X=2∣Y=1)=0.500.28=连续条件范围、均值和方差
在联合密度为 6x、支持区域为 0<x<y<1 的模型中,求 P(X<Y/2∣Y=、、,再用全期望求 。
先固定一个 0<y<1。条件密度是 2x/y2,范围为 0<x<y。因此
三条生产线合在一起
随机抽取一件产品。生产线 G 取三种值的概率为 0.5,0.3,0.2,重量 W 的条件均值分别为 100,102,97 克,条件方差分别为 4,9,16。求整体均值、整体方差,以及知道生产线以后使用条件均值预测重量的平均平方误差。
全期望给出
E[W]=0.5⋅100+0.3⋅102+0.2⋅97=100.组内方差平均为
条件平均不变,是否说明信息没用
设 Y 等可能取 0,1;给定 Y=0,X 等可能取 −1,1;给定 Y, 等可能取 。求 和 ,并判断 是否独立。
每组关于零对称,所以 E[X∣Y]=0。但平方后的量在组内是确定的:
E[X2∣随机个数的总和,先固定个数再算
一家小店在一个观察时段内的订单数为 N,满足 E[N]=5、Var(N)=2。各张订单的件数 X 独立同分布,均值为 、方差为 ,且整个件数序列与 独立。总件数为 ,当 时规定 。求 和 。
困难在于求和项数也是随机的。先给定 N=n,它就变成普通的固定项数之和。件数序列与 N 独立,保证条件化后每张订单的分布不变,因此
E[S∣N=n]=3n,
接下来,把条件化用到新随机变量的分布上
到这里,我们已经能沿着一个完整方向来回走:从联合分布出发,固定观察信息,得到条件分布和条件平均;再按条件的真实概率加权,回到总体的概率、均值和方差。信息不会自动让每一个组都更稳定,但它给了我们按组描述和预测的办法。
下一章要把已有随机变量送进函数,例如平方、取最大值,或者相加,研究产生的新随机变量服从什么分布。本章的条件化会继续派上用场:研究 X+Y 时,可以先固定 Y=y,把问题变成 X+y 的分布,再对 y 加权。先让一个量暂时已知、把问题算清楚,然后解除条件,这条思路会自然通向变量变换和卷积。