连续随机变量与密度函数
上一章里,我们经常做同一件事:先问随机变量可能取哪些数,再把概率一笔一笔记在这些数下面。掷骰子的点数是 1 到 6,首次成功的试验次数是 1,2,3,…。即使可能值有无穷多个,只要能按顺序列出来,概率仍然可以靠求和收齐。
现在把问题换成一台设备完成任务所花的时间。假设我们用连续模型描述它,时间就不必只取 1 秒、2 秒,也可以是 1.37 秒、1.3701 秒。你可能顺手问:“那就给每一个实数也配上概率,再加起来,不行吗?”这里恰好有一个需要停下来的地方:连续密度模型中,每个预先指定的精确数值,概率都等于零。
这不表示任务无法完成,也不表示设备不可能给出某个实际结果。它提醒我们,原先的“逐点记账”方式需要换了。真正能承载正概率的是一段范围,例如“用时在 1.3 到 1.4 秒之间”。本章要把这件事讲清楚:概率怎样铺在数轴上,密度为什么要乘上宽度,以及如何从密度恢复我们已经熟悉的分布函数。
为什么一整段有概率,单个点却没有
先看一个容易核对的模型:某个信号在长度为 4 秒的时间窗口内出现,假设窗口内没有位置偏好,用 X 表示它出现的时刻。这里“没有位置偏好”的意思是:长度相同的时间段获得相同的概率。因此,[0,1] 占整个窗口的四分之一,概率就是 1/4;[2,2.5] 长度为半秒,概率就是 1/8。
对窗口内的任意 a<b,这条规则可以写成
P(a≤X≤b)=4b−a,0≤a
如果你坚持追问“恰好在第 2 秒出现的概率”,我们可以把它夹在越来越窄的区间里。对足够小的 ε>0,有
0≤P(X=2)≤P(2−ε≤X≤2+ε)=
右边可以小到任意程度,左边的概率又不能是负数,所以只能有 P(X=2)=0。这不是凭测量精度猜出来的,而是这个连续均匀模型本身推出的结论。
但信号仍然必定出现在整个窗口里,P(0≤X≤4)=1。看起来像是“无数个零加成了一”,问题其实出在“加”这个字上。概率公理保证的是可数可加性:有限个或能依次列成一串的互不相容事件,其并集概率可以求和。区间包含不可数多个点,不能把离散求和公式直接搬过来,对所有实数逐点相加。
这也能帮我们分清现实记录与数学模型。若仪器只显示到小数点后一位,记录“2.0 秒”一般对应真实时间落在一个舍入区间,例如 [1.95,2.05)。在这个模型下,该记录的概率是 0.1/4=0.025;它并不是事件“真实时间恰好等于 2”。连续的真实量经过舍入,可以产生离散的显示结果。
“连续型”描述的是我们给随机变量选用的概率模型。仪器显示有限位小数,并不妨碍我们用连续模型计算一个容差区间的概率;反过来,看到变量用小数记录,也不能仅凭这一点断定它有密度。
密度是怎样从区间概率里长出来的
上面的均匀模型,长度为 h 的小区间获得 h/4 的概率。把概率除以区间长度,得到恒定的 1/4,它表示每单位长度上分配了多少概率。这个“概率相对于长度的浓淡程度”,就是密度的直观含义。
如果时间并非均匀分布,不同位置的浓淡程度就不同。某段时间附近更容易出现信号,同样宽的小窗口里便会积累更多概率。我们用 fX(x) 表示位置 x 附近的密度,常简写为 f(x)。当 f 在 x 附近连续、 足够小时,
P(x<X≤x+h)=∫xx+h
右边是一个窄矩形的面积。矩形的高是 f(x),宽是 h;只拿走高度,就把区间宽度这条信息丢了。更准确地说,在密度连续的点,
f(x)=h↓0limhP(x<X≤x
这个极限告诉我们怎样读密度:先看一个很短的区间装了多少概率,再除以它的长度。它不等于单点概率。对有密度的变量,P(X=x)=0,密度却完全可以是正的。
把直觉写成定义
本课程主要研究能由密度描述的连续分布。严格说,如果存在非负可测函数 fX,使得对每个实数 x 都有
FX(x)=P(X≤x)=∫−∞
就称 X 的分布是绝对连续的,fX 是它的概率密度函数,也叫 PDF。本章说“连续型随机变量”时,采用这个有密度的含义。“可测”保证积分有意义;眼下遇到的分段多项式、指数函数等都满足这个要求,无须额外猜测。
一个函数要成为概率密度,必须满足
fX(x)≥0,∫−∞∞f
第一条保住概率非负,第二条说明整条数轴把全部概率收齐了。反过来,非负可测函数只要总积分为 1,就能通过上面的积分定义一个分布函数。这两条不是外观要求:一条看起来很像钟形的曲线,如果面积不是 1,仍不能直接拿来算概率。
对任意 a<b,累积到 b 再减去累积到 a,便得到
P(a<X≤b)=FX(b)−F
密度给出的概率也可以覆盖不连通的集合。例如变量落在两个互不相交的区间里,只须把两块面积相加。更一般地,对可测集合 A,
P(X∈A)=∫AfX(x)dx.
所以密度承载了这个变量全部的分布信息;我们日常最常算区间,只是因为区间足以把这份信息组织起来。
密度为什么可以大于一
把刚才的时间窗口缩短到 0.2 秒,并仍假设其中没有位置偏好。为了让矩形面积为 1,它的高度必须变成 5:
f(x)={5,0,0≤x≤0.2,
此时 f(0.1)=5 完全合法。它说的是“每秒的密度为 5”,不是“在 0.1 秒出现的概率为 5”。宽度为 0.01 秒的小区间,对应概率为 5×0.01;整个窗口对应 。
单位还能直接说明这点。如果把同一段时间改用毫秒记录,窗口是 [0,200],密度就变成每毫秒 1/200=0.005。同一个事件的概率没有变化:
5×0.01=0.005×10=0.05.
密度数值随着计量单位改变,概率本身没有单位。凡是看到密度高度超过 1 就怀疑模型的人,可以先做一次这样的单位换算。
同样,比较密度高低时也要把问题说完整。f(a)>f(b) 通常意味着在两点附近取相同且足够小的宽度时,a 附近的概率更大。不能拿一个很高却极窄的峰,和一个较低却很宽的区间只比高度。最终决定概率的始终是面积。
先把一道面积题真正算透
设一个已经缩放到 [0,1] 的任务耗时 X 具有密度
f(x)={2x,0,0≤x≤1,
这不是说现实中的任务必定遵循这条曲线,而是题目给定的模型。它把较大的密度放在右端,表示相同长度的耗时区间,靠右的一段得到较多概率。
我们先验明它确实是密度。在 [0,1] 上 2x≥0,区间外为 0,并且
∫−∞∞f(x)dx=∫0
现在求 P(0.2≤X≤0.5)。需要积起来的是 0.2 到 0.5 这一段,而不是把两个端点的密度相减:
P(0.2≤X≤0.5)=∫0.20.52xdx=
用图形也能复核。这里曲线是一条直线,区间下方是梯形,左右高度分别为 0.4 和 1,宽为 0.3,面积是 (0.4+1)×0.3/2=0.21。积分与几何算的是同一个量。
如果改问 P(−0.2≤X≤0.5),不能机械地把 2x 从 −0.2 积到 0.5。因为 2x 只在 上描述密度,在负半轴的真实密度是 。正确计算是
P(−0.2≤X≤0.5)=∫−0.200dx+
反过来,如果问 P(X>1.2),答案立即是 0,因为模型没有把概率放在那边。所谓“先看支撑区间”,在这里就是先找哪些地方可能贡献面积。我们通常将承载全部概率的相关区间标出来;它的端点是否单独写入,不改变本章这些密度模型的概率。
还可以比较两个等长区间:[0,0.2] 的概率为 0.04,[0.8,1] 的概率为 0.36。右端更密,确实在同样宽的区间里装入了更多概率。你现在应该能区分两个问题:“X 恰好等于 0.9 的概率是多少?”答案是零;“ 是否更容易落在 附近而不是 附近?”在相同的小窗口下,答案是肯定的。
也可以固定左端点 0.5,把宽度记为 h。只要 0≤h≤0.5,精确概率就是
P(0.5≤X≤0.5+h)=(0.5+h)2−0.5
左端点密度为 f(0.5)=1,所以矩形近似给出 h,漏掉的正是 h2。当 h=0.1 时,两者是 0.11 与 ;当 时,两者是 与 。区间越窄,密度在其中的变化越小,矩形近似就越可靠。这里趋于零的是小区间的概率,而指定单点的概率从一开始就是零。
分布函数负责累计,密度负责描述局部
密度是一种新的记账方式,但分布函数并没有退出。对刚才的模型,在 0≤x≤1 时,累积到 x 的概率为
F(x)=∫0x2tdt=x2.
这里用 t 作为积分变量,是为了不让“正在沿数轴扫过的位置”和“积分停下来的上限 x”混成同一个角色。完整的分布函数还必须交代区间外:
F(x)=⎩⎨
左侧尚未遇到任何密度,所以累计为 0;右侧已经收齐全部概率,所以保持为 1。不能因为 x2 很好算,就把它延伸到 x=2 并得到 F(2)=4。分布函数始终在 与 之间。
从累计量怎样回到局部密度
若 f 在 x 处连续,微积分基本定理给出
F′(x)=f(x).
读法很直接:把累计终点向右移动一点,新加入的概率大约是当前位置的密度乘以移动距离。密度高的地方,CDF 上升快;密度为零的一整段,CDF 保持水平。PDF 可以上升、下降、有几个峰,CDF 则永远不会下降。
这里有一个原先很容易一句带过的细节。对于一般有密度的分布,F′=f 是几乎处处成立的:允许在一个长度为零的集合上不成立。在本章分段光滑的例子里,直接对各段求导就够用;分段点要单独理解,不必硬给它安上一个导数。
为什么不能说“只要 F 在某点可导,就一定等于我们写下的密度值”?因为密度在单个点的值根本不影响积分。例如,把 [0,1] 上密度 1 的模型改写成:除了 x=1/2 处写成 99,其余地方仍为 1。得到的分布函数依然是区间内的 ,因此 ,却不等于改写后的 。两种密度给出完全相同的分布。
从密度到 CDF,使用积分恒等式;从 CDF 到密度,对绝对连续的 CDF 可以几乎处处求导,选取一个合适的密度版本。对于分段光滑的课堂例子,在各段内部求导,在少数边界点任取不影响积分的非负值即可。
回到刚才的任务耗时模型,把密度与分布函数并排放好。要算 P(0.2<X≤0.5),可以在密度图上算面积,也可以在分布函数图上算高度差,结果都为 0.21。这里要比较的是两种计算的含义;下方曲线只作示意,精确数值以上方算式为准。
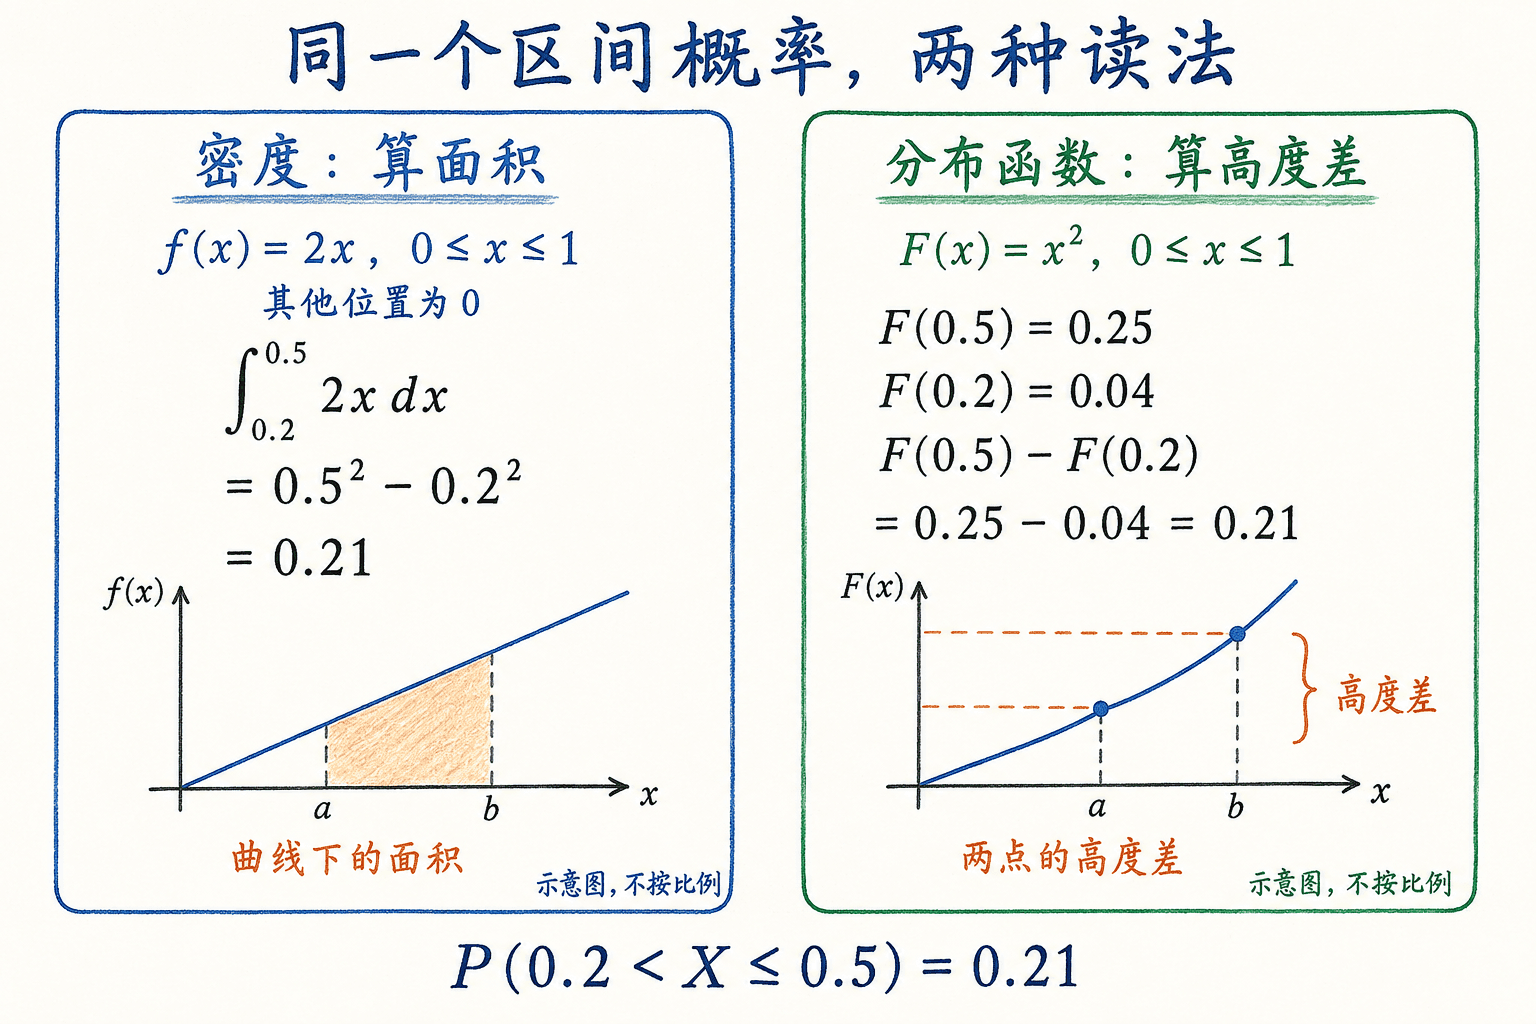 对密度 f(x)=2x(0≤x≤1),区间 (0.2,0.5] 的概率既可由密度积分计算,也可由 F(0.5)−F(0.2) 计算,两者均为0.21。下方曲线为概念示意,不按比例。
不必每次都重新积分
一旦有了完整的 CDF,区间概率往往只剩两次代入。对上面的模型,
P(0.3<X≤0.8)=F(0.8)−F(0.3)=0.64−0.09=0.55.
右尾概率则是尚未累计的那部分:
P(X>x)=1−F(x).
例如 P(X>0.8)=1−0.64=0.36。密度图上,它是 0.8 右边的面积;CDF 图上,它是当前累计值离 1 还差多少。两个视角来回切换,常常比记一串概率公式更省力。
归一化先解决“总账是不是一”
有时我们只知道曲线的相对形状,例如某些位置比另一些位置密两倍,却还没有把总面积调成 1。题目便会给一个非负函数 g,要求找常数 c,使 f=cg 成为密度。
先记下形状原有的总面积
A=∫−∞∞g(x)dx.
只要 0<A<∞,取 c=1/A 就有
f(x)=Ag(x),∫−∞
这个动作叫归一化。所有高度乘上同一个正数,所以它保留各处的相对浓淡,只调整总规模。也可以直接用“局部原面积除以全部原面积”求概率:
P(a≤X≤b)=∫−∞
这个比值背后仍然是归一化,并非绕开了密度定义。
一个完整例子:先归一化,再算中间区域
设
g(x)={x(2−x),0,0
在 [0,2] 上,x 与 2−x 都非负,因此非负性没有问题。曲线在两端为零,中间较高。先求它原来的面积:
A=∫02(2x−x2)dx
原面积超过了 1,所以高度应该整体缩小,c=3/4。这可以用来核对方向:若算出 c=4/3,再放大一遍,显然不可能把 4/3 的面积降到 1。
现在求 P(0.5≤X≤1.5)。先算这段的原面积,再乘归一化常数:
P(0.5
区间 [0.5,1.5] 只占总长度的一半,但收到了 11/16 的概率。原因很具体:它把密度最高的中部包括进来了。若直接按长度比例回答 1/2,等于悄悄把给定模型改成了均匀分布。
哪些形状不能靠乘常数修好
归一化有条件。若 g 在一段区域为正、另一段区域为负,那么任何非零常数都无法让它处处非负;“积分刚好等于 1”也救不了负概率。若 g 非负但总积分为 0,它没有可供放大的正面积。若总积分为无穷大,乘任何有限正数仍是无穷大,也不能变成概率密度。
例如 g(x)=1/x 在 x≥1 上,其他地方为零。它越往右越矮,但
∫1∞x1dx=∞,
所以不存在正的归一化常数。相比之下,g(x)=1/x2 在同一区域的积分为 1,本身就是合法密度。尾部会趋于零还不够,下降速度必须足以让总面积有限。
实际计算较复杂的形状时,可以用数值积分近似求 A,但屏幕上的小数不能替代对积分存在性的判断。例如很小的正面积经过舍入可能显示为 0.00000,它不表示真实面积等于零。归一化常数取倒数,会把面积的相对误差带入后续概率;因此最好先用能手算的例子核对,再检查数值精度是否足够。
分段密度最容易漏掉的是已经累计的面积
密度并不需要一条公式走到底。假设
f(x)=⎩⎨
它先上升后下降,形状是一个底长为 2、高为 1 的三角形。左右两块面积各为 1/2,合起来为 1。这是有密度的连续分布,尽管密度在峰顶处有折角。“连续型”不要求密度处处光滑;下一步的分段常数密度甚至可以有跳跃。
若求 P(0.4≤X≤1.6),积分范围跨过了 1,于是
P(0.4≤X≤1.6)
还可以利用补事件验算:左右漏掉的两个小三角形底和高都是 0.4,各有面积 0.08,所以剩下 1−0.08−0.08=0.84。第一次按积分算,第二次按几何核对,能发现不少分段错误。
写第二段 CDF 时,不能从零重新开始
当 0≤x≤1,只累计左段:
F(x)=∫0xtdt=2x
当 1<x≤2,扫到 1 时已经有 1/2 的概率留在账上,接下来只是在它上面继续增加:
F(x)
第二种写法也有直观意义:整个面积 1 减去 x 右侧的小三角形。于是完整的 CDF 是
F(x)=⎩
写完后逐个检查交界:在 0 接上 0,在 1 左右都得到 1/2,在 2 接上 1。每段不下降,拼起来也没有跳跃。若第二段只写 ∫,它会在 附近回到 ,把之前已经累计的一半概率丢掉。
把累计终点分别停在 0.5、1、1.5,我们可以这样对照局部密度和已经收齐的面积:
在 0.5 与 1.5 处,局部密度同为 0.5,累计概率却相差很大。过了峰顶 1 以后,密度下降,CDF 仍然上升,只是上升速度越来越慢。
归一化和分段同时出现时
再看一个有空白区间的形状:
g(x)=⎩⎨
两块面积分别是 1 和 2,总面积为 3,所以归一化常数是 1/3。左块承载 1/3 的概率,右块承载 2/3,中间的 (1,2) 没有概率。
这个模型的 CDF 在两块之间会暂停增长,但不会把累计值清空:
F(x)=
若计算 P(0.5≤X≤2.5),两块有效面积是 (1−0.5)/3 与 2(2.5−2)/3,中间区域贡献为零,合计 。这个例子提醒我们:支持区域可以不连通,密度可以跳跃,CDF 可以有水平段。这些都不妨碍它是有密度的连续分布。
分位数是在找面积分界线
知道了怎么累计概率,我们还可以反过来问:要把左侧的概率留出 p,分界点应该放在哪里?例如把左侧留出 50%,就是在找中位数。
对 0<p<1,一种统一的分位数定义是
qp=inf{x:F(x)≥p}.
这个定义选择 CDF 第一次达到或超过 p 的位置。在本章连续 CDF 的情形中,它满足 F(qp)=p;如果 F 在相关区域严格递增,就可以直接解方程,而且解是唯一的。
对 f(x)=2x、0≤x≤1 的模型,F(x)=x2,所以
qp=p,q
中位数大于区间中点 0.5,因为密度把更多概率放在了右侧。如果把数轴从 0.5 切开,左侧只有 F(0.5)=0.25,还远不到一半。这里密度最高的地方在右端 1 附近,却也不等于中位数。
对三角形模型,根据 p 是否超过 1/2,分别反解两段 CDF:
qp={2
例如中间 50% 的等尾区间是 [q1/4,q3/4],即
[21,2−
它左右各留下 25%,区间内概率为 3/4−1/4=1/2。分位数提供的是面积位置,不要求先知道均值;均值是另一种概括分布的方式,后面谈期望时还会回来比较。
若 CDF 有水平段,方程 F(x)=p 可能有多个解。刚才两块矩形的例子里,[1,2] 上都有 F(x)=1/3。按广义分位数定义,q,即选择第一次达到该水平的位置。平常说“解 ”很方便,但这条选择约定避免了遇到空白区间时说不清楚。
零概率的端点,和不能省略的连续性条件
密度积分对一个单点给出的面积为零,因此对每个 a 都有
P(X=a)=∫{a}f(x)dx=0.
于是对 a<b,四种端点写法得到相同概率:
P(a<X<b)=P(a≤X<b)=P(a
这是有条件的便利。上章的离散变量一般不能这么做,例如掷骰子时加入端点 6 就会增加 1/6 的概率。如今可以忽略端点,是因为已经证明本章密度模型的端点没有概率质量。
密度在有限个点上的修改不改变概率,在可数个点上的修改也一样,只要修改后的函数仍可作为非负可测函数使用。更一般地,在长度为零的集合上改写密度不会改变它所表示的分布。这就是为什么我们有时在分段点用 ≤,有时用 <,而最后得到同一个概率模型。
CDF 没有跳跃,就一定有密度吗
这里需要把三个说法分开:“密度函数连续”“分布函数连续”“分布具有密度”。它们听起来相近,实际不是同一个要求。
有密度的分布,CDF 一定连续。刚才的分段常数密度已经说明,PDF 自己却可以跳跃。反过来,仅仅看到 CDF 连续,还不足以保证存在密度。CDF 连续只说明它没有跳跃,因此没有任何单点承载正概率;它没有保证所有概率都能用普通长度上的密度来积起来。
可以用一个具体构造理解这个边界。每次独立地以各 1/2 的概率选 0 或 1,记为 B1,B2,…,令
X=n=1∑∞3n2B
这个数的三进制展开只使用 0 与 2。它永远落在这样一个集合里:从 [0,1] 删除中间三分之一,再从每段剩余区间删除中间三分之一,一直做下去,最后留下的集合。
第 n 步剩下 2n 段、每段长 3−n,总长度是 (2/3)n,趋于零。因此最终集合的长度为零,但这个变量以概率 落在其中。另一方面,锁定一个具体结果需要锁定无限多次选择;它的概率不会超过锁定前 次选择的概率 ,所以每个单点的概率都是零。由 CDF 的跳跃量等于点概率,可知它的 CDF 连续。
若它有普通密度 f,在这个长度为零的集合上积分只能得到 0,却又应当得到 1,矛盾。因此它没有密度。这类分布称为奇异连续分布。眼下不需要计算它的 CDF,只需要记住:连续 CDF 与有密度之间,还隔着绝对连续这个条件。
所以从给定 CDF 求密度时,不能只做“看起来连续,然后求导”这两步。对我们常见的、分成有限段且每段光滑的 CDF,检查拼接处连续,再把导数积分回来,确实能够恢复原函数;这才说明找回的是全部概率。
有跳跃的 CDF,求导会漏掉什么
另一个更常见的边界是混合分布。假设某项请求以 1/4 的概率立即处理完,令耗时 X=0;其余 3/4 的概率下,耗时均匀落在 (0,2)。这时
F(x)=⎩⎨
在 0 处的跳跃量是 1/4,对应立即完成的概率。区间 (0,2) 内的导数是 3/8,但它的总积分只有 3/4。这不是少乘了某个归一化常数,而是还有 1/4 的概率集中在单点,普通密度无法表达这一块。
如果把导数强行归一化成积分为 1,得到的会是另一个分布:它描述“已知没有立即完成时的耗时”,不再是原来的总体耗时。对于混合模型,CDF 仍然完整可靠,只是不能假装单靠一条普通密度就收齐了全部概率。
已知落在一个区间后,密度怎样更新
前面学条件概率时,我们把注意力限制在已知事件里,再重新分配权重。密度模型也做同一个动作:先把不符合条件的区域剪掉,再把留下来的面积归一化。
设已知事件是 X∈B,其中
P(X∈B)=∫Bf(x)dx>0.
对于新的观察范围 A,条件概率为
P(X∈A∣X∈B)=∫
因此条件下的密度可以写成
fX∣X∈B(x)=P(X∈B)
符号 1B(x) 在 x∈B 时为 1,其他地方为 0。它负责“剪掉”,分母负责“把剩下的面积放大到 1”。这是我们早先条件概率公式在面积语言里的同一件事。
例如 f(x)=2x 在 [0,1] 上,已知 X≥1/2。这个条件的概率是
P(X≥1/2)=1−F(1/2)=1−41
于是条件密度为
fX∣X≥1/2(x)=⎩
已知在右半段之后,落在 [3/4,1] 的条件概率是
P(X≥1/2)P(X≥3/4)=3/4
截取右半段并不会让它自动均匀。原密度越靠右越高,这个相对形状在更新后仍然保留。条件只改变支持区域与总规模。
这里要求条件事件概率为正。如果把条件写成 X=1/2,分母就是零,不能继续使用这个比值。后面学习联合密度与条件分布时,我们会解释如何处理连续变量的点条件;现在先把“条件在一个正概率区间里”这件事做好。
把密度、面积和累计值放在一起练习
小区间近似究竟近似在哪里
设 X 的密度在 [0,1] 上为 3x2,其余地方为零。计算 P(0.3≤X≤0.8);再比较 的精确值与左端点矩形近似,说明两者为什么不完全相等。
先检查 ∫013x2dx=1,函数非负,是合法密度。第一问为
先归一化,再跨段积分
设
f(x)=⎩⎨
求 c、完整的 F(x),以及 P(0.5≤X≤2)。
总面积为 c/2+2c=5c/2,因此 c=2/5。这个正数也保证密度非负。CDF 在第二段必须带上前一段已经累计的 1/5:
密度的一处高峰能决定中位数吗
设 f(x)=2x 在 [0,1] 上,其他地方为零。有人说:“0.9 附近的密度很高,所以 P(X=0.9) 很大,中位数也应该是 。”请分别指出这两个判断的问题,并求 分位数。
密度高度不能作为点概率。这里 f(0.9)=1.8,但 P(X=0.9)=0。中位数要满足左侧面积为一半,所以为 1/2;实际上 ,左侧已经积了 ,并没有平分概率。
从 CDF 求导时,怎样发现漏掉了概率
给定
F(x)=⎩⎨
它是不是合法 CDF?能不能把它在 (0,1) 上的导数当作整个分布的概率密度?计算 P(X=0) 与 P(0<X≤1/2)。
它不下降、右连续,左右无穷处分别趋于 0 和 1,是合法 CDF。在 0 处有跳跃,因此
P(X=0)=F(0)−F(在保留下来的区域内重新记账
设 X 具有本章的三角形密度。已知 X≥1,求条件密度,以及条件下 X≥1.5 的概率。再判断 P(X=1∣X≥ 是否仍为零。
右半边的原面积为 1/2,因此把这块密度乘以 2:
fX∣X≥1我们现在可以把一个连续模型读得比较完整了:密度说明概率在局部怎样分配,积分把它累积为区间概率,CDF 保存全部累计信息,分位数再从累计概率反查位置。遇到具体题目,先确认支持区域与密度合法性,再决定用积分、CDF 差或补事件,计算便有了依据。
接下来还差一个建模层面的问题:真实问题给出的是“等待时间”“一定范围内的位置”“许多小误差的合计”,通常不会直接递给我们一条分段函数。下一章就从这些机制出发,认识均匀、指数、正态、Gamma 与 Beta 分布,看看同一套密度与面积语言如何落到不同的模型里。