随机变量函数、变量变换与卷积
上一章,我们已经学会在知道一部分信息后重新计算概率:固定一个变量,看另一个变量的条件分布,再把条件解除。现在换一个很实际的问题。你知道两段等待时间各自怎样分布,可真正关心的是总共要等多久;你知道测量误差怎样分布,可评价误差时用的是平方;你记录了十次响应时间,最终报告的是其中最慢的一次。我们手里已有随机变量,却还没得到真正想研究的那个量。
求和、平方、取最大值,这些动作在代数里很熟悉,到了概率论里却多了一层问题:运算以后,原来的概率到哪里去了? 平方会把正负两边折在一起,缩放会把同一份概率摊到更长的区间上,排序则会改变我们关注样本的方式。我们需要跟着这些变化,把新变量的分布重新算出来。
这也是“随机变量是函数”这句话的一次具体应用。若 X 已经把试验结果翻译成一个数,再用一个函数 g 处理这个数,就得到 Y=g(X)。同一个随机结果仍然只有一份概率;我们改变的是它被记录成什么,以及哪些结果会被归到一起。
先找回原来的结果,再计算概率
设一个测量误差 X 只可能取 −2,−1,0,1,2,对应概率分别为 0.10,0.20,0.40,0.25,0.05。如果我们关心误差平方 Y=X2,那么 Y=1 究竟对应什么?它对应原来的两种情况:误差为 −1,或者误差为 1。这两个事件互不相交,因此概率应当相加。
于是新分布是
P(Y=0)=0.40,P(Y=1)=0.45,P(Y=4)=
你会发现,平方以后正误差和负误差的区别消失了,但它们各自携带的概率没有消失。这就是离散变量函数的通用做法:把映到同一个新取值的旧取值归为一组。
pY(y)=P(Y=y)=x:g
这里没有导数,因为我们搬运的是一个个点上的概率。函数是否拉长两个点之间的距离,并不影响这两个点各自有多大概率。
如果 X 有密度,事情就不能照搬了。每个单点的概率都是零,不能把“某个点的概率”当作密度来变换。我们要先问一整段新取值来自哪些旧取值。对一个可测集合 B,有
P(Y∈B)=P(X∈g−1(B)).
g−1(B) 表示集合的原像,也就是所有满足 g(x)∈B 的 x。这里的上标 −1 不表示函数一定有反函数。平方虽然不是一对一的,我们仍然可以问区间 的原像;答案是 。
严格地说,我们要求 g 是 Borel 可测函数,这样 Y=g(X) 才确实还是随机变量。连续函数、常用的分段连续函数、取整函数,以及后面用到的最大值和最小值函数,都满足这一要求。我们不必每算一题就重做可测性证明,但要知道,“随便写一个规则就一定是随机变量”缺少这个数学条件。
变量变换的出发点只有一个:新变量落进某个集合,等价于旧变量落进这个集合的原像。先把两个事件对应起来,再利用已知分布计算。后面的导数、Jacobian 和卷积,都是把这一步变成更便于计算的形式。
分布函数法:先解不等式,密度才有来处
分布函数法直接把刚才的集合选为 (−∞,y]:
FY(y)=P(Y≤y)=P(g(X)≤y)
这时任务从“猜一个新密度”变成了“解一个关于旧变量的不等式”。它对离散、连续以及混合分布都适用。先写出完整分布函数,也能看清是否出现跳跃、支持在哪里结束。
平方以后,为什么靠近零的密度变高了
设 X∼Uniform(−1,1),令 Y=X2。X 在原区间里等长的小段上有相同概率,但平方以后,Y 还会均匀分布吗?
先看支持。平方结果只能落在 [0,1],因此 y<0 时分布函数为零,y≥1 时分布函数为一。中间这段才需要计算:
FY(y)
把三段放在一起,才是完整答案:
FY(y)=⎩
这个分布函数是绝对连续的。在区间内部求导,得到一个密度版本:
fY(y)=⎩
所以 Y 并不均匀。比如 Y≤0.01 相当于 ∣X∣≤0.1,概率是 0.1;而原来的均匀变量落入一个长度为 0.01 的小区间,概率只有 0.005。平方在零附近压缩得很厉害,左右两边又同时折过来,同一段新区间接住了相对较多的概率。
密度在 y 接近零时趋于无穷,这并不表示零点有无穷大的概率,甚至不表示零点有正概率。实际上
P(Y=0)=P(X=0)=0,∫01
“密度很高”和“一个点有正概率”是两件不同的事。这个例子同时检验了支持、总概率和端点行为,比单独记住一个平方变换公式更有用。
连续输入也可能产生一个概率点
再让 X∼Uniform(−1,1),这次只记录正误差,令 Y=max(X,0)。所有负值都会被压到零,所以
P(Y=0)=P(X≤0)=21.
完整分布函数是
FY(y)=⎩
它在零处跳了 1/2。如果只对中间那段求导,得到 1/2,然后宣称这是整个分布的密度,就会丢掉零点上的一半概率。准确的描述应当是:零点有概率质量 1/2,在 (0,1) 上还有密度为 1/2 的连续部分。
先求分布函数很稳妥,但“求出来以后直接求导就是整个分布”需要条件。只有分布函数绝对连续时,密度的积分才恢复全部概率;一般分布可能含跳跃,也可能有连续却没有密度的部分。本章应用密度变换公式时,会明确要求原变量有密度,并要求变换在所用分支上足够规则。
单调变换:密度为什么乘反函数的导数
现在假设 X 有密度,g 在一个承载 X 全部概率的区间上严格单调、连续可微,且区间内部 g′(x)=0。这些条件让我们能够反解 ,并用导数换算小区间的长度。
递增和递减,要分别把事件写一遍
如果 g 严格递增,g(X)≤y 等价于 X≤h(y)。因此在新支持内部,
FY(y)=FX(h(y)),
由于反函数也递增,h′(y)>0。这时链式法则就给出了答案。
如果 g 严格递减,不等号方向会反过来:
FY(y)=P(X≥h(y))=1−F
最后一个等式用到了 X 没有点质量。若研究的是一般分布,应该写成 1−FX(h(y)−),保留端点处可能存在的概率。对当前有密度的情形求导,得到
fY(y)=−fX(h(y))h′
这次 h′(y)<0,负号恰好保证密度非负。两种情况可以统一写为
fY(y)=fX
其中 I 是原支持区间,在新支持以外密度取零。密度本来只需在几乎处处意义下确定,个别端点处怎样赋值不改变任何概率。
别只记“乘一个导数”,先想清楚单位
密度表示单位长度分到多少概率。若 Y=3X,原来的区间被拉成三倍长,同一份概率的密度高度理应降为三分之一。如果乘 g′(x)=3,既把宽度放大三倍,又把高度放大三倍,总概率就变成了原来的九倍。
更一般地,y 附近一小段长度 Δy,在原数轴上对应长度大约为 ∣h′(y)∣Δy。这两段对应同一批随机结果,所以
fY(y)Δy≈fX(h(y))∣h
消去 Δy 就回到了公式。这里说明的是局部区间的概率近似;前面的分布函数推导,则给出了它的严格依据。
平移缩放、等待时间和对数
对于 Y=aX+b,其中 a=0,反函数是 h(y)=(,因此
fY(y)=∣a∣1fX
平移只改变位置,缩放同时改变宽度和高度。特别地,若 X∼Exp(λ),a>0,则 Y=aX 的密度为
fY(y)=aλe−(λ
所以 Y∼Exp(λ/a)。把等待时间拉长 a 倍,对应的率参数变小,这也与 E[Y]=a/λ 一致。
若仍然让 X∼Exp(λ),但改成 Y=logX,反函数就是 x=ey。于是
fY(y)=λe−λeye
这里发生了两件事:支持从正半轴变成整条实轴;密度除了代入 ey,还要乘上 ey 这个长度换算因子。归一化可直接用 x=ey 检查:
∫−∞∞λe−λeye
递减变换也不难。设 U∼Uniform(0,1),T=−logU/λ,其中 λ>0。对 ,
P(T≤t)=P(U≥e−λt)=1−e
因此 T∼Exp(λ)。这个算式还告诉我们怎样从一个均匀随机数构造指数随机数。对递减函数,先正确翻转不等号,比记住一个带负号的公式更可靠。
非单调变换:每一个分支都要收到
平方的麻烦不在求导,而在一个新取值可能从两个旧位置到来。更一般地,假设可以把原支持分成有限个单调、连续可微的分支;分支内部导数非零,遗漏的分界点不携带概率质量。对某个新值 y,把落在原支持中的所有根记为 x1(y),…,xm(y),那么
fY(y)=i=1∑m
这里的求和是把互不相交的旧区间贡献加起来。每个分支内部用单调变换公式,不同分支之间用概率可加性。分支数还可能随着 y 改变,所以必须同时检查根是否落在原支持里。
沿着图中的两条分支往回找,同一个正数附近的输出小区间,会接住来自负半轴和正半轴的两份概率。两份贡献都要计入,但它们不必相等;是否相等,还要看原密度在两侧怎样分配。
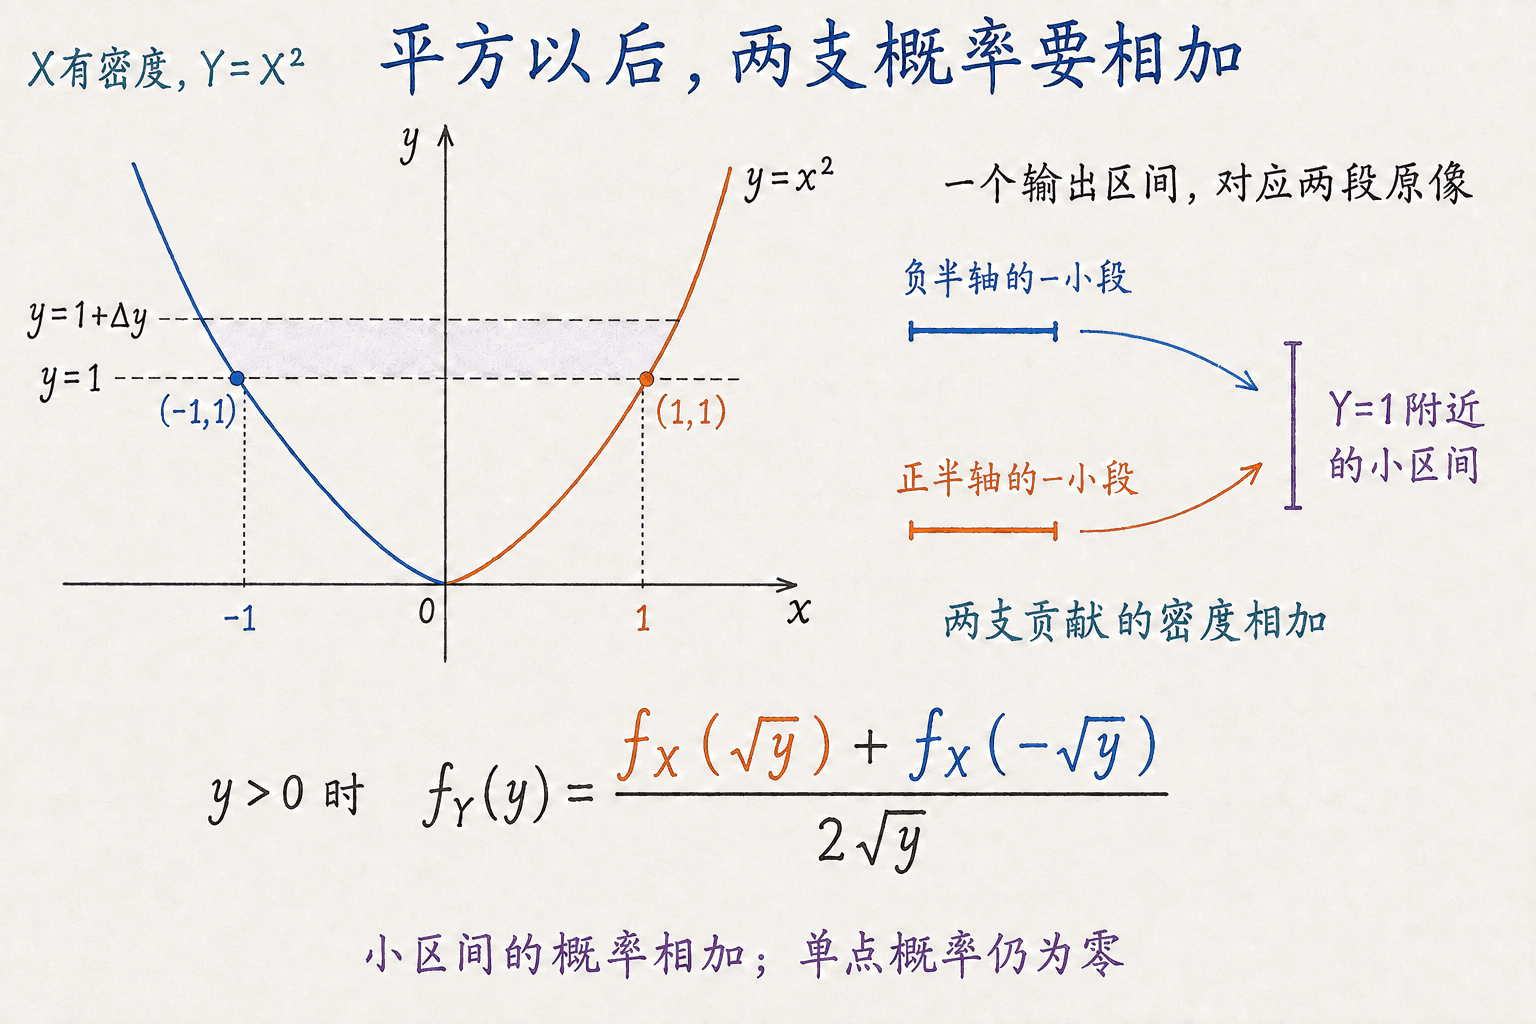 当 X 有密度且 Y=X² 时,正负两支都可能落入同一个输出区间;y>0 处的密度需把两支贡献相加,再除以伸缩因子 2√y。
不对称支持会让两个分支在半路变成一个
设 X∼Uniform(−1,2),令 Y=X2。现在原密度是 1/3,新支持是 。对 , 和 都在原区间里,两边都有贡献;对 ,负根已经小于 ,只有正根有效。因此
fY(y)=
不妨用分布函数再核对一次。当 0≤y<1,原像是 [−y,y;当 ,原像被支持截成 。因此
FY(y)=
两段在 y=1 都给出 2/3,所以这里没有概率点。密度在这里出现跳变,是因为一个分支停止贡献;分布函数本身仍然连续。总概率也正好是 2/3+1/3=1。
正态平方:两个分支怎样合成卡方密度
设 X∼N(0,1),其密度记为 φ(x)=(2π)−1/2e。令 ,对 ,两个根永远都有效。由于 ,
fY(y)
支持外密度为零。这个分布称为自由度为 1 的卡方分布,也就是形状 1/2、率 1/2 的 Gamma 分布。名称可以以后慢慢熟悉,当前更要紧的是看见两个分支怎样相加。只有因为标准正态密度对称,才可以把两项合成两倍;一般的非对称密度不能这么做。
平方在 x=0 处导数为零,公式在 y=0 处也有奇异性,但原变量在零点没有质量,因此不妨碍这个密度描述全部概率。与之不同,上一节的 max(X,0) 在整段区间上保持常数,把正概率的一整段压成一个点。这时单靠分支密度公式就不够了,还必须单独记录那个概率点。
下面的交互可以把这两步分开看。先选“标准正态”和“平方”,把 y 移到 1,检查两个原像是否为 −1 与 1,每个贡献是否为 φ(1)/2;再换成“均匀”和“线性”,观察只有一个分支时密度怎样缩放。图中的色带表示对应区间的位置,概率要看色带内密度曲线下的面积,不能把整条竖向背景带当作概率。曲线只画出有限窗口;平方图为了避开零处无界密度,从正数开始展示,不表示零附近那一段概率消失了。
二维变量变换:不仅换公式,还要换区域
求总量、比例或者距离时,一个新变量往往同时使用两个旧变量。与其一开始就把信息压成一个数,我们可以先保留两个新坐标,再通过边缘化取出想要的那个。这正好接上前两章的联合分布。
设 (X,Y) 有联合密度 fX,Y,在区域 D 内进行变换
U=g1(X,Y),V=g2(X,Y
假设这个变换在 D 内一对一、连续可微,Jacobian 行列式不为零,并有连续可微的反函数
x=x(u,v),y=y(u,v).
这些是本章采用的充分条件;零概率边界可以单独处理。在新区域 D′=g(D) 内,密度公式为
fU,V(u,v)=f
其中
∂(u,v)∂(x
在 D′ 外,密度为零。如果只能分块做到一对一,就要对各个有效反函数分支分别计算,再把贡献相加,和一维折叠的思路相同。
Jacobian 的方向为什么不能含糊
一维时换算长度,二维时换算面积。uv 平面上一小块矩形经过反函数,会在 xy 平面上变成近似的平行四边形。矩阵的两列分别描述两个坐标方向的伸缩和倾斜,行列式绝对值给出面积放大倍数。因此
dxdy=∂(u,v)∂
让同一块事件的概率保持一致,就要有
fU,V(u,v)dudv=fX
代入面积关系,就得到密度公式。严格地说,这是多元积分换元公式的应用;小平行四边形的图景帮助我们理解它为什么成立。
为了避免写反,可以始终读成“旧面积除以新面积”。如果算到的是正向行列式 ∂(u,v)/∂(x,y),则要在对应点取绝对值的倒数。比如 U=2X,V=3Y,新面积扩大六倍,新密度必须乘 1/6。
总等待时间和其中一段占比
设 X,Y 独立,均服从率为 λ 的指数分布。我们关心总等待时间 U=X+Y,以及第一段在总时间中占的比例 V=X/(X+。因为 几乎必然成立,分母为零的事件可以忽略。
反解很直接:
x=uv,y=u(1−v).
先处理区域。原来是 x>0,y>0,所以总量 u>0,比例满足 0<v<1。反过来,这两个条件也保证 和 。因此新区域恰好是 ,没有额外的斜边约束。
接着计算反向 Jacobian:
∂(u,v)∂(x,y)=
绝对值为 u。由独立性,原联合密度是 λ2e−λ(x+y),所以
fU,V(u,v)=λ2ue−
最后才求边缘:
fU(u)=∫01λ
fV(v)=∫0∞λ
第一个密度积分为一,可以换元 t=λu 后用 ∫0∞te−tdt=1 核对。于是 ,。新支持是两个区间的直积,且联合密度等于两个边缘密度的乘积,因此 独立。
这个结论并不表示所有“总量和占比”都独立。它依赖于当前的指数分布以及两个率相同。如果两个率分别为 λ1,λ2,指数项会变成 exp{−u[λ1,总量和比例就不能这样分离。
公式能拆开,支持却未必能拆开
设 (X,Y) 在三角形 x>0,y>0,x+y<1 上均匀分布,因此联合密度是 2。令 ,反函数为 ,Jacobian 绝对值为 。
不能到这里就写“fU,V=2,因此两个变量独立”。原区域条件给出
0<u<1,0<v<u.
于是完整联合密度是 21{0<v<u<1}。固定 u 以后,v 的范围也跟着变;这恰好在表达依赖关系。边缘密度为
fU(u)=∫0u2dv=2u
fV(v)=∫v12du=
它们的乘积不是原联合密度。进一步,
fV∣U(v∣u)=2u2
知道总量为 u 后,第一部分在 (0,u) 上均匀分布。条件分布的支持直接随 u 改变,也就看清了为什么二者不独立。做二维变换时,支持区域本身就是联合分布的一部分,不能把它留在草稿里。
卷积:把所有凑成同一个总和的方式加起来
现在专门研究 S=X+Y。你在导论课里算过两枚骰子的总点数:总和为七有六种配对,总和为二只有一种。背后的动作仍然是找原像,只不过原像从数轴上的点变成了平面上一条斜线上的配对。
离散和:独立性到底用在哪一步
对于离散变量,按 X 的取值拆分事件,有
P(S=s)=x∑P(X=x,Y=s−
这些事件互不相交,因此可以直接相加。到这里不需要独立。只有当 X,Y 独立时,才能进一步写成
pS(s)=x∑pX(x)
这个运算叫作卷积。比如某个设备一天需要的补充件数 X 取 0,1,2,概率分别为 1/2,1/3,1/6;另一个独立设备需要的件数 Y 取 0,1,概率分别为 。总需求 的分布为
四项之和为一。总和为二的两项,分别来自 (X,Y)=(1,1) 和 (2,0),每个乘积都有一对具体的旧取值作解释。
连续和:先保留一个坐标,再边缘化
连续变量不能把斜线上的点概率相加,因为整条斜线在二维密度模型下的概率也是零。我们可以使用刚才的二维变换,把 S=X+Y 和 W=X 一起保留下来:
x=w,y=s−w,
于是
fS,W(s,w)=fX,Y(w,s
对 w 积分,得到一般联合密度情形下的公式:
fS(s)=∫−∞∞f
若 X,Y 独立,才可以拆成两个边缘密度的乘积:
fS(s)=∫−∞
上一章的条件化思路也会给出同样的结果。先固定 X=x,则 S≤s 等价于 Y≤s−x,由独立性,
FS(s)=∫−∞∞F
把 FY(s−x) 写成密度积分,再交换非负函数的积分次序,就能得到上面的卷积密度,而不需要未经检查地把微分搬进积分号。这两条推导分别从坐标和条件事件出发,说的是同一件事。
两个均匀变量:积分上下限由重叠决定
设 X,Y 独立且均服从 Uniform(0,1)。S 的支持是 [0,2],但总和不会均匀分布。卷积里的两个密度同时非零,要求
0<x<1,0<s−x<1.
第二个条件等价于 s−1<x<s。因此真正的积分区域为
max(0,s−1)<x<min(1,s).
两个密度在有效区间里都等于一,所以积分值就是区间长度。当 0<s<1,有效区间是 (0,s);当 1≤s<2,有效区间是 (。于是
fS(s)=⎩
三角形密度就是这么来的:能凑成中间总和的配对比较多,能凑成接近端点总和的配对比较少。对 0≤s≤1,还可以从单位正方形中 x+y≤s 的三角区域直接计算
FS(s)=2s2.
对 1<s≤2,去掉右上角边长为 2−s 的三角形,得到 FS(s)=。求导与卷积完全一致。
如果两个均匀变量的区间长度不同,重叠长度可能先增长、再保持不变、最后减少,得到梯形密度。因此“均匀加均匀得到三角形”也要带着两个区间长度相同这一条件读。
在下面的卷积交互里,先选“均匀 + 均匀”,把 z 从 0 移到 1 再移到 2,核对有效区间长度与右侧密度数值。这里的 z 就是正文的总和值 s。紫色画的是两个密度的乘积,不是取两条曲线较低的一条;只有当前单位均匀模型中,乘积面积才恰好等于区间重叠长度。切换正态模型可以看清二者的差别。有限绘图窗口会截掉尾部,右侧数值采用对应模型的理论密度。
指数等待时间:总量为什么变成 Gamma
设 X,Y 独立,均为 Exp(λ)。要让 x>0 和 s−x>0 同时成立,必须有 且 。因此
fS
这与总量、比例变换得到的 U 密度一致。现在我们从另一个方向核对了同一结果:两段独立、同率的指数等待时间相加,得到形状 2、率 λ 的 Gamma 分布。
为什么它不再是指数分布?总时间很小,要求两段等待都很小,因此密度在零附近从零开始;单段指数等待的密度在零处却是最大的。那个额外的 s 因子,正是在累计所有可行的时间分配方式。
同样的边缘,换个依赖关系,总和就变了
仍让 X∼Uniform(0,1),但令 Y=1−X。Y 的边缘分布也是均匀分布,可是 X+ 几乎必然成立,总和全部集中在一个点上,完全没有三角形密度。
如果改成 Y=X,两个边缘仍然相同,而 X+Y=2X 在 (0,2) 上均匀分布。加上前面的独立情形,相同的两份边缘分布已经产生了三种不同总和。
边缘分布不能替代联合关系。普通卷积需要独立性;一般公式 ∫fX,Y(x,s−x)dx 也需要联合密度存在。像 或 这种概率集中在一条直线上的情形,没有二维联合密度,应直接利用变量之间的确定关系求分布。
最大值、最小值:把一句话改写成事件
求和把数值累加,最大值和最小值则是在挑位置。设 X1,…,Xn 独立同分布,公共分布函数为 F,记
Mn=max(X1,…,X
“最大值不超过 t”意味着每一个观测都不超过 t。所以
FMn(t)
第二行用的是独立性。“最小值不超过 t”意味着至少有一个观测不超过 t,直接拆开会遇到事件重叠。改看补事件就简单了:“最小值大于 t”意味着每一个观测都大于 t。
P(mn>t)=[1−F(t)]
这两个分布函数公式对离散分布也成立。如果公共分布有密度 f,再求导得到
fMn(t)=nF(t
几乎处处成立。若变量独立但不同分布,最大值分布函数应为 ∏iFi(t),最小值的尾概率应为 ∏i[1;写成同一个函数的 次幂需要同分布。
同一批任务,最先完成和全部完成差多少
假设 n 个任务独立运行,每个完成时间均为 Exp(λ)。最先完成的时间就是 mn。对 t≥0,
P(mn>t)=(e−λt)
所以 mn∼Exp(nλ),期望为 1/(nλ)。有更多独立任务同时竞争,最先出现完成结果的时间变短。
而等到所有任务都完成,需要 Mn,其分布函数为
P(Mn≤t)=(1−e−λt)
它一般不是指数分布。不要因为每个任务都是指数等待,就把最小值、最大值和总和都判成同一种分布:它们分别对应“至少一个完成”“全部完成”和“把用时相加”,对应的事件结构不同。
下面的交互把一组已抽出的样本和模型的理论概率放在一起。先固定样本量,移动阈值 t,检查“最大值不超过 t”是否正好在所有点都落到左侧时成立;再检查“最小值大于 t”是否要求所有点都在右侧。重抽样本会改变当前事件是否发生,却不会改变同一 n,t 下的理论概率。指数模型的横轴只有有限显示范围,个别超出范围的样本会显示在边缘,实际数值仍由标签和事件判断给出;不能把绘图边界误认为指数分布的支持端点。
顺序统计量:第几个小,可以转成计数问题
最大值和最小值只是排序的两个端点。把样本从小到大排为
X(1)≤X(2)≤⋯≤X
第 k 个位置上的变量 X(k) 叫第 k 个顺序统计量。括号不能省略:Xk 是原来第 次记录, 是排序以后第 小的记录,二者是不同的函数。
分布函数:数一数有多少观测已经越过门槛
事件 X(k)≤t 的意思是至少有 k 个样本不超过 t。定义计数变量
Nt=i=1∑n1{X
独立同分布让每个指示变量都是成功概率 F(t) 的独立伯努利变量,因此 Nt∼Binomial(n,F(t))。于是
FX(k)(t)=
这一步不要求样本无重复,所以离散分布也可以用。排序看起来改变了所有位置,但计算分布函数时,只需要在固定门槛下做一次二项计数。
密度里的阶乘来自哪里
现在假设公共分布有密度 f。在 f 连续的一个点 t 附近,若第 k 小的观测落在 (t,t+Δt],主要情形是: 个观测在左边,一个观测落在这段短区间,余下 个在右边。
先从 n 个有标签的观测中选出落入短区间的那个,有 n 种选法;再从其余 n−1 个中选出左边的 k−1 个,有 ( 种。给定这一分配,它的概率主项是
F(t)k−1f(t)Δt[1−F(t)]n−k.
两个或更多观测同时落进短区间的概率是更高阶小量,在除以 Δt 再取极限时消失。由此得到
fX(k)(t)=
一般密度情形也可以对前面的二项尾和用链式法则求导,得到同一公式,几乎处处成立。代入 k=1 和 k=n,恰好恢复最小值和最大值密度,这是一项很直接的检查。
均匀样本的中位数,为什么更靠近中间
取五个独立的 Uniform(0,1) 样本,研究样本中位数 T=X(3)。在 (0,1) 上 ,因此
fT(t)=2!2!5!t
虽然原来每个样本都是均匀的,中位数已经明显向中间集中。中位数非常小,要求至少三个观测都很小;中位数非常大,同样需要至少三个观测都很大。两端都比单个样本难以出现。
如果问 P(T≤1/4),二项计数通常比积分更直接:
P(T≤1/4)
原来单个样本落在前四分之一的概率是 1/4,中位数落在那里的概率约为 0.104。排序得到的新变量确实有了不同分布。
一般地,n 个独立均匀样本的 X(k) 服从 Beta(k,n+1−k)。把密度与 Beta 形式比较可以识别这个名称;即使暂时不记 Beta 分布,前面的事件计数与密度推导也已经足够完成计算。
练习:先解释原像,再写计算
练习一:平方恰好抵消原来的密度倾斜
设 X 的密度为 fX(x)=2x,0<x<1,其他地方为零,令 。分别用分布函数法和单调变换法求分布,并解释为什么只需要一个分支。
原支持完全位于正半轴,平方在这段上严格递增。虽然方程 x2=y 有两个代数根,但负根不在原支持上,所以不贡献概率。
对 0≤y≤1,
F练习二:倒数会把支持移到哪里
设 X∼Uniform(1,3),令 Y=1/X。求 Y 的完整分布函数和密度,核对积分为一。
倒数在原区间上递减,新支持是 [1/3,1]。对 1/3≤y<1,
FY练习三:长度不同的均匀变量相加
设 X∼Uniform(0,1),Y∼Uniform(0,2),二者独立。求 S=X+ 的密度,并说明为什么中间有一段平台。
有效积分范围由 0<x<1 和 0<s−x<2 共同确定,即 (0,1)∩。被积函数在交集内为 。当 从零增至一,交集长度为 ;从一增至二,长度始终为一;从二增至三,长度为 。所以
练习四:同一个 Jacobian,不同的支持
设 X,Y 独立且均服从 Uniform(0,1),令 U=X+Y,V=X。求联合密度及新支持,并判断 是否独立。
反函数仍为 x=uv,y=u(1−v),Jacobian 绝对值仍为 u。但现在原条件多了 x<1,y<,因此新支持为
练习五:第三个完成的任务
六个任务的完成时间独立同分布,公共分布函数为 F。假设某个时刻 t 满足 F(t)=1/2,求第三个任务在 t 之前或恰好在 t 完成的概率。若公共分布有密度 f,再写出第三个完成时间的密度。
第三个完成时间是 X(3)。它不超过 t,等价于六个任务中至少三个已在 t 时完成。于是
从两项相加,走向很多项相加
到这里,我们已经能沿着一条完整路线处理新变量:先把新事件写回旧变量,确定原像和支持;离散变量把概率归组相加,有密度的单调变换换算长度,二维变换换算面积;若一个新位置来自多个分支,就收齐所有贡献。最大值和顺序统计量则提醒我们,有时直接解释事件,比寻求一个反函数更简单。
回头看导论课里的两枚骰子,我们当时靠列举算出总点数,现在已经把同一个动作写成了对离散和连续变量都适用的卷积。若有 n 个相互独立的变量,设 Sn=X1+⋯+X,还可以利用 一次次卷积。计算是有依据的,但项数一多,反复积分或求和就会变得繁重。
下一章会因此换一种记录分布的方法:把概率或矩组织成一个函数,使独立变量的求和对应函数相乘。之后再研究大量项相加时平均值怎样稳定、标准化波动怎样形成极限分布。我们先在这一章把“怎样精确算一个和”弄清楚,才能分辨后面哪些结论是精确分布,哪些是在明确条件下成立的近似与极限。