离散随机变量与常见离散分布
上一章我们把随机变量看成一条翻译规则:它把一次试验的结果翻译成数字,再用分布函数记录这些数字携带的概率。现在来看一个更具体的问题。一个传感器每次发送数据都有可能成功,也有可能失败。如果你记录的是“这次是否成功”,答案只有 0 和 1;如果记录“发十次成功了几次”,答案在 0 到 10 之间;如果记录“直到成功才停,总共发了几次”,答案可能一直往后延伸。
设备没有换,成功和失败的含义也没有换,换了我们要数的东西,分布就换了。这正是学习常见分布时最值得抓住的线索。我们不用先背一排名字,而是跟着问题走:一次成败怎样变成固定次数内的成功数?固定终点改成“等到成功”,公式为什么会变?再把独立重复改成不放回抽样,又会发生什么?
这一章会把这些问题算清楚。你在导论课上见过的“二项分布适合数成功次数”,在这里要落实为条件明确、每个因子都有来处的概率公式。
一张概率表,怎样接上分布函数
先把“离散”讲准确。若存在有限或可数无限的数值集合 S,使得 P(X∈S)=1,我们就说 X 是离散随机变量。公平骰子的点数只落在六个整数上;首次发送成功所需的次数可以是任意正整数,两者都是离散的。取值不一定是整数,也不一定等间距:抽中某张优惠券后得到的金额可以是 0 元、2.5 元或 18 元。
我们通常把正概率取值组成的集合写成
SX={x∈R:P(X=x)>0}.
本章所说的“支持集”采用这个离散意义。它告诉我们哪些数实际承载概率。离散分布的点也未必在几何上互相隔开,例如 1,1/2,1/3,… 就有聚点;关键在于概率能够集中到一张可数的取值表上。
表里的每一项由概率质量函数给出,英文缩写是 PMF:
pX(x)=P(X=x).
一张合法概率表必须满足非负性和总和为 1:
pX(x)≥0,x∈SX∑
第一条不允许“负的可能性”,第二条保证没有漏掉任何有概率的取值。支持集外的 PMF 一律取 0。以后写出一个带常数的公式,先检查这两条,比急着给分布起名字更有用。
假设某抽签活动发放的奖金 X 为 0,4,10 元,相应概率为 0.5,0.3,0.2。问“至少得到 4 元”,就把 4 和 10 两个取值的概率相加,得到 。问“严格超过 元”,只剩 元,概率是 。离散分布中一个端点就可能带着很大一块概率,不能随手把 与 换来换去。
PMF 和上一章的 CDF 其实是同一份信息的两种整理方式:
FX(t)=P(X≤t)=x∈S
如果只取整数值,那么 CDF 每经过一个有正概率的整数就跳一次。反过来,某点的跳跃高度就是点概率:
pX(k)=FX(k)−F
这里要减去左极限,不能对任意离散变量都写成 FX(k)−FX(k−1);后一种写法只有在区间 (k 没有其他可能取值时才成立。对整数值变量,区间概率可写成
P(a≤X≤b)=k=⌈a⌉∑⌊b⌋
求和只留下支持集内的项即可。PMF 图上的柱高表示点概率;柱子画多宽只是排版选择,不靠“柱子的面积”定义概率。这一点会在下一章学习连续密度时形成鲜明区别。
一次成败,为什么只需要一个参数
回到传感器。成功传送一次记 I=1,失败记 I=0,设成功概率为 p。那么整张概率表只有两项:
P(I=1)=p,P(I=0)=1−p,0≤p
这就是伯努利分布,记为 I∼Bernoulli(p)。给出成功概率后,失败概率就由总和为 1 决定,所以只需一个参数。对 0<p<1,也可以压缩写成
P(I=x)=px(1−p)1−x,x∈
把 x=1 和 x=0 分别代入,就能还原那两项概率。端点 p=0 或 p=1 直接看概率表最清楚:前者恒等于 0,后者恒等于 ;此时真正的支持集只剩一个点,不必纠结压缩公式中的 。
“成功”只是给一种结果起的名称,不一定意味着好事。若我们记录“数据是否丢失”,丢失也可以记成成功。更一般地,对任意事件 A,定义指示变量
IA={1,0,
即使原始实验有很多结果,只要问题最后被归成“属于 A”和“不属于 A”,就得到伯努利变量。一次掷骰子有六种点数,记录“点数是否大于 4”却是参数 1/3 的伯努利变量。这也再次说明:决定分布的是翻译后的变量,以及原始结果的概率。
先给均值和方差一个可计算的含义
后面会专门建立期望和方差的理论。为了理解不同分布的中心和波动,我们先用离散概率表预览这两个量:
E(X)=x∑xpX(x)
有限支持集时,这就是普通的有限加权和。无限支持集时,有限期望要求 ∑x∣x∣pX(x)<∞,有限方差还需要二阶矩有限。本章列出的分布在给定非退化参数下都满足这些要求。现在可以把期望读成“按概率加权的位置”,把方差读成“离这个位置的平方距离的加权平均”;它们与长期样本平均的联系,后面要用大数定律严格说明。
伯努利变量的计算尤其直接:
E(I)=0(1−p)+1p=p,E(I2)=
利用平方展开得到的 Var(I)=E(I2)−[E(I)]2,便有
Var(I)=p(1−p).
例如 p=0.8 时,期望为 0.8,方差为 0.16。期望不是说某次能观测到“成功 0.8 次”;单次仍只有 0 和 1。它给概率表标出了一个加权中心,这个中心完全可以不在支持集里。
固定做多少次,再问成功了几次
现在约定发送 n 次,每次成功概率都为 p,各次结果相互独立。令第 i 次是否成功的指示变量为 Ii,那么总成功次数就是
X=I1+I2+⋯+I
它服从二项分布,记为 X∼Binomial(n,p)。这里 n 是非负整数,p∈[0,1]。当 n≥ 且 时,支持集为 。
先别记公式,试着算“四次发送,恰好两次成功”。一种符合要求的结果是“成、败、成、败”,独立性让它的概率等于 p2(1−p)2。但它不是唯一的结果:两次成功还可以出现在位置 1,2,也可以出现在位置 3,4。四个位置中选两个放成功,有 种选法。这六个具体结果互斥,所以要相加。
一般情况下,恰好 k 次成功的每条结果序列都带着概率 pk(1−p)n−k,而成功位置有 ( 种,因此
P(X=k)=(kn)pk(
组合数负责数“有多少种位置安排”,概率乘积负责算“每种安排多可能”。独立性支持乘法,同一个 p 保证这些安排有相同概率,互斥性支持最后的加法。少了其中任何一个依据,这段推导都需要重新检查。
二项展开也替我们完成了归一化检查:
k=0∑n(kn)p
当 n=0 时根本没有试验,成功数恒为 0;当 p=0 时也恒为 0;当 p=1 时恒为 n。这些退化情形和问题本身完全一致。
同一个概率表,可以回答不同的问题
假设六次发送相互独立,成功概率都是 0.8。恰好五次成功的概率为
P(X=5)=(56)(0.8)5(0.2)=0.393216.
至少五次成功还要加上全部成功:
P(X≥5)=P(X=5)+P(X=6)=0.393216+0.262144
如果只要求“至少一次成功”,逐项加 P(X=1) 到 P(X=6) 就显得费力。其反面是一次都没有成功,于是
P(X≥1)=1−P(X=0)=1−(0.2)6
这不是三种分布,而是对同一张概率表提出三个不同的事件。做题时先把中文翻译成 X=5、X≥5 或 X≥1,常常就能避免把“恰好”“至少”“至多”混在一起。
均值为什么是 np,方差为什么多一个 1−p
把成功次数拆成指示变量,后续期望的线性性会给出 E(X)=∑iE(Ii)=np。我们也可以只靠已经得到的 PMF 直接验证。对 ,用恒等式 ,有
E(X)
最后那一整段求和是一个参数为 n−1,p 的二项概率总和,等于 1。同样处理 X(X−1),得到
E[X(X−1)]=n(n−1)p2.
由于 X2=X(X−1)+X,便有
Var(X)=n(n−1)p2+np−n
当 p 接近 0 或 1,结果几乎一边倒,波动小;p=1/2 时,固定 n 下方差最大。六次、成功率 0.8 的例子中,,。中心在 附近,并不要求单次结果能等于 。
“每次成功概率相同”不能代替“相互独立”。如果只随机决定一次设备状态,然后六次要么全成功、要么全失败,每次的边缘成功概率仍可都是 0.8,总成功数却只取 0 和 6,不服从二项分布。若各次独立但成功概率不同,总数一般也不再是这一参数形式的二项分布。
“有放回”常用来保证从固定总体中每次抽样的成功概率相同,但二项分布不要求题目一定出现放回两个字。发送、抛硬币、独立检测都可以符合条件。真正要检查的是固定次数、相互独立和同一成功概率。
不预先定次数,改成等到第一次成功
固定发六次后停下来,得到二项成功数。如果改成“失败就继续,第一次成功后停止”,我们记录的是另一个变量 T:包含最后成功那一次的总发送次数。因此最小值是 1,而不是 0。
仍设各次独立、成功概率恒为 p,先取 0<p<1。要使 T=4,唯一可能的成败模式是“败、败、败、成”。这里没有组合数,因为前三次只要提前出现成功,我们就已经停了。于是
P(T=k)=(1−p)k−1p,k=1,2,
这就是几何分布,记为 T∼Geometric(p)。令 q=1−p,归一化来自几何级数:
k=1∑∞qk−1p=1−q
这还说明成功最终会以概率 1 出现。具体地,前 m 次都失败的概率为 qm,它随着 m→∞ 趋于 0。这里的“最终成功概率为 1”不提供一个保证够用的有限次数;对任何有限的 , 仍然大于 。
若 p=1,T 恒为 1;若 p=0,永远不会成功,等待次数应记为 +∞,不能继续把它当成支持在正整数上的几何分布。
等待问题中,尾概率往往最好算
事件 T>m 的意思是“前 m 次尚未成功”。不用把无限多个 PMF 加起来,直接看这 m 次即可:
P(T>m)=qm,m=0,1,2,….
因此在整数 m≥1 处,
P(T≤m)=1−qm,P(T≥m)=q
“大于 m”意味着前 m 次都失败,“至少需要 m 次”只意味着前 m−1 次都失败。两者差了一个试验,这个差别正是等待题中最常见的偏一错误。
例如每次成功概率为 0.25,至少需要四次的概率是 0.753=0.421875,恰好第四次成功的概率则要再乘最后那次成功的 0.25,得到 0.10546875。如果希望在限定次数内成功的概率至少达到 0.95,需要
1−0.75m≥0.95⟺m≥log0.75log
右侧约为 10.413,所以最少安排 11 次。对数分母为负,解不等式时必须反向;最后还要向上取整,因为次数只能是整数。
无记忆性究竟忘掉了什么
已经连续失败五次,会不会“下一次更该成功”?在这个独立同概率的模型里不会。对非负整数 s,t,
P(T>s+t∣T>s)
它说的是:已知前 s 次都失败,再需要等待的次数 T−s,其条件分布和从头开始等待一样。被保留下来的总次数当然已经增加了,重新开始的是“还要等多久”的分布。
这条无记忆性依赖每次成功概率不变。如果系统每次失败后自动提高功率,下一次成功概率可能上升;如果元件随使用老化,可能下降。两种情形都不能直接套几何分布。它也没有说“一次失败后更应该成功”或“连续失败说明快轮到成功”,那些说法给模型添加了并不存在的补偿机制。
几何分布的中心和波动为
E(T)=p1,Var(T)=p
可以从 ∑k≥0qk=(1−q)−1 在 内求导来核算:
k=1∑∞kqk−
分别乘以 p,得到 E(T)=1/p 和 E(T2)=(1+,再减去均值平方即可。 时,平均等待次数为 ,方差却是 。平均是四次,不代表“大多恰好第四次成功”;几何 PMF 最大的一项始终在 ,少量很长的等待会把加权平均往右拉。
还有一种常见记法让 G=T−1 表示首次成功前的失败次数。此时
P(G=j)=qjp,j=0,1,…,E(
平移不改变方差,所以 Var(G)=q/p2。这两张表描述同一个停止过程,只是记账起点不同。看到软件函数或题目的“几何分布”,先读变量究竟数总次数还是失败次数。
等到第三次成功,最后一步仍然不能自由安排
若系统必须收到 r 个成功数据包才停止,令 Tr 表示达到第 r 次成功所需的总次数,其中 r 是正整数。显然 Tr;当 时,支持集为 。
要使 Tr=k,必须同时满足:前 k−1 次中恰有 r−1 次成功,第 k 次成功。先把最后一次钉住,再计算前面的排列:
P(T
这就是本章采用的负二项分布总次数版本,记为 Tr∼NegativeBinomial(r,p)。
为什么不能用 (rk)?因为它计算的是“前 k 次共有 r 次成功”,会把第 r 次成功早已发生、最后一次却失败的序列也算进去。例如要等第三次成功,“成、成、成、败、败”虽然五次中成功了三次,但早在第三次就停止了,不能算作 。
若 p=0.4,等到第三次成功恰好用六次的概率为
P(T3=6)=(25)(0.4)
如果问“六次以内能否收齐三个成功包”,可以换一种角度:这等价于前六次中至少成功三次。设 B6 是前六次的成功数,则
{T3≤6}={B6≥3}.
一般地,对于整数 m≥r,
P(Tr≤m)=P(Binomial(m,p)≥r).
这个事件恒等式把“等多久”和“到某时刻成功几次”接在一起。它也证明 Tr 有限的概率为 1:P(Tr>m) 是一个二项分布仅取 到 的概率和;固定 后,各项都含有指数衰减的 乘上至多固定次数的多项式,故总和趋于 。
另一种理解是把等待切成 r 段:从开始到第一次成功,从第一次成功之后到第二次成功,依此类推。独立试验序列让这些段长 G1,…,Gr 相互独立,每段都是总次数版本的几何分布,并且
Tr=G1+⋯+Gr.
后面独立和的理论会由此给出
E(Tr)=pr,Var(T
取 r=1,全部公式都回到几何分布。若 p=1,则 Tr=r;p 时永远收不齐,有限次数分布不再成立。
若改记达到第 r 次成功之前的总失败次数 Fr=Tr−r,则
P(Fr=j)=(r−1
并且 E(Fr)=r(1−p)/p,方差仍为 r(1−p)/p。负二项分布不是一般的无记忆等待:等三次成功时,已等了几次并不能告诉我们还缺几次成功;如果前面已经成功两次,剩下的任务显然不同于一次都没有成功。
把一串具体成败结果交给三种计数规则,会得到三个不同的数。下面这串结果只是一次可能的记录;真正的分布还要把所有可能的记录及其概率一起考虑进去。
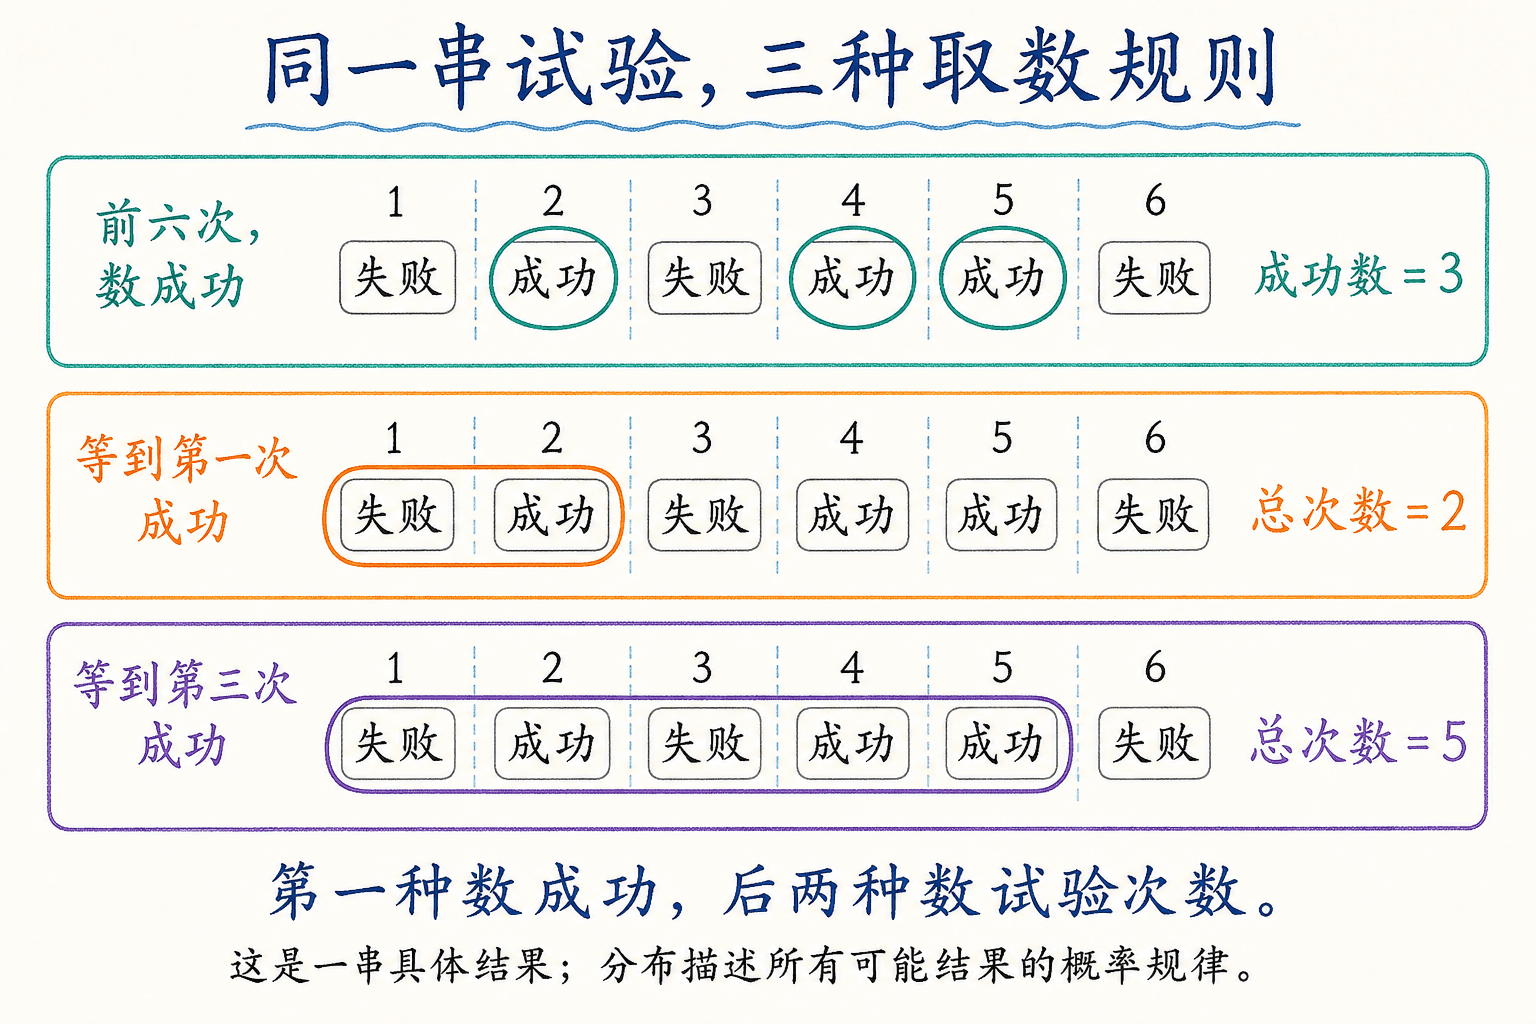 取数规则决定随机变量记录什么:固定六次时数成功,等待成功时数已经进行的试验次数。图中展示一串具体结果;分布还要描述其他可能结果及其概率。
不放回抽样,为什么不能沿用二项公式
到这里,所有重复试验都建立在独立同概率的条件上。换一个问题:仓库共有 12 个模块,其中 4 个需要维修。随机不放回抽出 5 个,令 X 表示抽中的待修模块数。
每个位置在抽样前看都有 4/12 的待修概率,但抽出一个待修模块后,下一次的待修概率会变成 3/11;抽出一个正常模块后,则变成 4/11。边缘比例相同不等于抽样结果独立。此时二项推导中“每种成败序列都由固定的 p 相乘”这一环已经不能原样使用。
更合适的办法是直接数抽到的集合。一般设总体大小为 N,其中 K 个称为成功对象,等可能地抽取一个大小为 n 的子集。参数须满足
N≥1,0≤K≤N,0≤n≤N,
并且都是整数。抽中的成功数 X 服从超几何分布,记为 X∼Hypergeometric(N,K,n)。
先把不可能的取值排除
成功数不能小于 0,不能超过抽样总数 n,也不能超过总体里的成功数 K。还有一个容易漏掉的约束:失败数 n−k 不能超过现有失败总数 N−K。因此
max(0,n−(N−K))≤k≤min(n,K).
这段整数区间就是支持集。如果 N=10,K=8,n=5,总体只有两个失败对象,抽五个时至少成功三个;把 0,1,2 都画成“可能的成功数”就错了。
分子和分母必须数同一种对象
全部大小为 n 的子集有 (nN) 个。要恰好抽中 k 个成功对象,就从 K 个中选 k 个,再从 个失败对象中选 个。两次选择共同确定唯一的抽样集合,所以
P(X=k)=(nN)
分子、分母都不计抽出顺序。也可以使用有序抽样推导,但不能让分母数集合、分子却数有序序列。这个公式成立还要求每个大小为 n 的子集等可能;“不放回”本身并不排除偏向某些对象的抽样方式。
归一化也有直接的计数解释:全部大小为 n 的子集,可以按其中成功对象的数量 k 分组。因此
k∑(kK)(n−k
回到 12 个模块中 4 个待修、抽出 5 个的例子,恰好抽中两个待修模块的概率为
P(X=2)=(512)
若问题是“至少发现一个”,其反面是五个都正常:
P(X≥1)=1−(512
为什么无放回会压低波动
把第 i 次抽中成功对象记为 Ii。由抽样对称性,各个位置都有 E(Ii)=K/N,所以
E(X)=nNK.
这一点和二项分布的 np 一样,均值还看不出独立性被破坏了。波动则不同。令 p=K/N,当 N>1 且 i=j 时,
P(Ii=1,Ij=1)=
它比 p2 少了 p(1−p)/(N−1),因此
E(IiIj)−E(I
后面会把这个差称为协方差;负号表示抽到一个成功后,会降低另一个位置抽到成功的条件概率。现在只需展开 X2=(I1+⋯+In),保留所有不同位置的乘积,就得到
Var(X)=np(1
最后一项叫有限总体修正因子。在 n≥1 时它不大于 1:只抽一个没有修正,抽得越多,相互限制越明显;抽完整个总体时,X=K 已经确定,方差降到 0。模块例子的均值为 5/3,方差为 70/99,小于独立二项模型的 。若 ,直接按确定的抽样结果求方差 ,不能把含 分母的公式硬代进去。
当总体远大于样本,不放回只轻微改变后续概率,二项分布可以成为近似。严谨的一种极限说法是:固定 n,让 N→∞ 且 K/N→p,超几何 PMF 就趋近 Binomial(n,p) 的 PMF。实际计算中, 小是一个有用提示,但“低于某个百分比就处处精确”不是定理,尤其不能据此保证极小尾概率的相对误差。
一个保守的检查方法是比较有放回抽样中是否重复抽到同一编号。重复概率至多为 (2n)/N;在没有重复时,可以把这次抽样和均匀不放回抽样配在一起。因此任一成功数事件的两种概率之差,都可用 min(1,(2n 这个上界控制。它有时很粗,却把“总体很大”翻译成了一个可计算的误差检查;上界不小时,只能说明这个保证不够好,不能据此断定近似必然很差。
固定窗口中的事件数,怎样得到泊松分布
最后换一种计数:记录十分钟内到达的请求数。这里通常没有预先列好的“总共试验 n 次”,我们看到的是一个时间窗口,和窗口里发生的一串事件。泊松分布常用来描述这种计数,但只知道平均每分钟几个请求,还不足以唯一确定分布。
先从已经理解的二项模型搭桥。假设有 n 个独立的小机会,每个成功概率为 pn=λ/n,令 Xn 为成功总数。随着 n 增大,机会越来越多,每次越来越不容易成功,而平均成功数 保持固定。对固定非负整数 ,
P(Xn=k)=(kn)
把它拆成三个容易看极限的部分:
P(Xn=k)=
其中有限乘积趋于 1,中间的幂趋于 e−λ,最后一项趋于 1。于是
P(Xn=k)⟶e−λk!
这便得到 X∼Poisson(λ) 的概率质量函数:
P(X=k)=e−λk!λ
它确实是一张完整概率表,因为
k=0∑∞e−λk!λ
λ=0 可以另定义为恒等于 0 的退化分布。λ 不必是整数,它表示窗口中的平均次数,和某次实际观察到的整数次数不是同一件事。
事件率与窗口平均数,别漏掉时间单位
若想把上述极限用于时间计数,需要明确模型条件。设 ρ 为恒定事件率,单位例如“次/分钟”。标准的齐次泊松计数模型要求:不相交时间段内的事件数相互独立;长度相同的时间段有相同分布;对长度为 h 的很短区间,
P(一次事件)=ρh+o(h),P(至少两次事件)=o(h).
这里 o(h)/h→0。这比说“同时发生多个事件的概率很小”更准确:区间缩短时,多次事件的概率还要比区间长度下降得更快。把长度为 t 的窗口不断细分,就接上了前面的许多小机会模型,窗口总计数服从参数
λ=ρt
的泊松分布。这里 ρ 是率,λ 是这个窗口的平均次数,二者不能不看单位地混用。
例如某计数模型的事件率是每分钟 0.6 次,观察五分钟,则 λ=3。五分钟没有事件的概率为 e−3≈0.0498;恰好两次的概率为
P(X=2)=e−32!32≈
至少两次可以通过补事件计算:
P(X≥2)=1−P(X=0)−P(X=1)=
这些数字是该模型及其假设下的结果。平均率为 0.6 本身不能推出它们:每到整点成批到达、某次事件触发后续事件,或把忙时和闲时混成一个窗口,都可能破坏上述条件。
均值等于方差,是可检验的特征
泊松分布的均值与方差都为 λ。不要仅凭“二项均值和方差的极限看起来如此”便当作证明,因为分布收敛一般不能自动交换期望。这里可以直接从 PMF 求和:
E(X)=k=1∑∞ke
同理,
E[X(X−1)]=λ2,Var(X)=λ
因此固定参数泊松模型的理论均值和方差相同。如果许多可比窗口的计数显示明显更大的离散程度,就应检查成批发生、相互影响、窗口之间率不同等机制。有限样本的均值和方差不必恰好相等,所以不能只凭一次数字不一致就宣布模型失败;反过来,二者碰巧接近也不能证明整个分布就是泊松分布。
稀有事件近似,到底近似在哪儿
若 X∼Binomial(n,p),常用 Poisson(np) 近似。当 n=200,p=0.005 时,,没有成功的精确概率为
P(X=0)=0.995200≈0.36696,
泊松近似为 e−1≈0.36788,相差约 0.00092。这是对某个具体事件检验近似,不能只看两条曲线“差不多”。
“n 大”本身不够。若 p=1/2,二项方差为 n/4,匹配均值的泊松方差为 n/2,两者波动明显不同。另一方面,二项计数最多为 n,泊松分布却会给所有非负整数分配概率;使用近似时,超过 n 的虚构尾部是否足够小,也属于应检查的误差。
如果问题需要可靠的尾概率,而二项 PMF 本来就能直接求和,应优先比较精确结果。不存在一个适用于所有事件和所有精度要求的“n 超过某数就一定能近似”的开关。本章证明的极限固定了 λ 和 k,实际参数下的精度还要针对所问事件判断。
等可能的有限取值,也要看清翻译规则
还有一种最简单的离散分布:从有限个数值中等可能选一个。若支持集是连续整数 a,a+1,…,b,其中 a≤b,共有 m=b−a+ 个值,那么的 PMF 为
P(X=k)=m1,k=a,a+
因为 m 个相等概率相加为 1,每项必为 1/m。对称位置两两配对可得
E(X)=2a+b.
令 J=X−a,它均匀取 0,1,…,m−1。利用整数求和与平方求和公式,
E(J)=2m−1,E(J2)
所以
Var(X)=Var(J)=12m2−1.
例如均匀抽取编号 3 到 9,共有七个编号,期望为 6,方差为 4。问编号至少为 7,符合要求的编号有 7,8,9 三个,概率是 3/7。公式里出现 ,正是因为两端编号都包括在内。
有限的等概率数值也可以不连续,但此时不能沿用连续整数的均值和方差公式。例如 0,1,10 各以 1/3 概率出现,均值为 11/3,并非两端平均 5。更不能从“原始结果等可能”直接推出“翻译后的取值等可能”:两枚公平骰子的 36 个有序结果等可能,点数和为 7 却有六个原始结果,点数和为 只有一个。
也不存在“在所有正整数中均匀随机选一个”的离散均匀分布。若每个正整数概率为同一个 c>0,总和会发散;若 c=0,可数可加性又让总和等于 0。有限均匀分布不能只把支持集无限延长,而让等概率性质原封不动保留下来。
把分布放回它们产生的问题里
走到这里,我们已经能把分布之间的关系读成试验规则的变化。伯努利是一次成败,二项是固定次数的成败相加;几何等第一次成功,负二项等第 r 次成功;超几何保留了“数成功”的任务,却改成有限总体不放回;泊松来自大量微小独立机会的计数极限。均匀分布则取决于有限数值本身确实等概率。
下面的调参器可以用来核对本章的概率表。先选择二项分布,把 n 固定,再改变 p,观察中心和偏斜怎样变化;再切到几何分布,减小 p,比较右尾和均值。柱上读数是理论 PMF,不是模拟频率。几何与泊松的支持集无限,画布只能显示有限范围,务必一起查看“图中总概率”和尾部说明,图外仍可能有概率。泊松滑块中的 λ 在这里按一个固定单位窗口的平均次数理解;更换实际观察窗口时,要先用 λ=ρt 换算。
这张表适合在理解之后核对,不能代替建模。一个问题如果只说“我们随机检查了一批产品”,仍需要明确是否放回、总体结构、检查方式以及各次是否相互影响。支持集可以帮你发现明显错误,却不能独自认定某个分布:许多完全不同的分布都可以取 0,1,2,…。
最稳的做法是先写一句完整的话:“X 表示什么,在什么规则下产生。”然后写出可能的数值范围,把目标事件表示成 X=k、X≤k 或 X>k,最后才计算概率。这样公式就有了明确的入口,也有了可以检查的边界。
练习:从机制走到概率
同一成功率,为何有不同的总数分布
一次随机选择决定某设备是否处于正常状态,正常概率为 0.7。设备正常时连续四次发送都成功,异常时四次都失败。令 Ii 表示第 i 次是否成功,X 表示总成功数。各 Ii 是什么分布? 是 吗?求 。
每个 Ii 都是 Bernoulli(0.7),但它们共享同一个设备状态,完全相关。总数只可能为 0 或 4,相应概率为 0.3 与 ,所以不是二项分布,且 。如果四次独立同概率,二项模型给出的结果才会是 。相同的单次概率不能决定总数的分布,试验之间的关系也参与了计算。
已经失败过,接下来的概率怎样算
每次尝试成功概率为 0.2,各次相互独立。令 T 表示首次成功所需的总次数。求 P(T≥4);在已知前三次都失败的条件下,求接下来两次内至少成功一次的概率。
T≥4 只要求前三次都失败,因此概率为 0.83=0.512。在前三次失败之后,未来试验仍是原来的独立同概率试验;接下来两次都失败的条件概率为 0.82,所以至少成功一次的条件概率为 1。这等于 ,对应剩余等待时间的无记忆性。不能把第二问写成 ,后者还包括前面三次已成功的结果,而题目已经排除了这些结果。
停止时刻和固定次数,怎样互相翻译
独立试验每次成功概率为 0.5,到第二次成功时停止。令 T2 为总试验次数,F2 为停止前的失败次数。求 P(T、 和 。
第五次必须成功,前四次恰好有一次成功,因此
P(T2=5)=(14)(0.5)失败对象不够时,支持集怎样改变
一盒十张卡片中有七张蓝卡、三张白卡。等可能地不放回抽出五张,令 X 为蓝卡数。写出支持集,求恰好三张蓝卡的概率,并求均值和方差。
白卡最多三张,抽五张就至少含两张蓝卡;蓝卡最多抽五张。因此支持集为 {2,3,4,5},并且
P(X=3)=泊松参数中藏着哪个窗口
假设某事件计数满足恒定率为每小时 2.4 次的齐次泊松模型。求半小时内没有事件以及至少两次事件的概率。若另一个系统只告诉你“平均每小时 2.4 次”,能直接使用同样答案吗?
半小时窗口的参数为 λ=2.4×0.5=1.2,所以没有事件的概率为
P(X=0)=e−1.2≈现在我们已经知道怎样把概率集中在一个个取值上,怎样靠求和回答事件问题。但有些模型里的测量值、寿命和误差不会集中到这样一张可数概率表中。下一章要继续问:如果每个单点都没有正概率,区间的概率从哪里来?我们仍然保留上一章的分布函数,只把这里“把点概率逐项加起来”的动作,换成对密度在区间上积分。